文丨卜晚乔
编辑丨张睿
2026年,AI圈里最热的关键词之一,是“记忆”。
记忆张量完成亿元级Pre-A轮融资,华为哈勃、荣耀战投、商汤国香联手投了进去;红熊AI 15个月内完成6轮融资,投后估值逼近30亿元;MemoraX AI三个月连融三轮,领投方从L2F光源创业者基金、钟鼎资本,到中金资本、达泰资本,再到北洋海棠基金、尚势资本、仁爱资本,阵容逐步扩大,老股东也持续加注。
据《2026中国智能体记忆市场规模研究报告》测算,中国智能体记忆市场从2025年的14.4亿元,增长至2030年的642.5亿元,五年复合增长率超过110%。到2030年,记忆在智能体基础设施中的占比将接近26%,成为仅次于基础模型的第二大独立市场。
但真正让这个赛道显得特殊的,不是钱,而是人。
这一轮投身AI记忆的人里,大部分是从基模一线退下来的技术负责人,他们原本在大厂里做的是基模本身。现在出来,做的是基模缺的那块能力。
MemoraX AI创始人郝建业就是其中之一。
MemoraX AI成立于2026年3月,落户深圳南山区。团队核心成员来自华为、阿里、腾讯等头部大厂,以及国内强化学习领域的顶尖研究力量。公司做的产品形态是,用后训练得到一个专门的记忆模型,与基模解耦。对开发者来说,只是多了一个可以调用的API;对用户来说,则是在几百轮对话之后,人物设定和剧情逻辑依然不乱。
离开华为前,郝建业担任华为决策推理实验室主任、大模型算法实验室主任、华为医疗军团技术总裁,还是华为决策智能方向首席专家。2019年到2025年,六年多时间里,他把强化学习从实验室推进到华为ICT产品线、终端、自动驾驶、芯片设计和供应链等多条业务线。同时,他一直在天津大学任教,学术和工业双线并行。
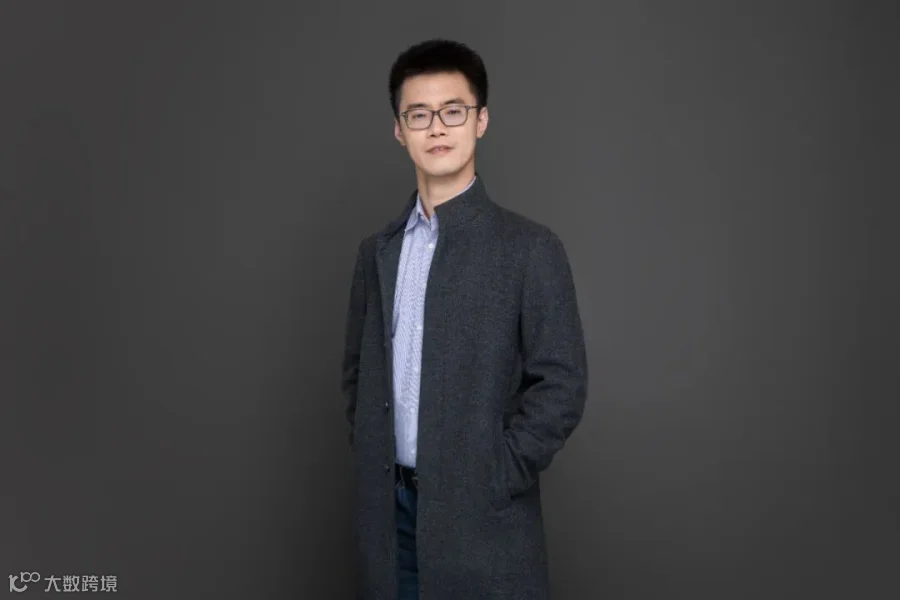
MemoraX AI创始人 郝建业
这样一个在华为负责决策智能方向前沿研究和产业落地的人,为什么选择出来创业?
他的答案是:基模之后,AI最缺的是记忆。
他说,过去几年,AI圈的主线是基模能力的scaling,大家关注的是模型在复杂单次推理上又突破了什么上限。如今,基模作为单次工具逐渐成熟,开始往千行百业落地,成为一个需要跟用户长期交互的助手时,记忆的缺陷就暴露出来了。“并不是说以前记忆这个问题不存在,而是技术发展的不同阶段,大家关注的重点不一样。”
那么,什么是记忆?郝建业打了一个比方:基模是AI的“通用大脑”,记忆模型就是给这个大脑配一个“长期记忆系统”。
但这个系统,不是让模型记住聊天窗口的上下文,也不是把更多历史信息塞进百万token的窗口。用RAG将历史信息重新翻找出来,只是解决了信息的存储与相似性召回。在他看来,真正的记忆是:什么值得记住,什么应该遗忘,什么时候更新,又应该在什么时候重新调用。
这套问题,郝建业并不陌生。
从香港中文大学博士阶段开始,他研究强化学习超过十年核心问题始终是:智能体如何在与环境持续交互的过程中,利用过去的经验,不断提升未来的决策能力。智能体与环境的每一次交互,都会产生一条经验——当前状态、执行的动作、获得的奖励、交互后的状态。经验回放的作用,就是把这些离散的交互片段结构化地存储下来,再通过采样和优化算法反复利用,让策略在迭代中不断逼近更优解。
智能体能不能越变越聪明,很大程度上取决于它能不能高效地组织和复用历史交互数据。正如2024年图灵奖得主、“强化学习之父”,阿尔伯塔大学计算机科学教授理查德·萨顿在今年的WAIC上提出的,AI过去主要从人类数据中学习,如今正在转向从智能体经验中学习:智能体与世界的互动、第一视角的经验、以及它的奖励、行为、观察。
在郝建业看来,基模之后,AI要真正走进千行百业,记忆不是可选项,而是必选项。
只不过,这一次他选择用创业的方式来做。
以下是亿邦AI与郝建业的对话节选:
亿邦AI:今年“记忆元年”这个说法,你是怎么理解的?
郝建业:我认为今年出现了一个显著变化,或者说,记忆之所以在今年受到更多关注,原因在于:过去几年,大家主要关注的还是基模本身能力的变化。基模确实在持续scaling,在复杂单次推理上不断突破上限。但今年大家发现,基模本身只是一个单次工具。它如何在千行百业落地,如何成为能与用户长期交互的助手?一旦进入长期交互,记忆问题、或者说基模在上下文管理上的缺陷,就充分暴露出来了。所以大家才觉得记忆会越来越重要。
这并不是说以前记忆问题不存在,而是技术发展到了不同阶段。早期大家关注当前最重要的事,当这个问题解决之后,就会关注到基模本身无法解决的那些能力问题。记忆元年的到来,本质上是因为基模能力成熟之后,行业开始进入长期交互和行业落地的新阶段。
亿邦AI:现在市面上大模型产品都开始在一定程度上具有记忆层、记忆调用能力,MemoraX AI怎么定义自己和它们的区别?
郝建业:可以从两个方面来看。首先,我们在这个赛道是做得最早、积累最深的团队之一。我们已经在多个权威评测中取得领先,比如在首届Agent Memory Leaderboard(AML)中,我们以58.02分位列商业产品榜第一,七项能力维度全部排名第一;在Coding Track上以62分排名第一;在LoCoMo-Refined上达到82.65%,在ScriptMem上达到60.3%,也都在受评系统中排名第一。这些结果表明我们在技术积累上确实处于领先位置。
其次,我们和基模公司的定位不冲突。我们是第三方,能够为千行百业中基模智能体用户提供记忆模型,而记忆模型本身承载的是产品和用户背后最核心的数据资产。基模公司做的是围绕自己基模的记忆模型来构建自己的闭环生态。当前基模生态百花齐放、竞争激烈,用户往往会同时使用多个基模和多个Agent。在这种情况下,一个中立、可迁移、跨模型的第三方记忆层,价值是不可替代的。
亿邦AI:公司3个月融了3轮,你觉得吸引资本的原因是什么?
郝建业:核心原因在于,资本市场和产业界正在对记忆赛道形成共识:记忆是整个AI基础设施里最后一个核心能力。很多人说今年是“记忆元年”,这个判断背后反映的是,基模能力逐渐成熟之后,行业开始意识到记忆是下一步必须补齐的短板。
另外,团队背景也是投资人认可的重要因素。我们是该赛道最早专注记忆模型的团队之一,并选择了原生模型内化的技术路线。与依赖规则系统和数据库管理的主流方案不同,我们的路线不依赖人工规则设计,其能力上限由数据驱动,能够随用户规模自然增长。通过持续积累用户数据,我们形成了数据飞轮,记忆模型的能力随之不断提升,进而形成正向循环。这构成了我们的技术壁垒。
亿邦AI:选择这条技术路径的底层逻辑是什么?
郝建业:底层逻辑就是第一性原理。过去几年,很多基于规则和启发式的AI解决方案,逐渐被基模替代。让模型自己学会解决问题,无论是能力上限还是泛化性,都优于传统方案。记忆也是同理,可以将其视为一个复杂的优化问题。如果仍然依赖人的经验规则和启发式方法来做记忆管理,最终必然会被数据驱动、可学习的方式所替代。
我们选择原生模型内化,本质上就是把记忆当作一个可训练的优化问题,而不是一个靠人工规则堆叠的工程问题。只有让模型自己从数据中学习“什么值得记、什么时候调用、如何更新”,记忆能力才可能真正scaling。
亿邦AI:你们的业务线是如何搭起来的?怎么把技术变成产品?
郝建业:我们现在有两条线。
第一条是面向C端的产品,主要做Coding和可交互式的泛娱乐类产品。Coding本身是基模目前跑得最成熟的赛道,像Codex、Claude Code这类编程工具,开发者在实际使用中确实面临一些痛点。所以我们先从最成熟、对记忆需求也最大的赛道入手。
同时,我们也在基于通用的记忆底座,和不同行业的客户合作,比如医疗类智能体、金融分析智能体、安全智能体,还有一些偏泛的个人陪伴类,以及智能终端硬件上的智能体。这些合作本质上都是把记忆模型作为一层能力输出,解决各行业智能体在长期交互中的记忆痛点。
亿邦AI:合作具体是什么样的?
郝建业:合作模式比较灵活,但核心都是把我们训练好的记忆模型作为一层能力输出,按token付费,跟基模的计费方式类似。目前我们已经在多个行业落地了这种合作。
比如在医疗领域,我们和一家做慢病管理的企业合作。他们的智能体每天和患者交流,产生大量关于用药、饮食、生活习惯的信息。我们的记忆模型帮助它把这些碎片化信息组织成持续更新的患者记忆,最终关键事件召回率达到92%,任务闭环率84%,重复追问下降了38%。
在金融领域,我们为一家金融科技平台的投研助手提供长期记忆能力,让AI能够记住研究员的研究框架、历史判断和偏好,支持个人和团队两级记忆。合作模式也是API接入,按token计费。
在智能终端方面,我们和智能穿戴、手机厂商合作,把记忆能力部署到端侧或云端,让设备能够持续记住用户偏好、事件和对话,实现更个性化的服务。比如AI眼镜和手机AI助手,都需要在保障隐私与端侧体验的前提下,形成对用户的长期理解。
另外,我们也在和云厂商合作,比如华为云、AWS、微软云,通过云市场把我们的记忆能力提供给更多企业客户,合作形式包括联合解决方案、云商店上架等。
总结一下,主要就是提供记忆模型API,按token付费,也可以根据客户需求做联合解决方案或私有化部署。合作的核心逻辑是一致的:把记忆层嵌入客户现有的智能体架构,帮助他们解决长期交互中的记忆问题。
亿邦AI:如果落地到一个具体的产品上,比如AI眼镜或者智能手表,从用户体验的角度来讲,他能有什么感受吗?
郝建业:一个直观的感受是,用户会发现设备越来越懂自己,不用每次重新交代背景。因为我们会对他过去很长一段时间内,通过智能硬件搜集的个人信息,做更好的整理、组织和利用,让智能体在跟用户交互时,能够提供更加个性化的服务。比如AI眼镜能记住你常去的地方、常用表达、偏好设置,主动提供更贴合的建议。
医疗也是类似。智能体每天和患者交流,会产生大量信息——用药、饮食、生活习惯等等。我们怎么根据他过去几周甚至几个月的信息,把它充分组织、利用起来,在未来给患者更科学、更合理的饮食或用药建议。这背后的核心,就是让记忆从“存下来”变成“用起来”。
亿邦AI:交互式娱乐场景一般指的都有哪些?
郝建业:这是一个比较新的方向,可能是未来比较有颠覆性、空间也很大的一种新型游戏体验。现在市面上比较多的是卡片人,跟一个角色做纯语音交互。
我们做的事,是在这个基础之上,让用户在一个沉浸式剧情里,作为主人公,在一条大的故事线下体验、闯关,同时可以实时改变剧情。因为我们的系统有一个强大的记忆引擎,能够根据用户的实时反馈去改变后续剧情。
现在主流的角色对话产品,还是单纯依赖基模的文本生成能力。所以往往会出现一个问题:用户交互轮次一多,模型就会降质,后面很难生成出有意义的、逻辑性强的对话。
我们因为有一个强大的记忆引擎,跟基模配合之后,就可以在更复杂的故事线下,包括多角色设定下,让用户有非常沉浸式的长周期交互体验。内测中我们发现,用户可以在几百轮甚至数千轮的交互下,依然愿意沉浸式地玩下去。这背后起作用的,就是记忆引擎对角色关系、剧情线索和用户偏好的持续维护。
亿邦AI:客户的付费形式是什么样的?
郝建业:C端一般就是订阅制,比如按一个基础的月费来收,里面包含一定的对话量或者token量。核心是让用户跟里面的角色建立粘性,形成一种羁绊效应,这样才能触发长期付费,甚至可以多次消费。
因为我们的记忆模型可以把用户跟角色的交互历史沉淀下来,让这个角色成为一个非常有灵魂的存在。而且这一能力可以独立提取,比如可以在不同的新剧本下再去体验——用户可以带着一个之前很熟悉的小伙伴,去一个新的剧本里再闯关。所以它不是单次消费,而是可以做二次、三次,甚至多次消费。
亿邦AI:记忆最终可以实现到什么程度?
郝建业:这个问题可能没有绝对答案。一方面,我们会关注记忆本身的中间指标,比如召回信息的正确性和覆盖度。但更重要的是,记忆召回的信息最终是为端到端的agent任务服务的。以Coding为例,召回的记忆能否帮助用户更好、更高效地完成当前任务,才是评价记忆好坏最重要的端到端指标。因此,在模型优化过程中,我们会将中间态指标和端到端任务指标结合起来,共同优化记忆模型。
换句话说,记忆能力没有孤立的上限,它的价值最终由它所服务的任务来定义。任务越复杂、周期越长,记忆的价值就越明显。
亿邦AI:AI记忆未来还有可能出现什么样的产品形态?你们有没有计划入局其他赛道?
郝建业:主要分为to C和to B两种方向。要么基于模型打造优秀的to C产品,直接触达用户;要么将模型做成通用能力,服务不同的to B场景,赋能各类智能体。不同公司会有不同的选择,或者在投入分配上有所差异。对我们来说,这两条线会并行推进,只是在不同阶段的侧重点会有所不同。
亿邦AI:那您觉得行业以后会朝什么方向发展?
郝建业:这个方向未来肯定会越来越重要。一方面是实际应用中的很多痛点,确实是基模缺失的能力。另一方面,现在大家都在讲RSI,也就是recursive self-improvement。它最核心的一点在于,基模相当于一个离线出厂的能力,那这个智能体在使用过程中,怎么实现能力的自我演进、自我提升?这里面最核心的一部分,与人类似。人从出厂设置到成长过程中各种能力的提升、技能的学习,也是靠大脑的计算智能和记忆智能紧密配合、协同,才实现了所谓的持续学习和自我提升。
记忆是RSI的关键基础。它让每次任务留下的不只是结果,还有可复用的经验:哪些方法有效、哪些路径失败、适用条件是什么。任务反馈又能反过来检验这些经验的价值,并更新记忆、训练记忆模型,形成“经验积累—任务改进—记忆进化”的闭环。没有记忆,每次任务都是孤立的,自我改进就无从谈起。