


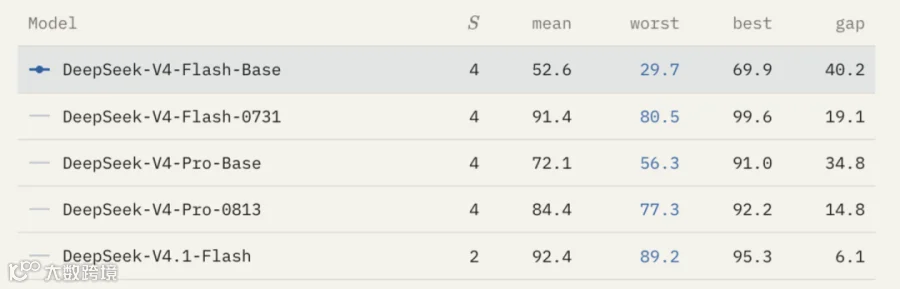
此前,字节 Seed 团队发布的论文《Periodic Weak Spots》发现,以 DeepSeek V4系列为代表的模型,压缩稀疏注意力机制下会出现「性能漂移」现象:同样的信息,仅仅改变在上下文中的位置,就可能让模型的表现出现周期性波动。
我们来聊聊「性能漂移」这次背后具体是什么。
因为原因不一,酱紫君只是说这次情况。

@酱紫君
我天,能不能别中译中,看了半天没看懂什么叫性能漂移,还以为是降智的学术化委婉说法。
总结一下就是 Deepseek V4 神鬼二象性的原因找到了,对齐了就是超神,进盲点就是超鬼。
在标准 Transformer 中,RoPE 点积满足相对平移对称性,当输入整体向前或向后平移时,相对注意力分布保持不变。
不会因为换一个 harness,开头说『你好』,多打一个空格之类乱七八糟的问题突然发癫。
但是 DeepSeek-V4 的初衷是用极低的显存和计算代价跑完超长上下文,于是就采用了分块压缩机制是,滑动窗口大小 𝑊 = 8 ,压缩步长 𝑆 = 4。
这就导致每个 Token 涌现出了一个隐式的物理量,相位 φ。
V4 架构每向前移动 4 个 token,就把包含 8 个 token 的局部窗口通过一个可学习的门控压缩层合并压成 1 条紧凑的 KV-Cache 向量,训练过程中会诱导出强势槽位和盲点槽位。
决定神/鬼表现的核心机制在于槽位增益因子。
若目标 Token 的相位恰好落在门控权重的高峰槽位,此时不仅目标 Token 的特征被近乎无损保留,而且还顺带压缩掉了其他无关 Token。
实际上起到了一种自然降噪的作用,检索准确率极高,表现甚至比 MLA 还好。
反之,当目标 Token 落在门控的死角槽位时,目标信息就会被同块内其他占据大权重的 Token 掩盖。
由于信息在物理层面未被存入 KV Cache,此时上层模型就算推理能力再强,面对已被抹平的底层表征也只能是巧妇难为无米之炊。
你非要我说点啥,那就只能根据自回归的局部统计概率凭空捏造,表现为胡言乱语。
DeepSeek 团队显然在后续版本中意识到了固定大步长带来的相位缺陷,并在 V4.1 中对架构做出了针对性调整。
接下来分析下到底哪个机制生效了。
Seed 团队为了排查到底是不是 RoPE 没做好,用 Qwen3-0.6B 作为底座从头做了多组的对照预训练:
把压缩模块里的 RoPE 完全移除,结果发现周期性弱点依然存在,这证明盲点不是位置编码带来的位置偏置。
接着去掉可学习门控,换成最简单、没有任何偏好的均匀平均池化,结果发现周期性弱点依然存在,这就说明与后天调参无关,是先天缺陷。
把压缩步长 𝑆 分别设为 4、6、8、12,不管你怎么换门控、怎么换结构,准确率波动的周期就会分毫不差地严格等于 4、6、8、12。
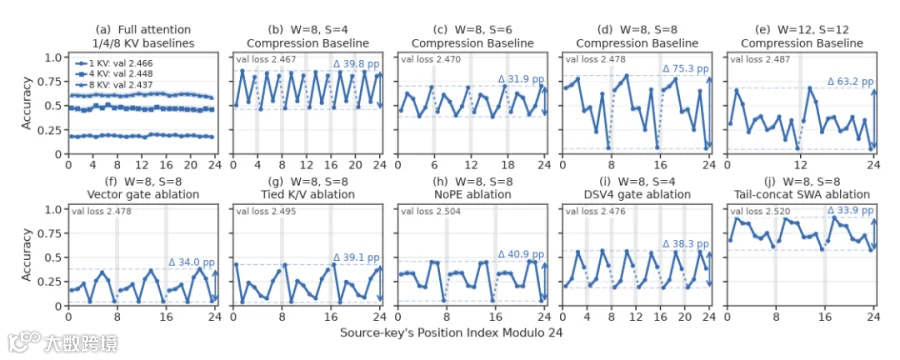
那么问题很明显了,只要你离散的定长切块,那么就必然打破序列平移对称性,存在一定的神鬼二象性问题。
DeepSeek 应该也发现了这点,所以步长直接腰斩。
当步长 𝑆 = 4 时,一个压缩周期内有 4 个槽位,头尾两端与中间的信息分配极不均匀,边缘槽位在两次滑动窗口中容易遭遇双重丢弃。
当步长缩窄到 𝑆 = 2 时,压缩粒度变得极细,仅仅是两两合并,信息在一个周期内的相对偏移只有 0 和 1。
对于诱导头来说,跨度只有 1 个 token 时,即便落在相对较弱的奇数位,其上下文也很难被彻底遗忘。
还有就是 V4.1-Flash 采用了 CED 架构,只在浅层进行信息粗筛压缩,深层 Decoder 阶段改变全局 KV 投影,最后再配合后训练拉升,问题得到显著缓解。

但这不是说神鬼二象性问题就这么解决了,只是不那么明显了。
任何固定步长、任何静态切块的方案,再怎么改门控、再怎么改后训练,都无法根除这一缺陷。
比较理想的方法就是引入 Content-aware Chunking,根据注意力权重动态决定压缩边界。
此时网格中不再存在固定的相位概念,那么相位差也就无从谈起了。
阅读更多
🤝 知乎 AI Researcher Club 招募:
知乎联合 10+ 家媒体、创投孵化合作伙伴发起「AI Researcher Club」共创计划,长期支持支持 AI 前沿研究者,让重要的研究被看见、被讨论,让研究者找到彼此,也让新的合作由此发生。点击了解 >> AI Researcher Club
🚀 知乎 AI 社群:
如果你对 AI 共识、AI 活动感兴趣,欢迎扫码加入知乎社群↓,我们将每周送上知乎 AI 周报,分享社区内的 AI 讨论与共识,并不定时送上 AI 各类活动报名。

知乎AI情报站
让一部分开发者先走起来
🚀 知乎科技账号 @ZhihuFrontier 正式登陆 X
👉🏻 https://www.zhihu.com/project-square,上传你的 Vibe Coding 项目,在知乎遇见更多可能。