


导读本文整理自浙江创邻科技有限公司高级算法工程师童冰在 Agentic AI Summit-2026-深圳站上的分享。讨论一个越来越重要的问题:当 Agent 不再只完成一次任务,而是长期服务一个用户、一类岗位甚至一个组织时,它怎样才能真正“越用越好”?答案离不开 Agent Memory。但 Memory 不是简单地“把历史都存起来”。它什么时候有用、应该记什么、怎样更新,以及如何避免错误经验被反复复用,都需要被系统评测和治理。EvoMemBench 正是围绕这些问题展开。
1. 当 Agent 开始长期工作,Memory 为什么会变重要?
2. Memory、长上下文和 RAG,不是一回事
3. 从“记得住”到“会进化”:Memory Benchmark 在测什么?
4. EvoMemBench:用两个维度,把“记忆进化”拆开测
5. 评测结果里,有五个值得特别注意的结论
6. 从 Benchmark 回到工程:Memory 应该怎么建?
分享嘉宾|童冰 浙江创邻科技有限公司 高级算法专家
编辑整理|徐彦超
内容校对|韩珊珊
出品社区|DataFun
一个 Agent, 第一次执行任务就能达到 85%,第 20 次、第 100 次仍然是 85%;另一个 Agent ,第一次只有 70%,但它能吸收反馈、更新知识与状态、复用有效经验,第 20 次达到 80%,第 100 次达到 91%。
如果只看一次任务,前者已经足够强。但如果 Agent 要长期工作,真正值得关注的就不只是“这一次做得怎么样”,而是“做过之后,下一次会不会更好”。
一次做对,是能力;做过之后能够变得更好,才是进化。Agent Memory 的价值,就在于把过去的交互、状态和经验,转化为后续任务可以继续利用的信息。
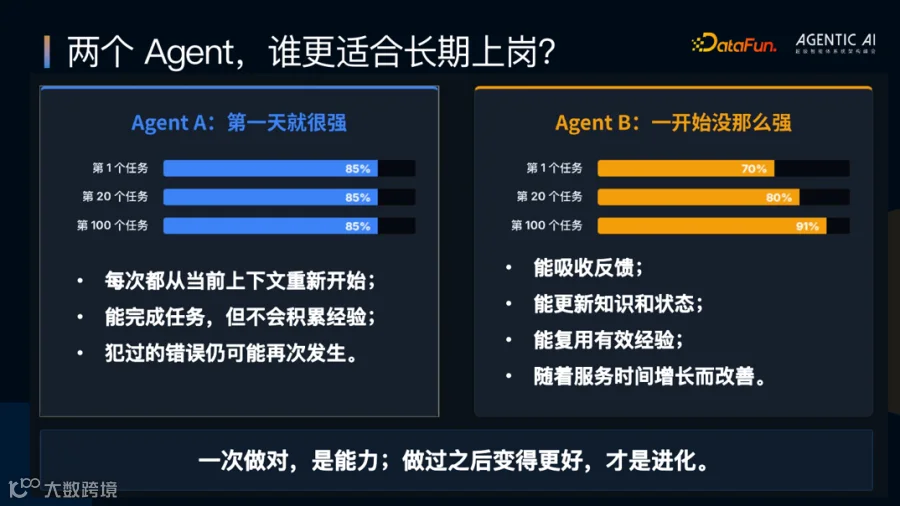
图:两个 Agent,谁更适合长期工作?
01
当 Agent 开始长期工作,Memory 为什么会变重要?
过去,我们更多把 AI 当作一次性交互工具:问一个问题、写一段内容、完成一个局部动作。这类 Copilot 的主要工作范围,基本都在当前对话里。
再往前一步,Task Agent 开始能够规划步骤、调用工具,并闭环完成一次任务。比如订一张机票、处理一笔退款、完成一次数据查询。它需要记住当前任务中的中间结果,但这些信息通常仍然围绕“一次任务”展开。
到了 Long-running Agent,情况就变了。它可能连续数周、数月服务同一个用户或业务流程。用户偏好、业务状态、组织规则、历史决策和执行经验,不可能每次都从零获取。服务时间越长,Memory 就越难只被当成一个“加分项”,而会逐渐变成基础能力。
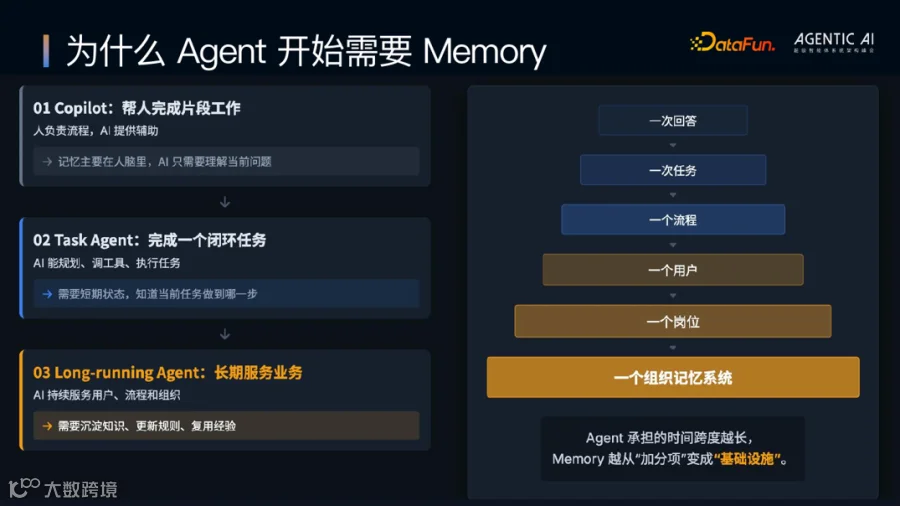
图:Agent 从一次性交互走向长期服务,Memory 的重要性随之上升
但这里最容易产生一个误区:有长上下文、有 RAG,不就已经“记住”了吗?
并不是。
02
Memory、长上下文和 RAG,不是一回事
可以用一句话区分三者:长上下文解决“刚刚发生了什么”,RAG 解决“外部资料怎么说”,Memory 解决“以后还要用什么”。
长上下文主要承载当前对话、工具结果和中间步骤,服务的是眼前这次任务;RAG 面向文档、知识库和外部资料,目标是按需找到当前有效的信息;Memory 则保存用户偏好、业务状态和历史经验,并且需要跨会话、跨任务持续使用,还要随着交互不断写入、更新和失效。
比如用户说:“帮我退掉刚才那笔海外订单。”
长上下文要回答的是:“刚才那笔”到底是哪一单?前面已经做过哪些工具调用?
RAG 要查询的是:当前有效的跨境退款政策、审批规则和合规要求是什么?
Memory 则可能提供:这个客户长期以来偏好的处理方式是什么?他当前是否处在某种合规审查状态?这次退款过程中形成的经验,未来是否值得继续复用?
所以三者不是替代关系,而是协作关系。

图:长上下文、RAG 与 Agent Memory 的职责差异
真正建设 Memory 时,可以把问题拆成四个层次:记什么、记成什么、给谁用、如何治理。
“记什么”包括用户偏好、业务规则、工具结果和任务状态;“记成什么”可以是摘要、表格、向量、图、流程或技能等不同形态;“给谁用”决定了这段记忆记忆可能只服务当前任务、某个用户、某类业务,还是整个 Agent 团队;“如何治理”则涉及来源、版本、权限、失效、删除和安全。
换句话说,Memory 的难点从来不是“能不能存下来”,而是:什么值得记?怎样更新?什么时候调用?什么时候必须让它失效?

图:理解 Agent Memory 的四个问题
这也直接改变了我们应该怎样评测 Agent Memory。
03
从“记得住”到“会进化”:Memory Benchmark 在测什么?
早期的 Memory Benchmark,最常测的是事实召回:过去说过什么,现在还能不能找回来。
但长期 Agent 需要的显然不止这些。
如果用户昨天说“出差喜欢靠窗”,今天因为腿受伤改成“靠过道”,系统不能只证明自己还记得昨天的偏好;它还必须知道,今天哪个信息才是当前有效状态。
如果 Agent 已经执行到机票预订的第三步,记忆也不能只保存几句话,而要准确保留“选的是哪一个航班、乘机人是谁、哪些参数已经确定、下一步要做什么”。
再进一步,一次任务里的有效经验还应该能迁移到后续任务。例如某类 API 的调用顺序、某类搜索任务的来源选择方式、某类操作流程中的检查步骤,都可能成为可复用经验。
因此,Memory Benchmark 的评测目标其实在不断升级:从事实检索,到纠错更新;从带着记忆做事,到复盘经验;再到主动学习,以及长期使用下的成本、延迟、删除、隐私和污染防御。
可以把这条演进理解成一句话:Memory 评测正在从“记住”走向“行动”,最终走向“持续学习”。


图:Memory Benchmark 从“记住”走向“持续学习”
04
EvoMemBench:用两个维度,把“记忆进化”拆开测
现有 Benchmark 的一个问题是,常常把不同能力拆开来测:有的只看知识记忆,有的只看执行状态;有的只测任务内,有的只测跨任务。不同测试使用的模型、上下文预算和更新机制又不一致,结果很难直接横向比较。
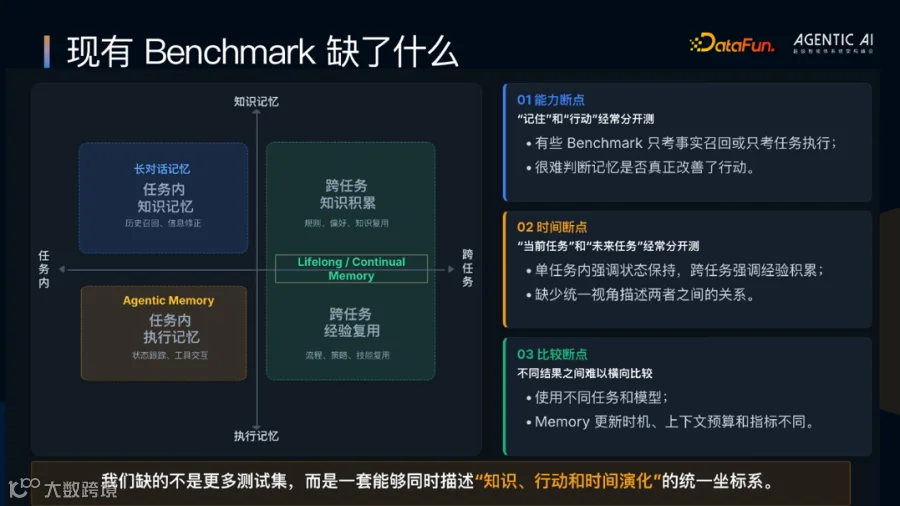
图:Memory Benchmark 的四象限需求
为此,浙江创邻科技与香港科技大学(广州)联合研发 EvoMemBench,希望用统一框架描述 Agent Memory 的多种演化能力。
EvoMemBench 用两条轴组织 Memory:第一条轴区分“任务内”和“跨任务”;第二条轴区分“知识”和“执行”。两两组合后形成四个象限。
第一个象限,是任务内知识演化(INEP-KNOW):重点看“记住并修正信息”。这里最关键的两个能力是 Retention 和 Revision。Retention 是能不能把历史找回来;Revision 是面对新旧冲突时,能不能判断哪个状态已经过期、哪个状态当前有效。
第二个象限,是任务内执行演化(INEP-EXEC):重点看“跟踪执行状态”。例如机票预订中,“选第二个”“还是刚才那个乘机人”“把刚才订单改到周二”,这些指令都依赖前面的实体、参数和中间状态。执行记忆最怕的不是少记一句话,而是把关键实体或步骤状态弄丢。
第三个象限,是跨任务知识演化(CROSSEP-KNOW):重点看“积累并重组可复用知识”。例如企业差旅规则可能在不同任务中分别出现,后续需要被组合成新的判断;当统一规则更新后,旧结论也应该被正确替换,而不是让多个冲突版本同时生效。
第四个象限,是跨任务执行演化(CROSSEP-EXEC):重点看“复用执行经验”。EvoMemBench 又把它拆成 Tool Using、Web Search 和 Embodied AI。工具调用更容易复用 API、参数模式和前置条件;Web Search 更强调来源选择与交叉验证;具身任务则受物体位置、动作前提和环境条件影响,过去有效的操作未必能直接搬到新环境。
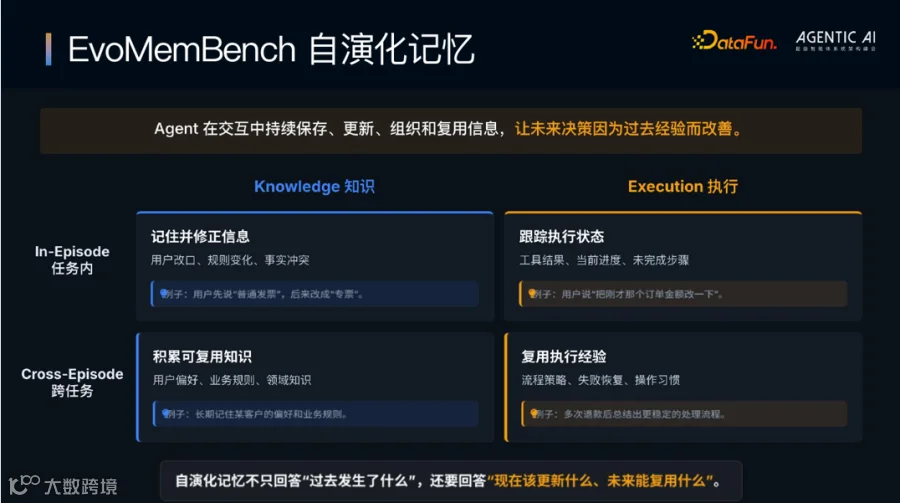
图:EvoMemBench 的四象限设计
最终 EvoMemBench 包含 4 种演化能力、6 个 Benchmark:INEP-KNOW 2800 个样本、INEP-EXEC 800 个、CROSSEP-KNOW 884 个、CROSSEP-TOOL 800 个、CROSSEP-WEB 270 个、CROSSEP-EMB 200 个,总计约 5.8K 个评测样本。
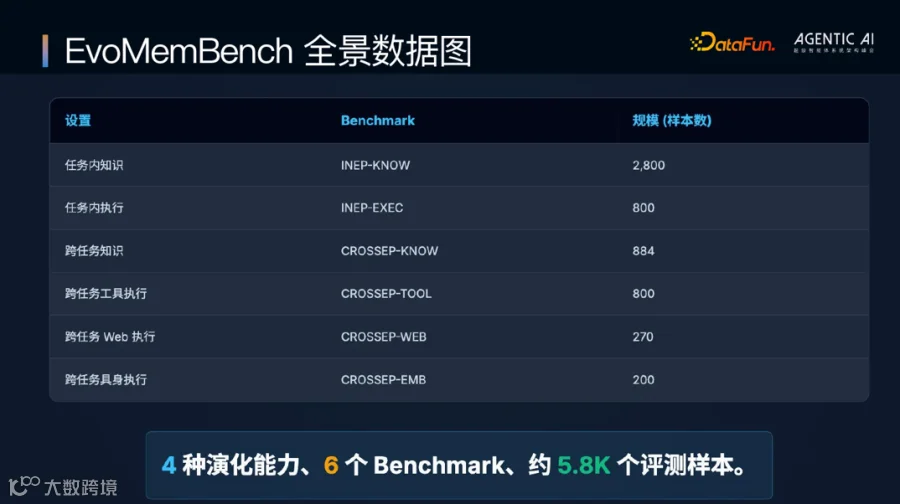
05
评测结果里,有五个值得特别注意的结论
结论一:历史放得下时,Memory 不一定比“直接读原文”更好。
在任务内知识演化里,当历史能够完整放进上下文时,直接读原文反而更强。Gemini-3-Flash 直接读原文,在 Event QA、FC-MH 和 FC-SH 上分别达到 98.2、58.0、96.0;对应表现最好的外部 Memory 分别为 91.2、7.0、54.0。

图:历史可完整放入上下文时,外部 Memory 不一定更强
原因并不复杂:外部 Memory 要经历抽取、存储、召回、再拼接回上下文。每增加一层处理,都可能损失信息,也可能带来噪声。因此,“用了 Memory”本身并不是价值,只有当它弥补了模型和上下文的能力缺口时,才有价值
结论二:题越难,Memory 越可能真正发挥作用。
在测试的 13 种 Memory 方法中,简单题没有任何一种超过 Baseline,0/13,平均变化为-6.09;中等题有 6/13 超过 Baseline,平均变化 +0.32;困难题则是 13/13 全部超过 Baseline,平均提升 +7.12。
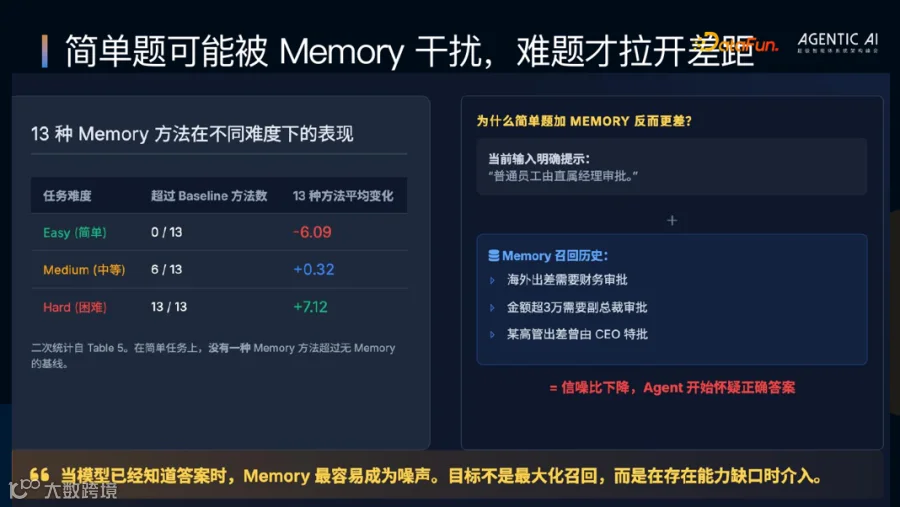
图:任务越难,Memory 的增益越明显
这说明 Memory 不是越多越好。一个问题本来只需要一条明确规则,如果系统又召回海外审批、大额审批、高管特批等一大堆历史信息,反而可能让 Agent 对已经正确的答案产生犹豫。
所以更合理的目标不是“最大化召回”,而是“在能力真正有缺口的地方补上关键信息”。
结论三:在长流程执行中,Memory 的价值更容易显现。
执行状态与知识问答不同。上下文越短,前面的工具结果和中间状态越容易被截断,这时 Memory 保存“已经做到哪一步、关键参数是什么、下一步应该做什么”的价值会更明显。
在16K、32K、64K、128K 四种上下文设置下,超过无 Memory Baseline 的方法数分别为 11/15、11/15、12/15、9/15。

图:上下文受限时,Memory 更容易补齐执行状态
因此,“要不要 Memory”不能抽象地回答,必须放回具体任务、历史长度和上下文预算中判断。
结论四:能找回旧信息,不等于能更新旧结论。
这是整个评测中最值得警惕的一点。Retention 的平均表现为 51.6%,而 Revision 只有 18.1%。
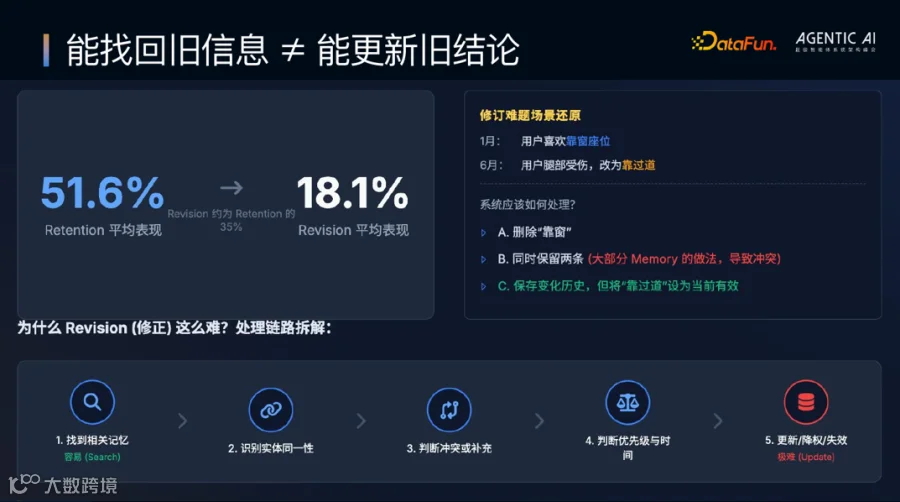
图:能找回信息,不等于能完成修正
Revision 不是简单地用新信息覆盖旧信息。它至少需要完成一条链路:先检索相关历史,再判断是不是同一实体,识别新旧信息是否冲突,判断哪个版本优先,最后执行更新、降权或失效。
任何一步出错,都可能出现一种很典型的问题:系统把旧信息找得很准,但给出的“当前状态”依然是错的。
这说明真正的长期记忆系统,Add 和 Search 远远不够,Update、Invalidate,甚至必要时的 Rollback,都应该是一等能力。
结论五:不存在一种 Memory,适合所有任务。
不同任务偏好的记忆形态并不相同。按 Average Rank 比较,数值越低越好:检索型 Memory 在 Tool Using 中表现最好,为 5.43;通用长期 Memory 在 Web Search 中最好,为 5.38;程序性 Memory 在具身任务中最好,为 5.60。

图:不同任务需要匹配不同类型的 Memory
经验迁移同样如此。Tool Using 更容易出现正迁移,因为检查状态、选择下一次调用、验证最终结果等决策步骤经常可以复用;具身任务则更容易出现正负迁移混杂,因为环境、物体位置和动作前提可能已经改变。
真正值得迁移的,不是“上一次具体做了哪几步”,而是“这类任务应该怎样做决策”,以及这套经验在什么环境、什么前置条件下成立。

图:迁移的关键不是复制步骤,而是复用决策过程与适用条件
06
从 Benchmark 回到工程:Memory 应该怎么建?
从这些结果出发,可以总结出五条更实用的建设原则。
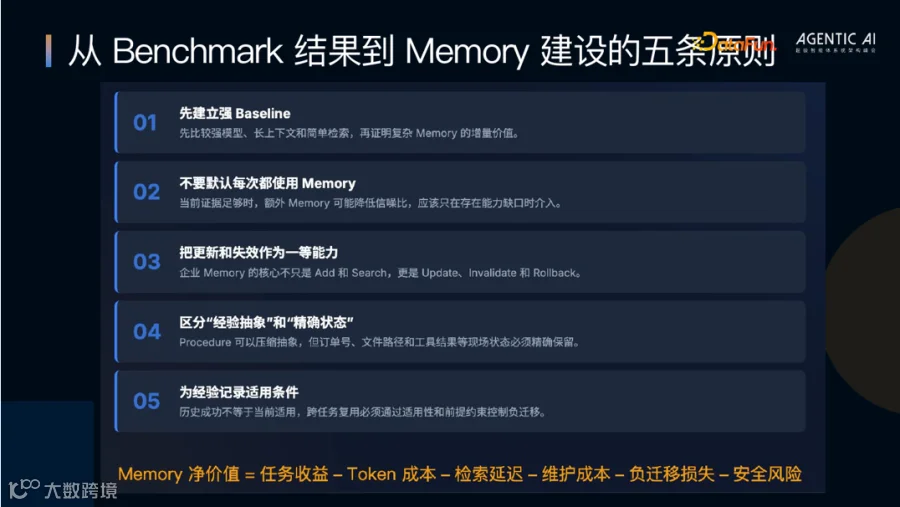
图:从 Benchmark 结果到 Memory 建设原则
第一,先建立足够强的 Baseline。先用长上下文和简单检索验证:没有复杂 Memory 时,任务已经能做到什么程度?只有确认 Memory 带来了真实增益,才值得增加系统复杂度。
第二,不要默认每个任务都调用 Memory。Memory 应该在模型能力或上下文预算出现缺口时介入,而不是把“检索历史”变成每个任务的固定动作。
第三,把“更新”当成核心能力,而不只是“存储”和“搜索”。Update、Invalidate,以及必要时的 Rollback,决定了系统能不能维护正确的当前状态。
第四,区分“经验抽象”和“精确状态”。流程、偏好、决策模式可以被抽象;订单号、文件路径、具体实体参数等关键状态则必须精确保存。两类信息不能用同一种方式粗暴处理。
第五,给每条可复用经验记录适用条件。尤其是执行经验,必须把环境配置、前置约束和生效范围一起保存,否则一次成功经验很容易在另一个环境里变成负迁移。
最后,还要算一笔“总账”。
Memory 的价值不能只看准确率,可以把它理解为:
Memory 净价值 = 任务收益 - Token 成本 - 检索延迟 -维护成本 - 负迁移损失 - 安全风险。
这条公式背后其实是一种更务实的判断:长期 Agent 需要的,不是一个无限增长的历史仓库,而是一套能够持续判断“什么值得留下、什么已经过期、什么条件下可以复用”的记忆机制。
结语:真正的“记忆”,不是存得多,而是下一次做得更好
当 Agent 只完成一次任务时,我们很容易只看“这次有没有做对”。但当它开始长期服务一个人、一类岗位甚至一个组织,评价标准就必须改变:它能不能从过去的交互中吸收有效信息?能不能在规则变化后及时修正?能不能把一次成功经验迁移到下一次,又避免把错误经验复制过去?
这也是 Agent Memory 真正的边界。
记忆不是为了让 Agent 拥有更多历史,而是为了让它在下一次面对问题时,拥有更好的判断、更准确的状态和更合适的行动。
一次做对,是能力;做过之后能够变得更好,才是进化。
关于创邻科技
创邻科技是国家级图数据库与图智能领域专精特新小巨人企业,具备一支由国家领军人才、国内外名校博硕组成的高精尖研发团队,深耕企业数据智联平台建设,拥有强大的技术研发、解决方案定制和项目实施服务能力,致力于推进客户数智化升级、激发数据要素活力、增益数据资产价值。
产品体系包括图数据库 Galaxybase、图智能平台 Graph Intelligence,以及 AI 方向的 GraphRAG / HybridRAG、GraphoraX 企业 AI 大脑和行业智能体。在这套体系中,Memory 作为企业级 Agent 系统的一部分,用于承接长期任务中的状态、经验与复用需求。
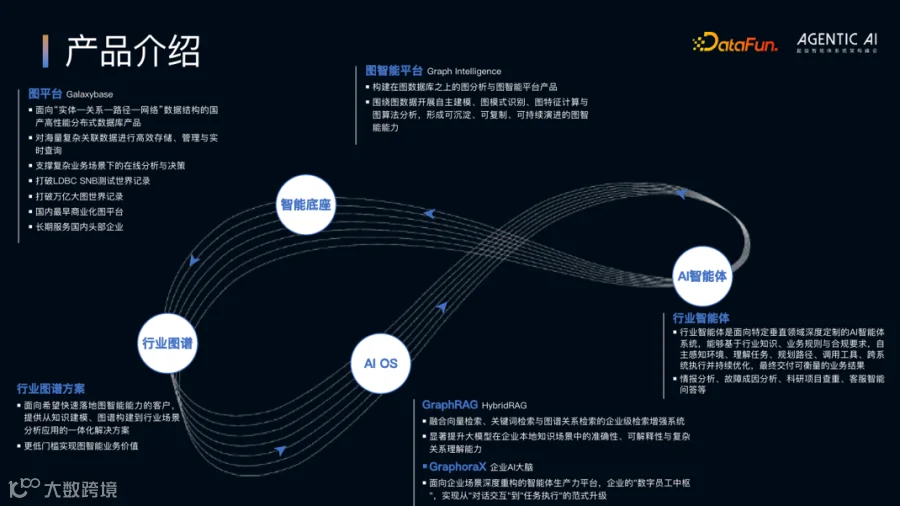
图:创邻科技企业 AI 产品体系
分享嘉宾
INTRODUCTION
童冰
浙江创邻科技有限公司
高级算法专家
创邻科技图技术和图算法专家, 在分布式图存储与图计算领域拥有近 10 年的研究与实践经验, 曾主导并参与 LDBC 图基准测试标准制定。 ⽬前主要关注 Graph4AI 与 AI4Graph ⽅向, 并在相关科研与落地实践⽅⾯拥有丰富的经验。 参与编写图数据库相关书籍、 ⽩⽪书及⾏业标准, 在 VLDB、 ICDE 等数据库顶会上发表多篇⽂章, 并荣获 2025 VLDB 最佳论⽂提名奖。
往期推荐
AI Agent进入生产后,如何做到可观测、可评估、可运营?
98.5% 自动审核、0.003% 欺诈率:金融 Agent 的真实水位
Agent 评测没有统一标准——美团、高德、科锐国际各走各路,该学谁?
从 BI 到 Agentic BI:让数据应用从展示走向受控行动
中国第一批啃下语义层的企业,这次集体开口
Harness Engineering 的语义底座:本体驱动的 Agent 可控执行
Semantic Layer不够了,Google开始给Agent补“业务关系”
腾讯金融合规 Agent 实战:32B 小模型、Skill 化规则与双轨自进化
百家企业语义建设思考:下一站是业务本体,AI从“秀操作”到“跑通业务”
OpenAI发现Agent会给“下一任自己”留后门:Compaction成了新攻击面

点个在看你最好看
SPRING HAS ARRIVED
