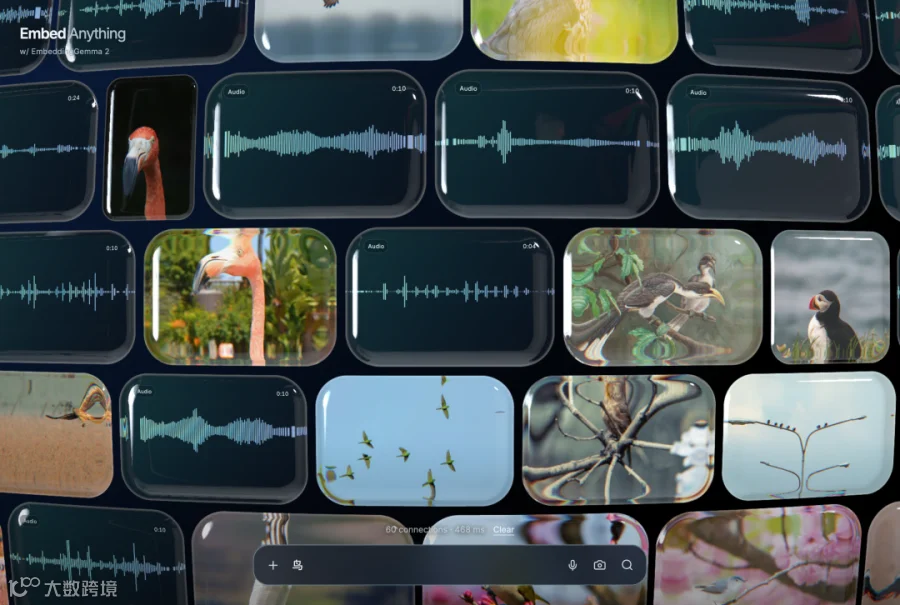
手机相册中堆积如山的照片终于迎来了高效的本地搜索方案。谷歌近日开源了全模态嵌入模型 EmbeddingGemma 2,支持在本地设备对照片、截图、视频及音频进行离线检索。该模型在仅执行文字搜索时,内存占用仅为 191MB,被网友评价为“比微信缓存更小”。
经中文环境实测,EmbeddingGemma 2 在视觉识别方面表现优异,能精准从截图中提取取件码等关键信息;但在中文音频理解上仍有提升空间,准确率略低于英文环境。总体而言,该模型呈现出“视觉敏锐,听觉尚需优化”的特点。
技术原理与核心优势
嵌入模型虽不如生成式大模型知名,却是搜索引擎、推荐系统及 AI 知识库(RAG)的核心基础设施。其工作原理是将内容转化为向量坐标,语义相近的内容在向量空间中距离更近。以往的多模态搜索通常需先将图片转文字、录音转文本,而 EmbeddingGemma 2 实现了文字、代码、图像、视频和音频在同一向量空间的直接映射。例如,搜索“火烈鸟”,相关的图片、视频及解释性文本均能被同时召回。
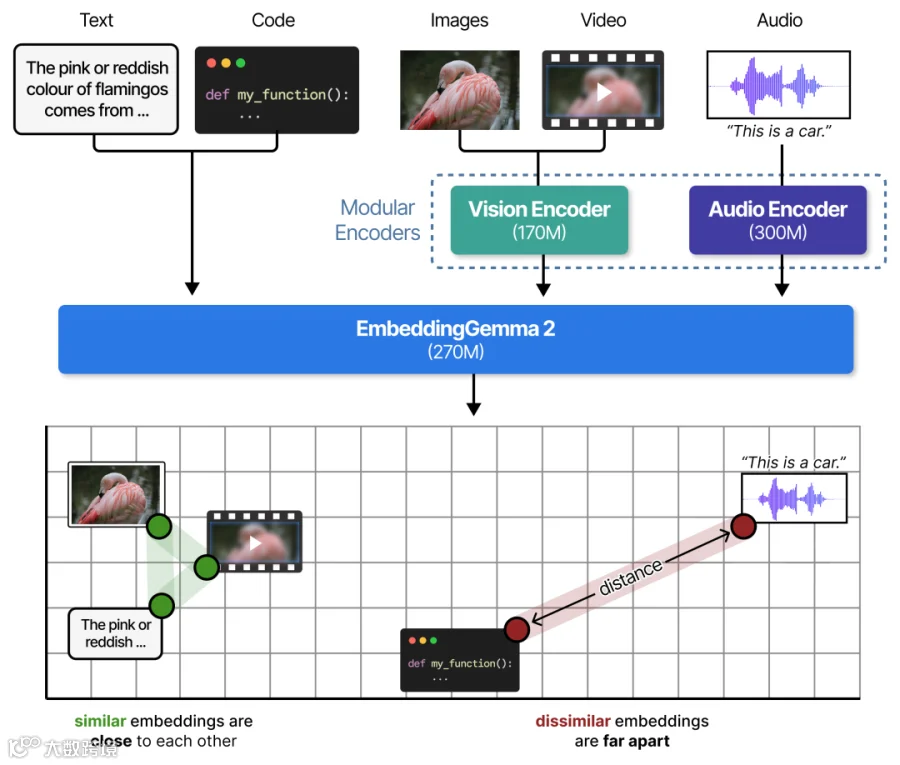
该模型总参数量为 7.4 亿,采用模块化设计:文字部分 2.7 亿参数,视觉部分 1.7 亿参数,音频部分 3 亿参数。用户可根据需求加载相应模块。在谷歌 Pixel 11 Pro 手机上,仅加载文字模块时内存占用 191MB,全量加载也仅需 567MB。
EmbeddingGemma 2 基于 Apache 2.0 许可证开源,允许免费商用。其底层技术与谷歌云端的 Gemini Embedding 一致,但后者需按量付费且依赖云端接口,而 EmbeddingGemma 2 可完全本地化部署,被视为免费的轻量级替代方案。
中文场景实测表现
在配备 Intel CPU 的 MacBook Pro 上进行本地部署测试,素材包含 24 张照片(涵盖火锅、长城、熊猫等常见场景)及 8 张应用截图(高铁票、外卖单、体检报告等)。
图文搜索准确率较高
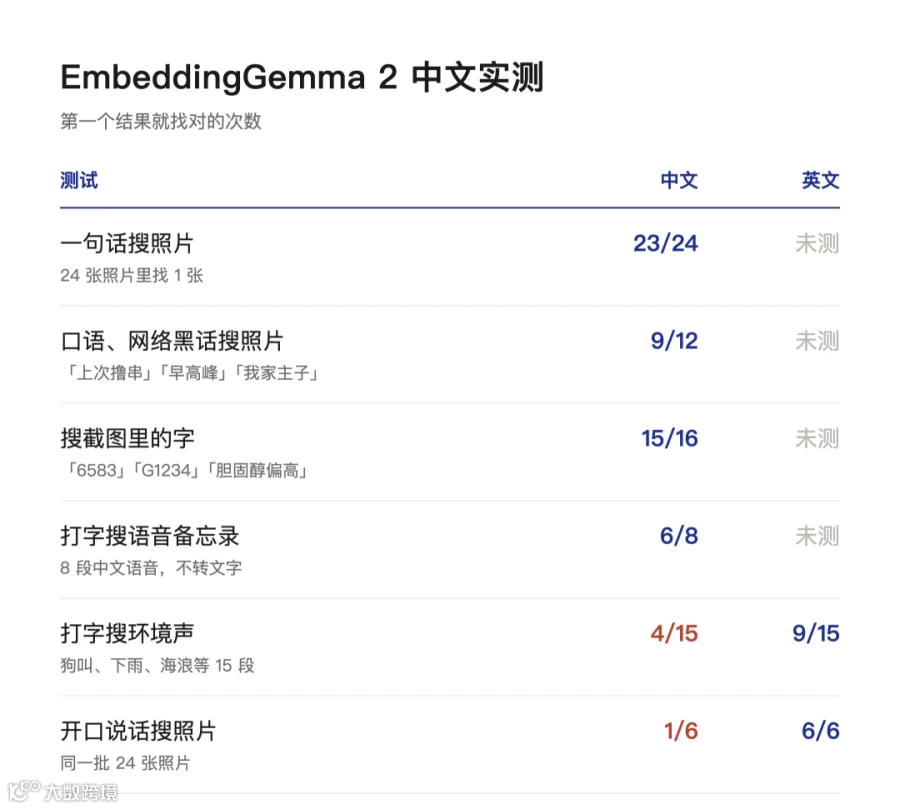
使用中文描述搜索照片,24 次测试中 23 次首条结果正确。模型对口语化表达具备良好理解力,如搜索“我家主子在电脑上睡着了”可准确匹配到趴在键盘上的猫,“早高峰”可匹配至拥挤的地铁车厢。但也存在少量误判,如将“国宝”误认为长城,“国粹”误认为舞狮。
在截图搜索场景中表现尤为突出。16 次针对混合素材的搜索中,15 次首条结果正确。模型能精准通过“G1234”定位高铁票,通过“胆固醇偏高”找到体检报告,甚至能通过“香山爬山”检索到相关群聊截图。

音频检索中文稍弱
模型支持直接检索语音备忘录,无需预先转录文本。在测试 8 段合成中文语音时,针对“房租”、“取件码”等问题的检索准确率为 75%(6/8)。在环境音识别测试中,使用英文描述搜索 15 段音频(狗叫、雨声等)的正确率为 60%,而切换为中文描述后正确率降至约 26%。这表明其在中文音频语义理解上仍逊于英文环境。
在处理速度方面,得益于轻量化设计,M5 Pro 芯片的 MacBook Pro 使用 CPU 处理单张图片仅需 0.15 秒,Pixel 11 Pro XL 使用 NPU 则仅需 0.05 秒。
性能对比与竞品分析
在同体量模型中,EmbeddingGemma 2 展现出较强的竞争力:
- 代码检索:仅调用文字模块即可获得 78.68 分,显著高于上一代的 68.76 分,并超越阿里 Qwen3-Embedding-0.6B 的 75.41 分。
- 纯文本检索:综合得分 61.36,与上一代基本持平。
- 音频检索:表现略逊于 Jina AI 的 jina-embeddings-v5-omni-nano,但后者采用非商用许可。
目前在 10 亿参数以内、支持全模态且允许免费商用的开源嵌入模型中,EmbeddingGemma 2 具有独特优势。

体验与部署方式
移动端体验
用户可通过谷歌官方应用 Google AI Edge Gallery 体验该模型。新增的“即时媒体搜索”功能支持实时图文检索,“视频时刻查找”功能可根据描述定位本地视频中的具体时间点。所有计算均在本地完成,完全免费。
网页与本地部署
无需安装应用的用户,可通过 Hugging Face 在线演示页面体验,输入关键词即可快速检索图像。开发者或高级用户推荐使用 Ollama 进行本地部署,执行命令 ollama pull embeddinggemma-2 即可下载模型。