


数据中心网络的演进核心,已不再单纯追求端口速率的提升,而是致力于将内存访问、GPU发包及集合计算从主机CPU的关键路径中剥离。
即便单台大模型服务器性能卓越,集群训练仍受限于参数、梯度和中间结果的传输延迟。据统计,2026年6月Top500榜单中,58.2%的系统采用InfiniBand互连,高性能互连已成为大规模计算的基石。当前的竞争焦点在于数据从内存至网卡、从GPU至交换机的全链路效率,旨在最小化CPU占用、减少数据拷贝次数及降低等待通知的开销。
RDMA:优化主机侧数据传输路径
传统网络通信中,应用数据需经由操作系统协议栈,CPU深度参与收发与缓冲处理。面对海量数据和高频通信,不仅消耗线缆带宽,更导致主机侧频繁的上下文切换和数据搬运。
RDMA(远程直接内存访问)的核心思路是预先将通信内存区域注册给网卡。虽然注册阶段仍需内核进行虚拟地址到物理内存的映射及权限授权,但准备完成后,发起端提交工作请求,网卡即可直接将数据写入远端已授权的内存位置。此举使接收端处理器彻底退出数据传输的关键路径。
通过RDMA,两端主机的网卡直接与各自内存交互。发起端处理器仅负责提交请求和读取完成状态,远端处理器无需介入数据的接收、匹配和落位。这并非消除CPU的作用,而是将数据面的逐次参与转变为预配置后的硬件自动化传输。

RDMA的实施并非零成本,需前置完成内存注册、地址映射、权限控制和队列管理。其核心价值在于,在长时间、高频率的数据交换场景中,避免了数据反复穿越内核和远端CPU。对于GPU集群而言,减少一次中转即意味着缩短整批计算的等待时间。
GPU Direct:移除CPU作为通信“代理人”
GPU训练涉及持续的小粒度通信。在传统路径中,CPU代理线程需通知网卡、启动传输并轮询进度,导致GPU计算期间CPU仍需为网络事务分配周期。这种代理机制延长了传输启动时间,限制了网卡有效吞吐率的发挥。
GPU-Direct RDMA允许网卡直接读写GPU显存,避免数据回绕至主机内存。进阶技术GPUDirect Async (IBGDA)进一步将控制路径向GPU侧迁移:GPU流式多处理器可直接更新网卡的doorbell记录、发起传输并查询进度,CPU不再处于关键控制链路中。核心目标在于确保计算任务不因等待CPU代发网络指令而停滞。
对比CPU代理式通信与GPU直接控制NIC的模式,后者在通信发起、进度查询和完成确认环节均避开了CPU这一中间人,显著降低了协调开销。
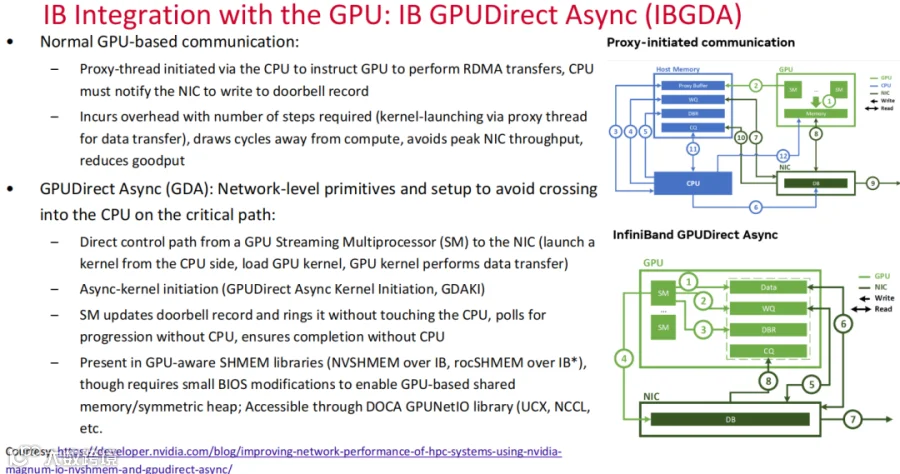
该能力的落地依赖GPU感知通信库及特定的软硬件环境,部分场景需调整BIOS设置。因此,仅采购支持GPU Direct的网卡并不足以自动降低通信开销,还需综合验证驱动、MPI/NCCL通信栈以及GPU与网卡的拓扑结构。
In-Network Computing:交换机参与集合通信规约
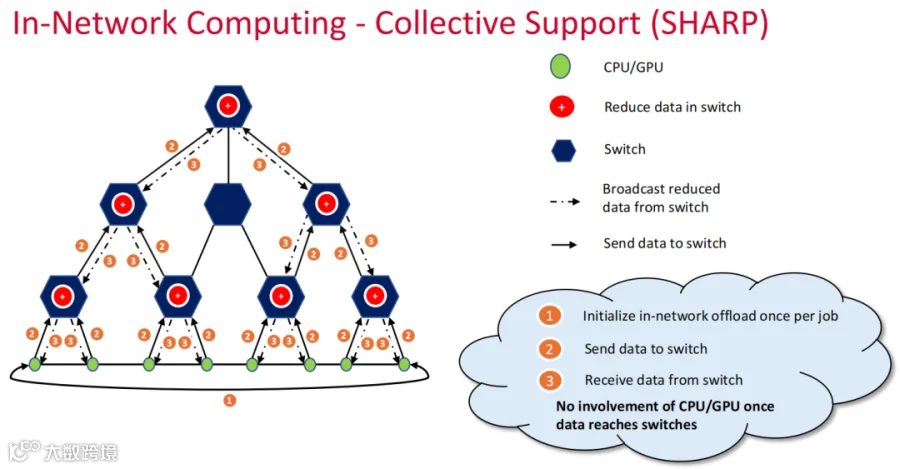
当成千上万张GPU执行AllReduce等集合通信时,瓶颈从“发包主体”转移至“中间结果合并”。若网络设备仅负责转发,部分结果需沿网络反复汇集再广播。单纯提升端口速率无法改变这种低效的通信模式。
以SHARP为代表的网内计算(In-Network Computing)技术,允许交换机在数据到达后直接执行规约操作(如求和),随后广播规约结果。作业初始化后,CPU或GPU将数据送入交换机,规约和广播过程在网络内部完成。这并非替代GPU计算,而是将集合通信中固有的简单操作卸载至数据经过的网络节点。
在树状网络中,数据上传至交换机后,具备计算能力的交换机逐层完成求和操作并下发结果。在此过程中,CPU和GPU不再参与规约阶段,凸显了AI网络对集合通信卸载能力的重视。
SmartNIC与DPU:网络侧的任务执行单元
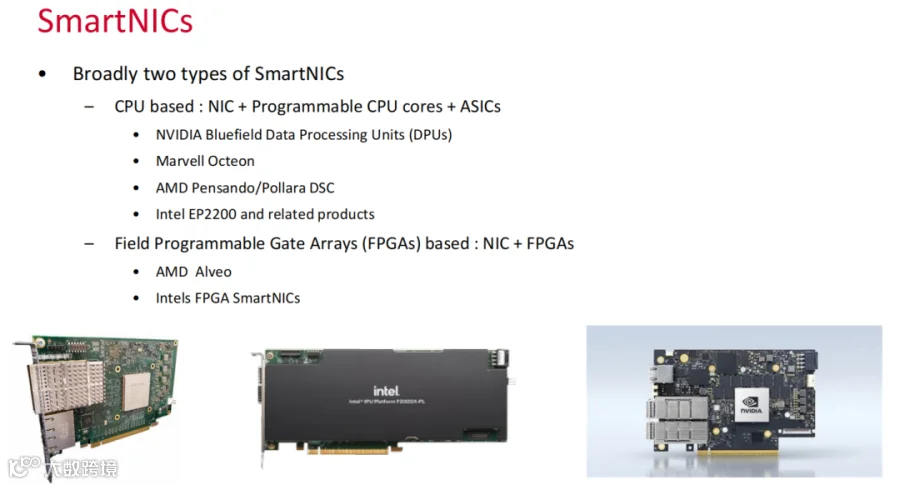
“智能网卡”形态多样,主要分为两类:一类集成可编程CPU核心和ASIC(如DPU/IPU),另一类结合FPGA。两者的共同点是除基础收发包外,还能承接协议处理、加解密、压缩或特定通信任务。DPU的价值在于将主机CPU的基础设施工作下沉至更靠近数据路径的位置。
目前DPU通信卸载已覆盖非阻塞全互换、广播、全聚合及点对点通信等MPI操作。评估DPU时,除核数和端口速率外,更应关注其可卸载的通信类型、现有软件栈的支持程度,以及卸载后是否引入新的运维复杂度。
无论是CPU型还是FPGA型SmartNIC,其本质区别在于实现路径,核心评判标准在于工作负载是否真正从主机迁移至网卡。
结语:沿数据路径逐段排查AI网络瓶颈
评估AI集群网络性能时,需逐项核对以下关键点:GPU与网卡的数据直交换能力、交换机对集合通信规约的支持、DPU与现有通信栈的兼容性,以及这些能力在实际拓扑、驱动和BIOS设置中的可用性。任一环节的缺失,都将导致GPU、网卡和交换机的峰值指标无法转化为实际的通信效率提升。