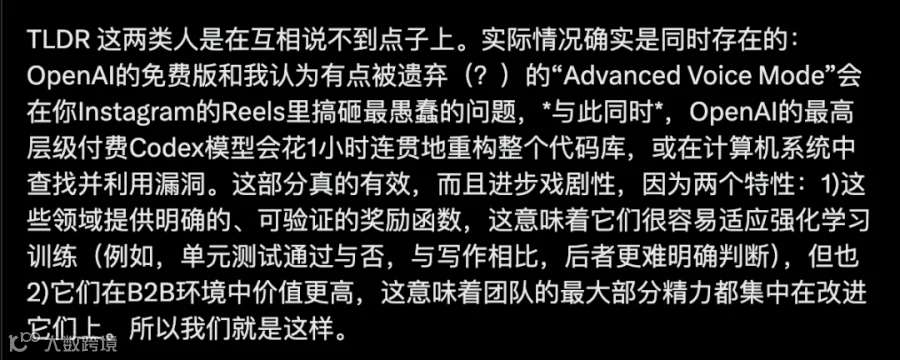
Andrej Karpathy发布最新长文,对今年4月的观点进行了重要补充与深化。他指出,全球对AI能力的认知存在巨大断层,绝大多数人视AI为偶尔出错的玩具,而极少数顶尖专家已目睹其彻底失控的恐怖潜力。
全球人口被切分为四个AI认知层级
Karpathy认为,普通人与顶级专家对AI的理解差距正在演变为一个残酷的“陡峭漏斗”,全球人口据此被划分为四个截然不同的世界:
第一层:未接触者(约60亿人,占比75%)
这一群体至今几乎完全未接触过大语言模型,处于AI世界的边缘。
第二层:低频浅层用户(约10-20亿人,占比20%)
主要为免费版ChatGPT等产品的低频用户。在他们眼中,AI仅是稍好的搜索引擎或文字修改工具,偶尔用于预订机票等简单任务。由于常遇到语音模式回答常识性错误、产生幻觉等问题,加之职场高管等多依赖道听途说,他们普遍得出“AI实用性低”的结论。
第三层:专业高频用户(约2000万人,占比0.2%)
主要在数学、编程等领域高频使用OpenAI Codex、Claude Code等顶级商用模型。他们亲眼见证智能体通过简单指令完成原本需数周的大型复杂项目,如应用开发、代码翻译及二进制反编译等。这批每月付费200美元以上的技术人员正经历强烈的“AI眩晕症”,目睹模型瞬间解决高难度代码问题。
第四层:核心掌控者(约5000人,占比0.00006%)
位于金字塔顶端,直接访问实验室内部未公开的最前沿系统。他们目睹的是成千上万智能体集群协同工作数周,攻克超大规模软件工程,自动挖掘0day漏洞,以机器速度发起并防御网络攻击,甚至发现新科学规律和推进数学前沿。这些工作原本需顶级专家耗时数年,如今人类的理解速度已全面落后于AI。

认知撕裂背后的三大核心原因
为何普通人觉得AI愚蠢,而顶尖圈子认为其在垂直领域狂飙?Karpathy指出了三个关键因素:
1. 目标规模与难度差异
仅用生活琐事测试无法体现模型实力。只有面对海量、极难且真正关心的超级难题时,才能榨出AI的极限能力。
2. 能力分布极度不均
AI在数字化、结果可验证且商业价值高的领域(如数学、编程)表现最强。这是因为大模型依赖强化学习,代码测试通过与否、数学证明成立与否均有客观标准,便于算法奖励。相比之下,聊天、写作缺乏客观对错标准,难以训练。此外,企业级软件和网络安全利润丰厚,资源自然向这些方向倾斜,日常闲聊因获利少而未获重点攻坚。
3. 访问权限不平等
免费层、付费层与实验室内部层看到的产物完全不同。大众面对的是经常翻车的聊天框,普通专业人员仅感微弱提效,而极少数人则目睹技术曲线笔直向上狂飙。
回顾4月观点:两群人的平行现实
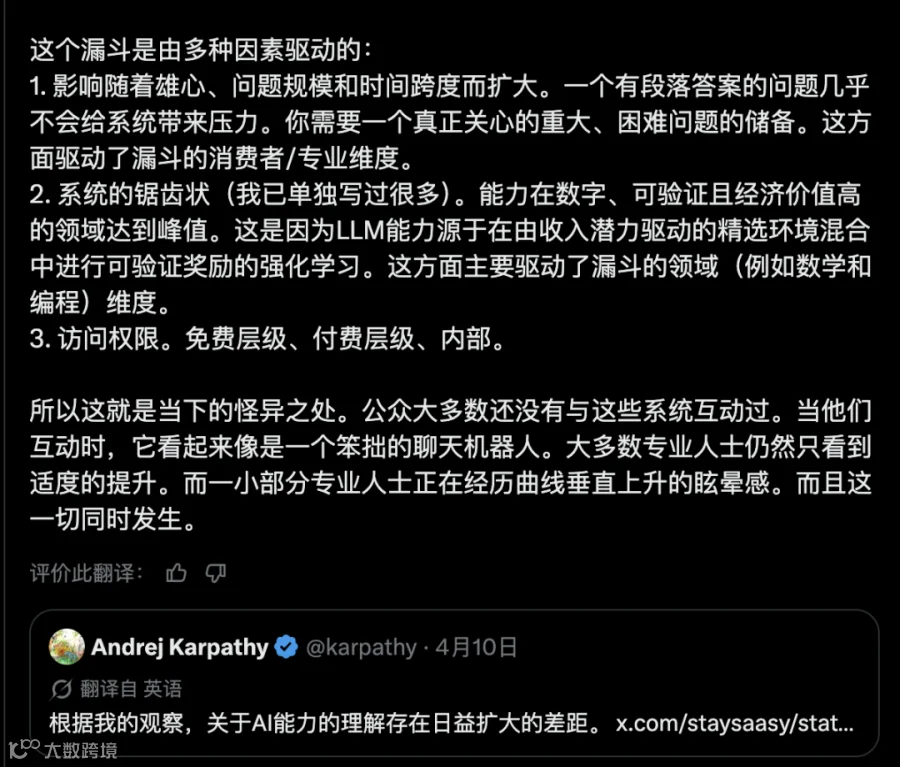
Karpathy在4月10日的推文中曾指出两个关键问题:
首先是使用时间和档位的影响。许多人基于去年免费版ChatGPT的体验定格了对AI的看法,嘲笑其怪癖与幻觉。然而,这些过时模型无法代表最新的智能体模型(如Codex和Claude Code)。
其次是能力集中的领域。即便使用最先进的付费模型,进步也主要集中在高度技术性领域。搜索、写作等常见用法因缺乏明确奖励函数及商业优先级较低,进步不明显。
这导致了两群人“各说各话”的局面:一群人看到的是免费语音模式在简单问题上翻车;另一群人看到的是最高档付费模型连续工作一小时,条理清晰地重构整个代码库或利用系统漏洞。后者之所以真实有效且进步巨大,得益于明确的验证奖励机制(如单元测试)以及企业在高价值场景中的巨额投入。