👇扫码免费加入AI知识星球,如您有工作需要分享,欢迎联系:aigc_to_future

论文:http://arxiv.org/abs/2609.22069
项目主页:https://wxliii.github.io/OmniVBench/
训练数据:https://huggingface.co/datasets/wxli318/Omni-R2V
评测基准:https://huggingface.co/datasets/wxli318/OmniVBench
01 引言
视频生成正在从单纯的文本驱动,走向更灵活、更精确的全能参考(Omni Reference-to-Video, Omni R2V)控制。在实际创作中,参考素材承担的作用正在变得越来越丰富:用户可能希望保持某个人物的身份与外观,同时参考另一段视频中的动作和运镜;也可能希望沿用某种视觉风格,或按照故事板给定的结构与剧情生成新的镜头。进一步地,多份参考还可以共同控制不同的人物、场景、风格或结构,并按照指令组合到同一个生成结果中。
然而,现有公开训练数据和评测体系仍主要围绕有限的参考类型和相对简单的控制设置构建,难以完整覆盖这些不断扩展的 R2V 需求。
为此,推出 OmniR2V Dataset 与 OmniVBench:前者提供面向多种参考任务的大规模训练资源,后者系统评测模型在多样化、细粒度及组合参考条件下的生成能力,共同为 Omni R2V 的训练与评估提供基础。
02 OmniR2V Dataset:从专业视频素材到多任务 R2V 训练数据
目前,高质量、可直接用于训练的多任务 R2V 数据仍然十分稀缺,其规模化构建成本主要来自两个方面。
-
R2V 数据构建需要复杂且任务特定的处理管线。 从原始视频到训练样本,需要额外构造 Reference–Target 关系;而不同 R2V 任务所需的参考关系各不相同,难以共享统一的构建流程。随着参考类型和组合方式增加,需要针对不同任务分别设计匹配、提取、生成,筛选,以及caption策略,进一步提高了规模化数据构建的成本。
-
高质量 R2V 数据依赖丰富且高质量的视频素材。Omni R2V 需要从视频中构建人物、场景、动作、运镜、风格和叙事等多种参考关系,因此不仅要求素材具有足够的视觉质量和内容多样性,还需要丰富的跨镜头、跨片段关系。大规模、多样且高质量的视频资源,是构建高质量 R2V 数据的重要基础。
因此,R2V 数据的难点不仅在于获得大规模视频素材,更在于将原始视频系统转化为具有明确参考关系、可直接用于训练的结构化样本;当任务进一步扩展到 Omni R2V 时,这一构建成本也随之增加。
针对这一问题,研究者们构建并开源了 OmniR2V Dataset。
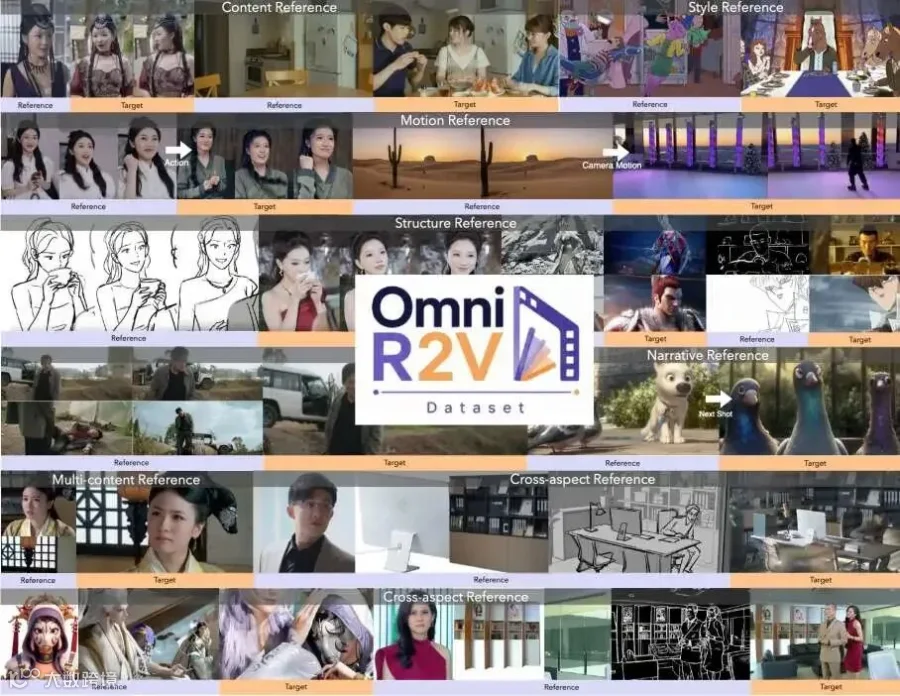
OmniR2V Dataset 主要基于腾讯视频大规模专业版权视频资源构建。数据覆盖真人实拍、二维动画和三维动画等多种内容形态,并以 1080p、2160p 及以上高分辨率视频为主,为多样化 R2V 数据构建提供了高质量的素材基础。
数据集共包含 339,570 条处理后的训练样本,覆盖 Content、Motion、Style、Structure、Narrative、Multi-Content 和 Cross-Aspect 七类 R2V 任务。针对不同参考因素,设计相应的任务特定构建流程,通过跨片段匹配、参考因素提取、逆向生成与质量筛选等方式,将原始视频转化为具有明确参考关系的 R2V 训练数据。
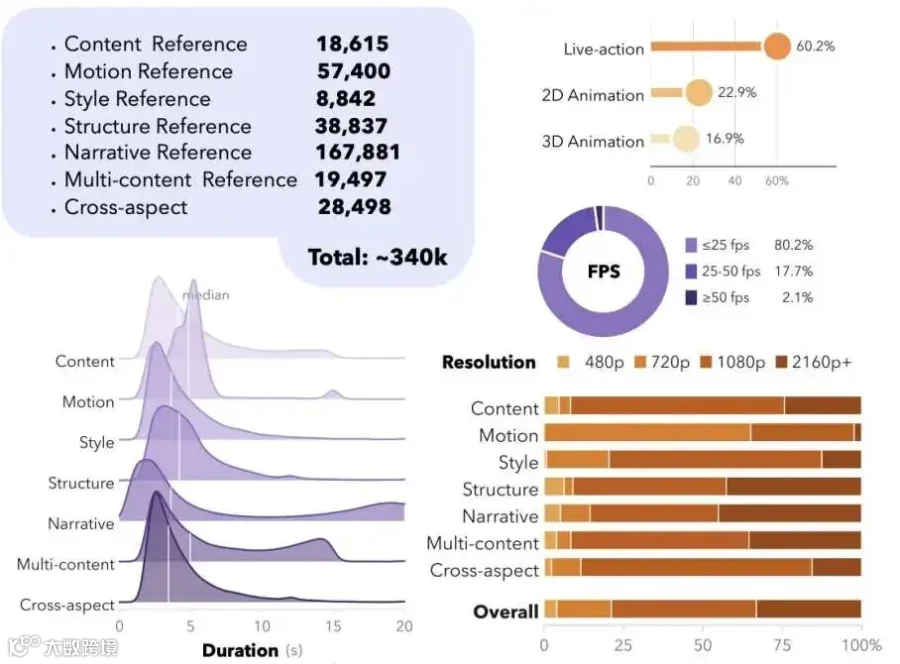
不同于仅提供原始视频链接、仍需用户自行下载和处理的数据资源,OmniR2V Dataset 直接提供包含参考输入、训练指令和目标视频的完整训练样本,降低社区开展 Omni R2V 训练与研究的数据构建门槛。

03 OmniVBench:覆盖更丰富的参考任务,评估更细致的参考控制
随着 R2V 能力不断扩展,评测本身也面临新的问题。
已有 R2V benchmark 往往集中于人物、物体或场景等内容参考,对于运动、运镜、风格、结构和叙事等参考因素覆盖不足;即使针对同一种参考类型,也较少进一步区分不同的细粒度控制能力。与此同时,实际生成任务正在快速走向多参考与组合控制,模型不仅需要理解单份参考,还需要从多份参考中提取正确的信息,并按照指令将不同参考因素作用到正确的目标上。
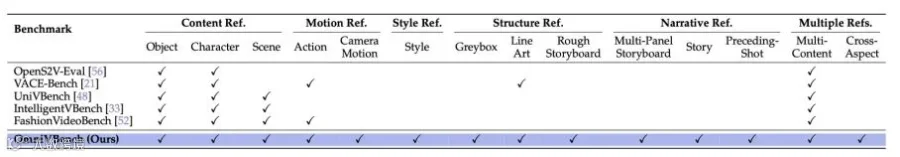
针对这些变化,OmniVBench 从四个方向扩展 R2V 的评测范围:
-
更广的参考类型:覆盖内容、运动、风格、结构和叙事等不同参考因素;
-
更细的控制粒度:进一步区分整体物体、材质、纹理和局部部件等不同粒度;人物参考则覆盖单视角、多视角、定制修改和属性定位等设置。关键参考信息不直接通过文本重复描述,从而真正考察模型从参考中理解和提取目标因素的能力。
-
更多的参考组合:不仅评测单参考,还包含 Character–Scene、Character–Object、Character–Object–Scene 等 Multi-Content 设置,以及 Content-Style、Content-Structure 等 Cross-Aspect 组合;
-
更灵活的定制控制:模型需要根据指令判断每份参考中哪些因素应该被提取、哪些因素需要被排除,并进一步将不同参考因素正确绑定到对应的目标实体或属性。
最终,OmniVBench 建立了覆盖 7 大任务类别、18 个细分任务、813 个测试案例的 R2V benchmark,从单一参考一直扩展到复杂的多参考组合设置。
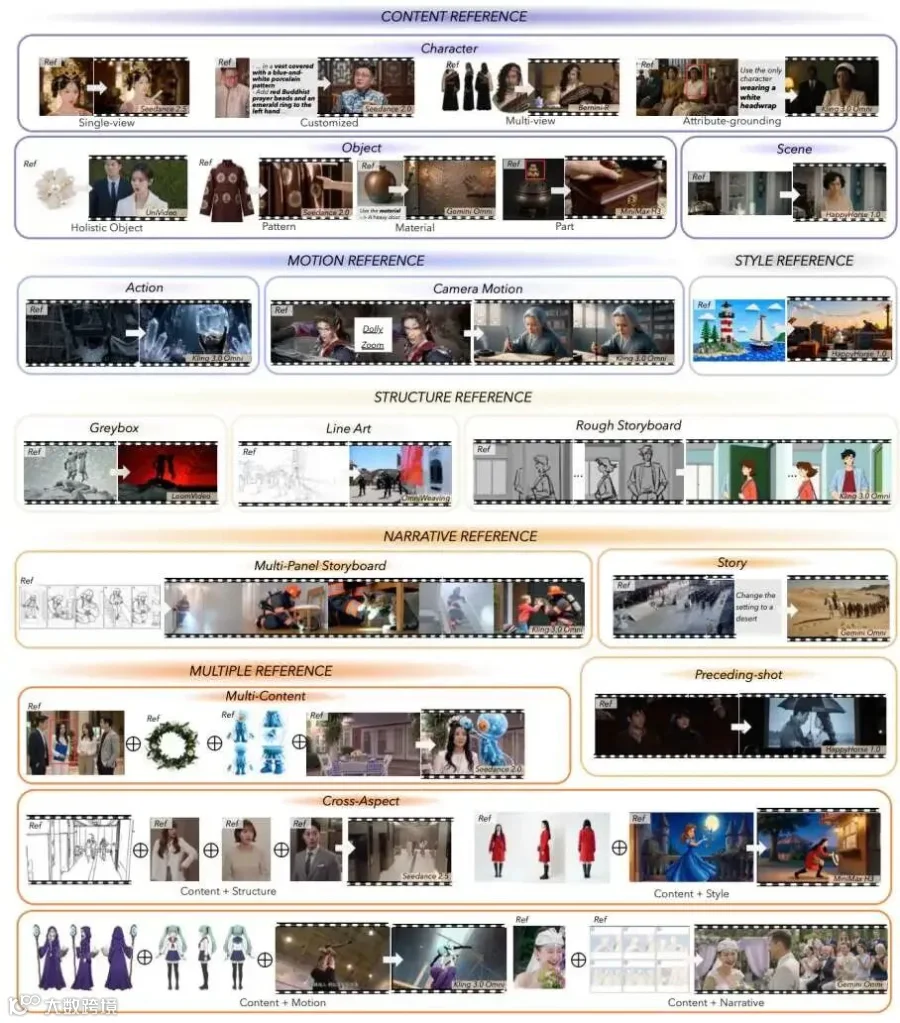
不只是“测得更多”,也需要“评得更细”
任务变复杂之后,传统的整体式 VLM 打分也会遇到明显局限。
例如,一个生成结果可能正确保留了参考人物的身份,却错误复制了参考图中的服装;也可能成功提取两份参考中的内容,却把人物 A 的属性绑定到了人物 B。此时,仅询问 VLM “生成视频与参考是否一致”,很难定位模型究竟在哪一个环节出现了问题。
因此,OmniVBench 提出 factor-grounded evaluation。根据每个测试案例中的参考角色、目标绑定关系与生成指令,构建了 12,172 个 case-specific checklist items,将复杂的整体判断转化为与具体参考因素对应的细粒度检查。
整个评测从三个互补维度展开:
Reference Fidelity(RF):参考因素保留得是否准确。
针对 Content、Motion、Presentation、Structure 和 Narrative 等参考类型,分别评估生成结果对目标参考因素的保持程度。
Instruction Realization(IR):参考与指令之间的控制关系是否正确实现。
这一维度进一步关注两个问题。首先是 Reference-Factor Disentanglement and Routing:模型是否从每份参考中提取了正确的信息、避免复制无关因素,并将其作用到正确的目标;其次是 Target Compliance:指令中额外要求的实体、属性、动作、空间关系、交互、镜头控制或叙事变化是否得到正确实现。
Video Quality(VQ):最终视频本身的生成质量如何。
从美学表现、物理合理性和感知质量等方面评价最终生成结果。
这样的拆分,使 OmniVBench 不再只回答“这个视频生成得好不好”,而能够进一步区分:参考因素有没有保留下来、不同参考信息有没有被正确解离和路由、指令要求有没有真正实现,以及最终视频质量如何。
通过这种 factor-grounded evaluation,我们希望对复杂 Omni R2V 模型提供比单一整体评分更加细致、可解释的能力诊断。
现有模型表现如何?
研究者们进一步使用 OmniVBench 对多款代表性的开源与闭源视频生成模型进行了系统评测。实验表明,当前模型在不同 R2V 任务上的能力仍然很不均衡:内容参考相对成熟,而在运动、风格、结构、叙事及多参考组合等复杂任务上仍存在明显提升空间。同时,模型的 Reference Fidelity 与 Instruction Realization 呈现出不同的能力表现——能够较好保留参考信息,并不意味着能够正确完成参考因素的解离、路由与指令控制。这些结果进一步说明,对 Omni R2V 进行细粒度、分维度评测的必要性。
04 总结
随着 R2V 走向更广的参考类型、更细的控制粒度、更多的参考组合和更灵活的定制方式,训练数据与评测体系也需要随之扩展。
开源的 OmniR2V Dataset 提供 339,570 条处理后的完整 R2V 训练样本,降低多类型、组合式 R2V 数据的构建门槛;OmniVBench 则通过 7 大任务类别、18 个细分任务、813 个测试案例和 12,172 个 factor-grounded checklist items,为复杂参考控制提供更全面、细粒度的评测。
希望这两项资源能够为社区提供一套覆盖训练与评测的 Omni R2V 基础设施,支持更通用、更灵活的参考视频生成研究。
技术交流
加入「AI生成未来社区」群聊,一起交流讨论,涉及 图像生成、视频生成、3D生成、具身智能等多个不同方向,备注不同方向邀请入群!可添加小助手备注方向加群!