

导读AI Agent 看过一张图后,长期留下什么,由系统的记忆机制决定:可以保存文字描述,也可以保留原图及其地址,再建立检索索引。后来出现新问题,系统找回相关记录,把所需文字或图片交给模型,模型才能利用这些历史材料回答。以图片为例,沿着保存、检索和读取三个环节,可以看清多模态长期记忆怎样工作,以及细节丢失、旧记录误用发生在哪里。
本文 2494 字,阅读约 6 分钟|模型看懂图片,系统负责留下记忆 → 描述、原图和链接,各自负责什么 → 找回了记录,回答时未必重新看图 → 原图保留细节,文字也能整理变化 → 历史材料分散时,还要把证据组织起来
模型看懂图片,系统负责留下记忆
假设你给一个多模态 Agent 一张拍到设备背面接口的照片,第一次只让它介绍设备用途。几天后,你又问:背面有几个接口?
照片里本来有答案,模型第一次也处理过图片,但第二次仍可能答不出来:那张图可能已经不在当前对话上下文里,系统留下的设备介绍又没有写接口数量。
多模态 Agent 是能处理文字、图片等不同形式的信息,并围绕目标调用工具、推进任务的智能体。模型提供理解图片和生成回答的能力;Agent 系统通过记忆模块、存储与检索工具,把历史材料保存下来,再按需要交给模型。
本文讨论的长期记忆保存在模型之外,例如文件或数据库。模型当场看懂图片,与 Agent 系统长期保存图片,是两个环节。原图和对它的解释可以一起留下;之后能否用上,还要看系统怎样找回材料,以及模型实际读取了什么。
 图片说明:本文概念示意。保存、检索和读取是三个不同环节,各系统的保存内容与读取策略可以不同。
描述、原图和链接,各自负责什么
保存一张图,可以同时留下几种不同的材料。
先是文字描述。视觉模型可以描述物体、场景与动作;光学字符识别,也就是 OCR,可以提取画面上的文字。系统还可以把这些信息整理成字段,例如设备型号、出现地点和记录时间。
这些文字容易搜索,也方便交给语言模型。但描述必然有所取舍。第一次关注设备用途时,可能没有记录背面的接口;未来问题一变,原来够用的描述就可能缺信息。
然后是原图及其地址。图片文件可以保存在本地或云存储里,记忆记录保存对应路径或链接。原图保留画面,链接提供读取原图的入口。如果以后要检查描述没提到的接口,就可以通过这个入口取回图片。
不过,链接能否继续使用,要看文件是否还在、地址是否有效,以及读取方是否有访问权限。要让模型重新看到画面,系统还要加载地址指向的图片。
AUGUSTUS 是一种记忆系统,它展示了这些材料怎样配合:非文本媒体放入云存储,一条记忆记录同时保存媒体 URL、文字解释、语义标签、模态类型和时间戳。查询时,先找到相关标签,再查找关联的上下文记录。
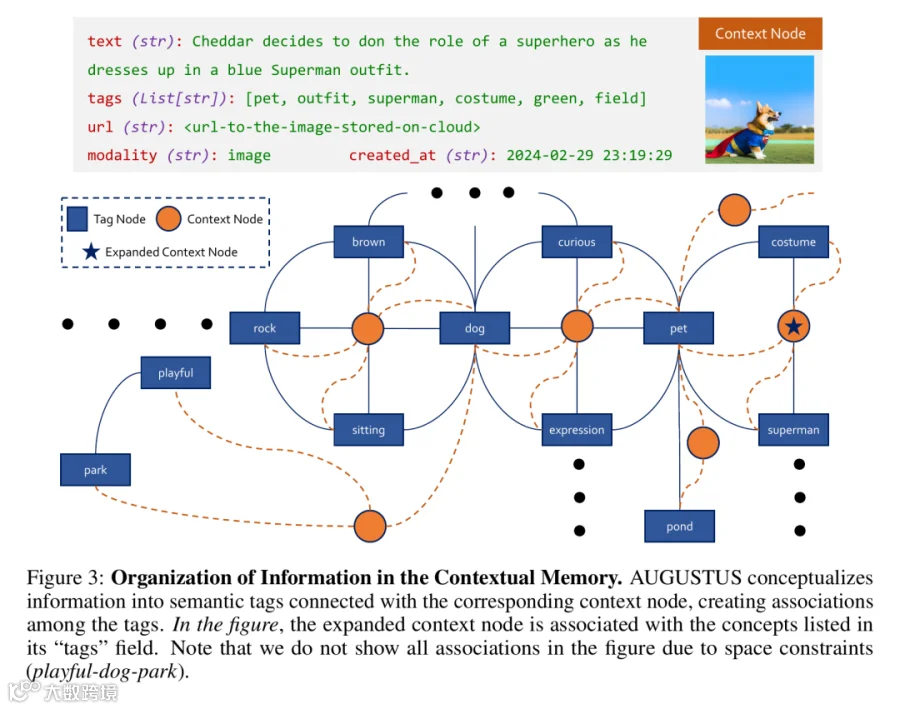 图片说明:AUGUSTUS 论文 Figure 3。上方节点同时包含 text、tags、url、modality 和 created_at;下方展示标签与上下文节点的关联。图片来源:AUGUSTUS 论文
有了保存的材料,还需要检索索引。为了从大量历史中找到相关记录,系统可以为文字和图片建立嵌入向量:把内容编码为一组数字,用向量之间的相似程度筛选候选记录。时间、地点、会话归属等信息也可以参与筛选。
例如,新问题提到设备接口,系统可以用这个问题寻找相关记录,再从记录中取出描述或原图地址。向量承担的是定位职责,不能当作原图的无损副本,也不能替代回答时需要的图片。
因此,同一张图可以既有描述,又有原图地址和检索索引。它们一起组成可供后续使用的记忆记录。
找回了记录,回答时未必重新看图
新的问题到来后,检索系统先寻找候选材料。如果问题涉及特定时间或地点,相关条件可以帮助缩小范围;如果问题涉及视觉内容,图片表征也可以参与匹配。
候选记录找到以后,Agent 系统还有一步:决定把什么交给回答模型。具体记忆问答实现,可以帮助我们看清这一步的差异。
Pensieve 是一个记忆问答系统。它保存图片快照、记录指令、时间和地点,并补充 OCR 与图片描述。检索时,图文相似度、时间和地点都可以帮助找到记录;到了回答阶段,其论文方案主要使用提取后的丰富文字,以控制大量图片带来的上下文成本。
在这样的流程里,图片参与了保存和检索,回答模型主要收到的仍是文字。
另一种实现会把原图一起交给模型。MemEye 是用于评估多模态长期记忆的研究基准,其中的 SimpleMem(V) 实现保留原图地址,在回答时加载图片;其多模态检索基线也会把选中的原图交给回答模型。
 图片说明:本文示意。回答模型能使用什么,取决于实际交给它的材料;回看原图仍受图片清晰度与识别能力限制。
回到设备照片:如果只交给模型一段设备用途介绍,历史材料就没有提供接口数量的依据;如果把相关原图加载回来,视觉模型才有机会重新观察接口。能否数对,还取决于照片是否拍清楚,以及模型的识别能力。
是否加载原图,需要 Agent 系统安排相应流程:可以在检索到带图记录后直接加载,也可以设计成先判断文字是否够用,再决定回看。系统存了图、检索找到了图、模型回答时读了图,是三个需要分别检查的环节。
原图保留细节,文字也能整理变化
MemEye 的一组案例要求回答两个动画角色的眼睛颜色。
案例中的图片描述交代了角色、草地和场景,却没有记录眼睛颜色。只读取这些描述的模型缺少依据;原图则仍包含可供检查的颜色细节。论文标注的答案是紫色角色红眼、橙色角色绿眼。
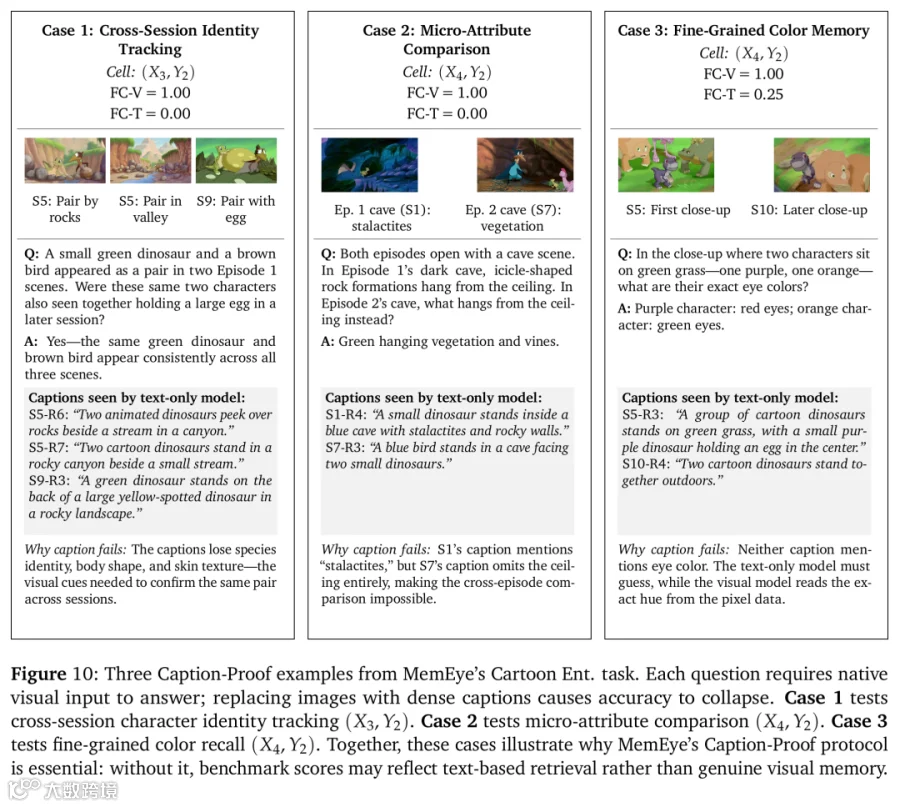 图片说明:MemEye 论文 Figure 10,包含身份匹配、洞穴细节和颜色记忆三个基准案例。右栏对照原图、问题与实际保存的描述,展示眼睛颜色被遗漏的情况;图内成绩仅对应这些案例。图片来源:MemEye 论文
这个案例里,原图的价值在于保留了当时描述没有写下的细节。如果描述已经准确记录眼睛颜色,文字也能提供相应依据。
同一研究还有黄铜罗盘迁移的案例:罗盘先出现在展示柜,后来从柜里消失,再出现在修复台。文字记忆方法 A-Mem 找回了这些状态变化,回答了新位置;部分图像记忆实现找回了旧场景或无关材料,仍然答错。
两个案例暴露的是不同问题:眼睛颜色在描述时丢失,罗盘位置则在找回和理解历史时出错。保留原图可以增加回查细节的机会,正确回答还需要正确时刻、正确对象的材料。
历史材料分散时,还要把证据组织起来
罗盘位置这样的任务,也引出了下一步:有些问题需要把多条记录联系起来。较早的照片告诉系统罗盘原来在哪,后来的记录说明它已离开,另一张照片才给出新位置。
单独按相似度排序,可能反复找到同一主题的旧记录,漏掉措辞不同却能补齐答案的信息。把所有相关内容都交给模型,也会占用上下文,并引入重复和无关材料。
GraphMemix 是一种组织历史记忆证据的方法,改进的就是这个环节。它先用原图、描述、OCR 或视频帧等线索检索候选,再利用记录所属会话等结构关系,以及内容相近的记录扩展范围。随后,系统分别判断一条记录能直接支持什么,以及它相对已有证据增加了什么。
在交给回答模型的记忆条数上限内,它选择记录与可靠关系,把互补记录连成树状证据组,称为“证据森林”。选中的材料再按顺序交给回答模型;视觉记录可以附带图片或采样视频帧。
 图片说明:GraphMemix 论文 Figure 1。右侧依次展示候选构建、证据价值与关系判断、证据森林选择;左下方展示最终保留的互补材料。图中的截止日期任务用于说明方法流程。图片来源:GraphMemix 论文
它的贡献集中在证据选择与组织:在已有候选材料里,尽量保留能补齐答案的记录,减少重复。论文在相应基准设置下验证了回答改善;关键记录若未进入候选范围,后续组合仍无法补出缺失内容。
回到最初的设备照片。第一次介绍用途时,文字描述可能已经够用;几天后要数接口,Agent 系统就需要找回包含这一细节的材料,并让模型实际读取它。照片留在存储里,只完成了其中一步。长期记忆的价值,在于过去留下的信息还能支持后来出现的新问题。
别再笼统谈 Agent 记忆:先分层,再问三个问题
参考资料
•AUGUSTUS:媒体 URL、文字解释、标签与上下文检索机制: https://arxiv.org/html/2510.15261v1
•Memory-QA / Pensieve:记忆增强、多信号检索与文字回答方案,EMNLP 2025 正式论文: https://aclanthology.org/2025.emnlp-main.1234.pdf
•MemEye:视觉细节、状态变化与记忆实现,含 Figure 10 和附录案例: https://arxiv.org/html/2605.15128v1
•GraphMemix:候选检索、证据关系与证据森林选择,含 Figure 1: https://arxiv.org/html/2608.26983v1
— THE END —
文章仅做学术分享,如有侵权请联系删除,非常感谢!