


上一篇文章《Palantir Foundry 的开源平替来了:Helix Foundry》聊的是 :一个跑在自己电脑上的开源项目,把公司的数据库、Stripe、文件和 API 连成一个本体,很多人把它叫作 Palantir Foundry 的开源平替。
巧的是,社区里另一个顶着“开源 Palantir”名头火起来的项目,瞄准的却是另一个层面的问题。这个项目叫 semantica,13,900 多个 stars、1,600 多个 forks,MIT 协议,纯 Python,自我定位是“Graph-Native Infrastructure for Context and Accountable AI Systems”。它盯的不是“把数据连起来”这一步,而是连起来之后更棘手的那个问题。
那是什么问题?做 Agent 的团队这一年撞上的墙,多半不是模型不够聪明,而是没人能说清它为什么这么干。
向量库给的是相似度,不是含义。检索回来的十条上下文,彼此什么关系、哪条是权威来源、哪条和另一条互相矛盾,向量距离一概答不上来。Agent 的决策过程大多只留在日志里,甚至根本没留。更要命的是,当两条事实冲突时,多数系统会选择静默覆盖,事后既不知道被盖掉的是什么,也不知道当初是依据哪条做的判断。
“Agent 版开源 Palantir”这个说法有几分含金量,需要拆开看。
semantica 最关键的是位置。它不替代你的大模型,不替代向量库,也不替代 LangChain 或 CrewAI。它做的是这三样东西下面那一层:语义与上下文的基础设施。
它提出的核心对象叫 Context Graph。向量库回答“什么和什么相似”,Context Graph 回答的是另外三个问题:什么和什么相连、为什么相连、怎么相连。每个实体、关系、决策、事实都是图上的节点,边可以带类型、权重和元数据,可以按跳数做遍历,也可以把一个图回滚到任意历史时点的样子。
这个定位决定了它的两条设计原则。
第一条,图谱构建、推理、血缘这三件事全程不需要大模型,因此结果是可复现的:同样的输入走一遍,得到同样的输出。大模型只在可选环节出现,而且是厂商中立的,OpenAI、Anthropic、Gemini、Ollama、DeepSeek 都能接。对金融、医疗这类要被审计的场景来说,可复现不是加分项,是准入门槛。
第二条,存储是可插拔的。RDF 三元组库有 Oxigraph(内嵌)、Blazegraph、Apache Jena、Eclipse RDF4J 四种,标签属性图有 Neo4j、FalkorDB、Apache AGE、AWS Neptune 四种,加起来八种图数据库,向量库另有 FAISS、Qdrant、Weaviate、Milvus、Pinecone、PgVector 六种。切换后端不需要改业务代码,这一点对想先本地跑通、之后迁到生产环境的团队很重要。
从原始数据到图谱:整条流水线
官方把整条链路画成四层:摄取、语义引擎、知识存储、输出。每一层都是独立可导入的 Python 模块,不是包装成一个黑盒。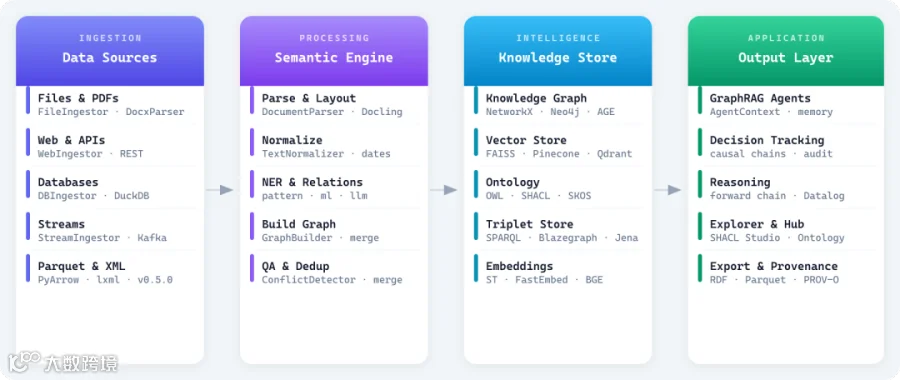
摄取层覆盖得相当宽:本地文件(PDF、DOCX、PPTX、CSV、Parquet、JSONL、Excel、XML)、网页、RSS、REST API、关系数据库、Kafka 与 Kinesis 这类消息流、Git 仓库、IMAP 邮箱、MCP 资源。企业侧有三个原生连接器值得单独说:Databricks(连 Unity Catalog 和 Delta Lake,能取表血缘)、Snowflake、SAP OData。最近一版又补了 BigQuery、Amazon Redshift、Power BI 和 Apache Airflow。这一步的意义在于,数据不用先导出成 CSV 再进来,仓库里的表可以直接变成图上带来源的节点。
处理层做的事比一般的 RAG 管道要细。分块环节提供了十几种策略,其中实体感知分块保证同一个实体不会被切成两半,关系感知分块保证三元组不被拆散,图驱动分块则用中心度来切出自然的社区边界。抽取出实体、关系、事件和三元组之后,先做归一化(文本、日期、数字、编码),再进冲突检测和实体消解。
这里的处理方式值得展开一句。冲突检测覆盖值、类型、关系、时序、逻辑五类,消解策略可以选按来源可信度加权、取最新、多数投票等几种,而且来源的可信度分数本身是可以随着时间调整的。去重那边先给实体做语义相似度加分块聚类,比如 Acme Corporation、Acme Corp.、ACME Corp 这三种写法会被判成同一组,再走合并流程,合并时保留血缘。
建图层在图上跑常规分析:度中心度和介数中心度用来找关键实体,Louvain 做社区发现,最短路做路径查询,还有链路预测来推断可能缺失的关系。
输出层支持导出成 Turtle、JSON-LD、N-Triples 这类 RDF 格式,也能导出 Snappy 压缩的 Parquet 快照、给 Neo4j 或 Memgraph 用的 Cypher 语句,以及一份人可读的 HTML 审计报告。
决策记在图上:能查先例,能追因果
这套系统里最有意思的设计,是它怎么对待“决策”这件事。
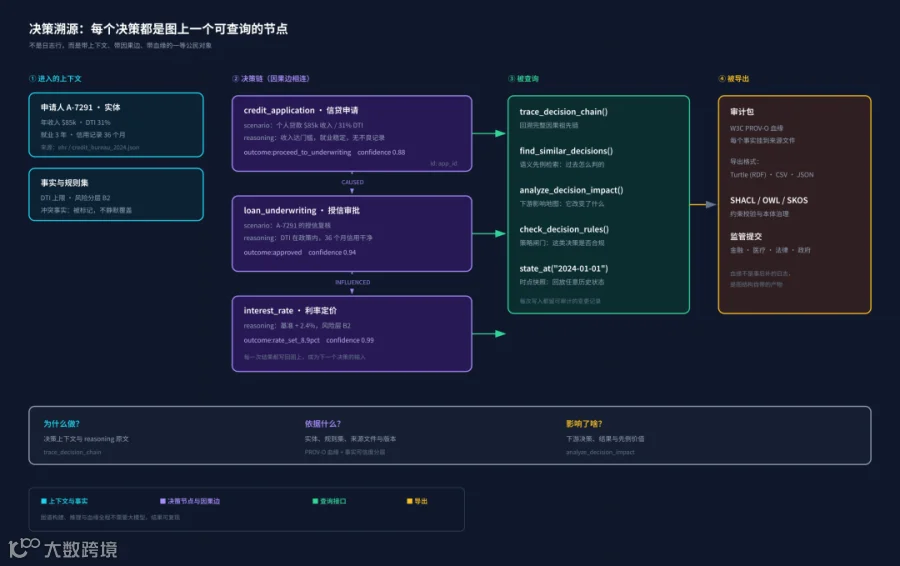
大多系统把决策当日志处理,写进文件或者表里,用来事后排查。semantica 的做法是把每次决策当成图上的正式数据对象存下来,场景、推理过程、结论、置信度一起写进去,决策之间还可以连因果边,关系类型限定为 CAUSED、INFLUENCED、PRECEDENT_FOR 三种。
   from semantica.context import ContextGraph

graph = ContextGraph(advanced_analytics=True)

app_id = graph.record_decision(
    category="credit_application",
    scenario="Personal loan, $85k income, 31% DTI, 3yr employment",
    reasoning="Income meets threshold; employment stable; no adverse credit events",
    outcome="proceed_to_underwriting",
    confidence=0.88,
)
uw_id = graph.record_decision(
    category="loan_underwriting",
    scenario="Underwriting review for A-7291",
    reasoning="DTI within policy; clean 36-month credit history",
    outcome="approved",
    confidence=0.94,
)

graph.add_causal_relationship(app_id, uw_id, relationship_type="CAUSED")

chain     = graph.trace_decision_chain(uw_id)         # 完整因果祖先链
similar   = graph.find_similar_decisions("personal loan, 31% DTI", max_results=5)
impact    = graph.analyze_decision_impact(uw_id)      # 下游影响地图
compliant = graph.check_decision_rules({"category": "loan_underwriting"})
这四个查询接口里,最有用的是 find_similar_decisions,它做的是语义层面的先例检索,也就是“过去遇到类似情况是怎么判的”。在授信审批、理赔核赔、合规审查这些领域,先例检索几乎就是业务本身。trace_decision_chain 解决的是另一个问题:一个结论是怎么被一步步推出来的,中间哪一环改变了方向。analyze_decision_impact 反过来看,这个决策之后影响了哪些东西,比如一笔拒贷会不会连带影响后续的定价策略。
血缘、时间与治理:能被审计的三件事
上面那套之所以成立,靠的是三个更底层的能力。
血缘在写入时生成,不是事后补的。 每条事实落图时就挂上 W3C PROV-O 记录,来源文件、页码、抽取器、置信度都在里面。官方文档里有一句话说得很准:决策溯源和审计记录不是产品功能,而是这套结构自然产生的结果。当监管者追问“为什么把这位客户的赔付额度调低了”,你要做的不是翻日志,而是从那个决策节点出发,顺着因果边和血缘边把整条链拉出来,导成 Turtle 或 CSV 交上去。
时间是两个维度。 系统里的每条事实可以带两个时间:这件事在世界上何时为真(valid time),以及你何时知道它(recorded time)。这两个时间分开记,配合时点快照,就能回答“去年三月的图谱长什么样”“这条雇佣关系当时是不是还有效”这类问题。自然语言的时间表达也能解析,“上个季度”会被转成一个具体的时间区间。
矛盾被标记,而不是被覆盖。 这一点前面提过,但它的价值在治理环节才完整。本体侧有 OWL 生成、SHACL 约束校验、SKOS 词表管理,还有一个可视化的 Ontology Hub 用来画本体、查健康度。最近一版加的事实可信度分层挺实用:来源互证不足的事实先被隔离,再按青铜、白银、黄金分级,检索时可以只取被支持的事实,不取有争议的那些。
给 Agent 用:接口和接入方式
底座做得再好,用不上也是白搭。semantica 在接入这块铺得比较开。
给 Claude 这类工具接上,配一个 MCP 服务即可:
   {
  "mcpServers": {
    "semantica": { "command": "python", "args": ["-m", "semantica.mcp_server"] }
  }
}
它通过 MCP 暴露了十几个工具:抽取实体和关系、记录决策、查询决策历史、找先例、拉因果链、跑规则推理、取图分析结果、导出图谱,还有一整套存文档和取上下文的语义检索工具。也就是说,你可以让 Agent 一边干活一边把判断写进图谱,之后再回溯。
除此之外还有 REST API、二十多个命令组的 CLI,以及 LangChain、LangGraph、CrewAI、Agno 的官方适配。其中 Agno 那个用法值得看一眼:多个 Agent 绑定同一个共享上下文,研究员查到的结论,分析员立刻能用,不需要复制也不需要同步,等于给一个 Agent 团队发了同一份记忆。这个思路对多 Agent 协作里“各自记各自的、信息对不上”的老问题,是个挺直接的解法。
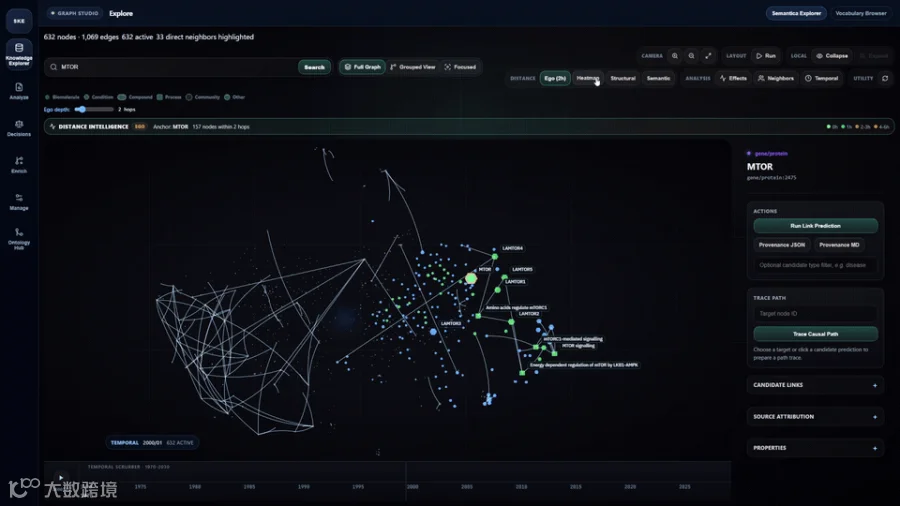
自带的 Knowledge Explorer 是个浏览器工作台,用 React 19 加 Sigma.js 写的,分成七个区域:图谱、时间线、决策因果链、变更登记册、实体消解、本体中心、血缘视图。装一个 extra 就能起来:
   pip install "semantica[explorer]"
semantica-explorer --graph my_graph.json
它和 Palantir 差在哪
到这里可以把开头那个称号拆开了。
semantica 提供的是本体底座的那半件事:图谱、治理、推理、血缘、决策记录。Foundry 的另一半,它一样都没有。没有把决策落回业务系统的能力,不能写回、触发工单或流程;没有行业本体模板,电力、航空、国防那些沉淀了十几年的对象模型和关系定义,得你自己从头建;没有 FDE 的组织回路,现场经验与产品能力之间的双向反馈,开源项目天然不具备;也没有企业级的多租户、权限体系和 SLA,这部分要靠它背后的商业公司做私有化交付来补。
它还处在很早期的阶段,而且官方自己在文档里就把话说得比较实。Rete 引擎的条件匹配器“在这一版里刻意做得简单”,接生产合规闸门前必须拿自己的规则集验证输出;性能表里那些“快 6000 倍”的数字是 v0.5.0 的历史测量,记在变更日志里而不是自动化断言;直到 v0.7.0 才把核心依赖从 44 个砍到 22 个,重依赖改成按需安装,Python 要求提到 3.10。
从提交记录看,这个项目更新得很勤,一天之内就有多次合并,也能看到他们在修上一版遗留的问题,比如 v0.7.0 里时间相关的 CLI 子命令因为调用了已删除的接口而全部报错,随后被单独一个 PR 修掉。活跃度是好事,同时也说明它离稳定期还有距离。
所以更准确的说法是:它把企业级本体平台里最通用、最难自研的那几块底座取了出来,做成开源可插拔的组件。这个类比是合理的,但边界要说清楚,它不是 Foundry 的替代品,短期内也不该被当成替代品来评估。
上手
安装确实只有一条命令:
   pip install semantica
semantica doctor     # 验证安装是否健康
semantica            # 打开启动仪表盘
官方还在仓库里放了一组可以直接跑的 cookbook 笔记,每个都能在五分钟内跑完,想先看效果的话从那里入手最快。要往生产走,官方的建议是别用本地 pip 安装,改用 Docker 或 Kubernetes,把图存储指向 Neo4j、FalkorDB 这类持久化后端,向量库指向 Qdrant 或 Pinecone。
结语
过去我们谈本体、谈可追责的 AI,默认那是企业级软件的范畴:昂贵、笨重,只有大组织付得起。semantica 这类项目的出现,说明底座那一层正在被开源社区啃下来。
它的价值不在于今天能替代谁,而在于把几个关键设计讲明白了:决策要留下正式记录,血缘要在写入时生成,推理要能复现,矛盾要被标记而不是被覆盖。这四条,恰恰是当下大多数 Agent 系统最缺的东西。
项目地址:https://github.com/semantica-agi/semantica
提醒:请朋友们将“智见AI视界”加“星标”,觉得写得好就点击右下角“拇指”和“收藏”哦,不然会慢慢收不到文章推送~
关联阅读