


在自动化测试工作中,脚本执行失败几乎是家常便饭。而每次失败背后,都有一个必须回答的问题:这究竟是产品缺陷,还是测试脚本自身的问题?
近年来,人工智能技术的进步让我们能够借助 AI 快速分析和定位失败因由,甚至对脚本中的问题进行“自动修复”。然而,这种便利也带来了新的挑战。
自动修复会隐藏真实缺陷
举例:短信验证码偶发延迟
用户登录 App 时需要短信验证码。在测试环境下,偶尔超过 30 秒才能收到短信,大多数情况下 5 秒就可以。脚本因为等待超时而失败。
如果使用 AI 自动修改脚本,它通常会把等待时长从 30 秒加到 60 秒,或重做发送验证码的操作。短期看起来问题解决了,但真正需要关注的短信通道服务质量问题并没有得到重视,反而随着脚本变绿被掩盖了下来。
自动修复让异常路径消失
举例:登录前新增“同意用户协议”步骤。
网站在用户登录前新增了“勾选并同意《用户协议》”的步骤,脚本还是按旧流程进行登录操作,于是出现了无法找到登录按钮的错误。
AI 在自愈时会补一步:检测到协议弹窗就自动勾选并关闭。此时脚本虽然通过了,但“不勾选协议不能登录”这条新业务规则就没有被覆盖到。
这两个例子都不是脚本写错了。第一个是 AI 用更长等待掩盖了真实缺陷;第二个是 AI 用额外的处理绕过了新的逻辑分支。它们共同指向行业里常说的 self-healing test anti-pattern:自愈式测试既可能藏住真正的缺陷,也可能让新增的业务场景被悄悄绕过。
按笔者的理解,AI 修复通常只拿到当前步骤附近的局部上下文、DOM 快照和错误信息,缺乏完整业务语义,因此更倾向选择局部、低成本的修复动作,比如调整定位器、加长等待、重试、关闭干扰弹窗等。这类动作能快速让当前步骤通过,却缺少整体业务思维,不一定符合全局最优。
解决方法:隔离观察
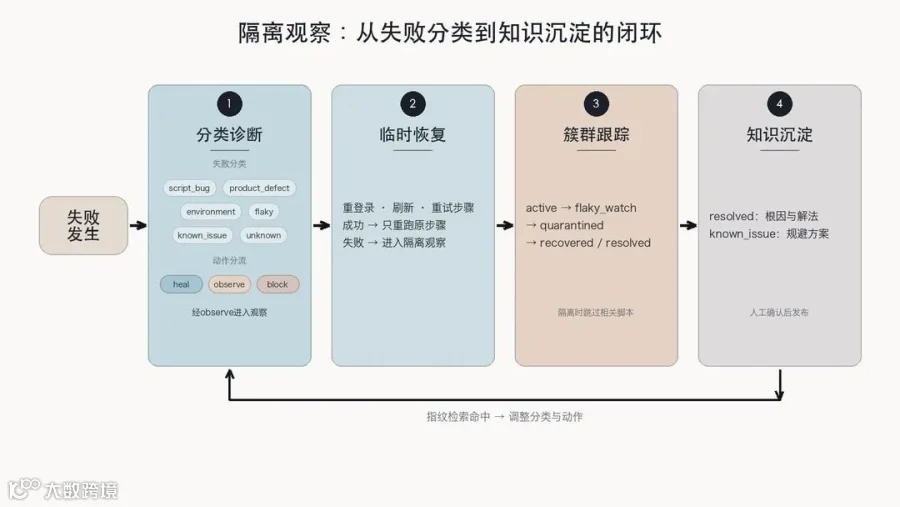
步骤1. 首先对问题进行分类
失败发生时,先尝试回答“这到底是谁的问题?”,把失败分成以下几类:
script_bug:脚本本身的定位器、操作、断言或逻辑处理编写错误product_defect:被测系统的缺陷environment:网络、5xx、浏览器崩溃等环境问题flaky:偶发抖动,暂未定位到稳定根因known_issue:经确认过的已知问题unknown:暂时无法判断的问题
然后,将失败后的动作收敛成三种动作:
heal:高置信度脚本问题,生成修复候选,可在验证通过后应用observe:悬而未决的问题,建议隔离观察,先不修改脚本block:产品缺陷或阻塞执行的危急问题,终止执行,等待人工介入
针对不同项目,设置分类和动作的映射,一种可能的配置如下:
|
|
|
|
|---|---|---|
script_bug |
heal |
|
product_defect |
block |
|
environment |
observe |
|
flaky |
observe |
|
known_issue |
observe
block
|
observe 或 block
|
unknown |
observe |
|
步骤2. 接着尝试临时恢复
以上动作中需要重点关注的是 observe。它和 heal 不同:heal 会生成候选并在验证成功后更新脚本,而 observe 表示这个问题不适合或没必要立即修正,需要收集更多信息后再做决断。
为了让测试可以继续向下执行,我们让 AI 去尝试做无侵入的临时恢复,例如:重登录、刷新页面、重试当前步骤等操作。如果临时恢复成功,只重跑原步骤,不回写脚本;如果临时恢复失败,进入下面的隔离观察流程。
不适合临时恢复、需要进入 observe 流程的问题,通常有以下几种:
-
环境问题:网络抖动、 5xx、CDP 断开、浏览器崩溃。无法通过修改脚本解决。 -
偶发抖动:低频事件,根因不明。此时无法对症下药地进行修复。 -
已知问题:确认过的已知问题或限制。不需要再次生成修复方案。 -
未知失败:暂时没有足够信息,先继续观察,等后续补充更多证据。
步骤3. 归类为失败簇群跟踪处理
把同一条用例、同一种现象的反复失败,归类到同一个簇群。通过特定的算法采集指纹,使得具有共性的问题聚合到相同的簇群下,比如不同页面都在“点击按钮后等待元素”上超时,它们应该被看成一个问题,而不是多个孤立案例。
失败簇群按以下状态流转和处理:

active(常规) → flaky_watch(观察) → quarantined(隔离) → recovered(恢复) → active(常规)
另有一个 resolved 的终态,表示经人工确认标记为已解决。状态的流转过程如下:
-
首次失败进入 active状态,失败簇开始计数 -
连续失败达到阈值,进入 flaky_watch状态 -
观察后仍未恢复,进入 quarantined,此时会跳过相关脚本的执行 -
当手工或定时验证连续通过,进入 recovered状态;常规执行再通过,回到active -
经人工确认已解决,进入 resolved状态
如此,将治理对象从“某次失败”升级成了“同类故障”,解决了单次失败容易误判、各自被重复处理的问题。
步骤4. 知识沉淀
失败簇群走到终态后,系统会把它沉淀成以下两种可复用的知识:
resolved:问题被修复并验证通过,记录根因和解法。known_issue:确认是已知缺陷或外部不可控问题,生成规避方案。
知识先以草稿存在,经人工确认后发布。后续处理新的失败时,会按指纹检索已发布的知识:命中已知问题会直接改变问题分类和动作;其他根因、解法等结论性内容,作为提示词上下文提供给不同角色的智能体;同时记录使用结果,反馈并评估知识质量。
为什么隔离观察更可靠?
自动修复聚焦于“如何让当前脚本尽快通过”,隔离观察则着眼于“如何从最优视角统一处理共性问题”。隔离观察不立即修复问题,而是先收集足够证据,待问题根因和影响范围明确后再做决策,因此相对更为有效和可靠。

若无隔离观察机制,大量临时应急修复会不断累积,脚本愈发臃肿,知识库也无法沉淀出有效经验,自动化工具自然不会越用越“聪明”。
失败治理带来哪些收益?
引入隔离观察的失败治理至少带来三个好处:
-
可解释:每个失败都能说清楚表象、频度、根因和解决措施 -
可控:暂时隔离不拖垮当前持续集成过程,又能同时保持对共性问题的追踪 -
可积累:沉淀出用于指导未来工作的可复用知识,而不是收获一堆临时补丁
自动化测试失败治理真正追求的,从来不是零失败,而是让每一次失败都可解释、可追溯,并沉淀为可信的质量知识。如果自动化平台缺少完善的失败治理能力,AI 自愈只会掩埋当下的问题,转化为未来沉重的技术债务:脚本持续膨胀,测试绿灯的可信度持续衰减。反之,当失败能够被分类诊断、隔离观察、沉淀归档,自动化测试就不再只是用脚本替代人工执行用例那么简单,而是演化为一套持续迭代、自主学习的自动化测试AI智能体。
字节QA并进RD:不是测试被淘汰,而是分工开始融合
一张展开的软件智能化测试能力地图,每一个测试人员不得不看
一次实验:我们感受到离AI自主测试越来越近了
测试人,如何在AI时代活下来?