


【从零走向AGI】旨在深入了解通用人工智能(AGI)的发展路径,从最基础的概念起,逐步构建完整的知识体系。
项目地址🔗:https://ai-mzq.github.io/From-Zero-to-AGI/[1]
欢迎关注【魔方AI空间】👇
往期推荐:
-
一文讲透 AI 算力平台 8 个核心概念:GPU、显存、NVLink、InfiniBand、调度、存储、容器、监控 -
一文详解大模型 12 个核心机制:Token、Embedding、Attention、Transformer、MoE、预训练、后训练、对齐、RAG、工具调用、推理、评测
本文聚焦于大模型推理服务的 8 个核心指标:TTFT、TPOT、ITL、端到端延迟、吞吐、并发、请求率与 Goodput。文章从一次流式请求和整个服务系统两条线展开,帮助读者看懂各项指标的计算口径、吞吐与延迟之间的取舍,以及一份跑分能否真正用于框架选型和容量规划。
用同一个模型、同一张 GPU 分别做两次推理服务测试,结果可能截然不同。
第一次只发一个请求。用户很快看到第一个 token,后续文字连续出现,整段回答很快结束。
第二次提高并发。GPU 一次处理更多请求,系统每秒生成的总 token 明显增加,结果表里的吞吐更高了。但用户开始等待更久,文字输出时快时慢,一些请求远慢于平均值。
如果只看 output tokens/s,第二次测试表现更好;如果看 TTFT、ITL 和 P99,用户实际感受到的速度可能已经变慢了。
这是在线推理系统常见的取舍。连续批处理、请求调度和 KV Cache 管理可以提高硬件利用率,更大的批次和更多在途请求也会带来排队、资源竞争与请求间干扰。
评估一个大模型推理服务,需要同时回答两类问题:
· 对单个用户来说,多久开始回答,输出是否流畅,完整任务何时结束?
· 对整个系统来说,每秒来了多少请求,同时处理多少,又有多少按要求完成?
图 1 展示了同一套推理服务在低负载与高负载下的典型差异。
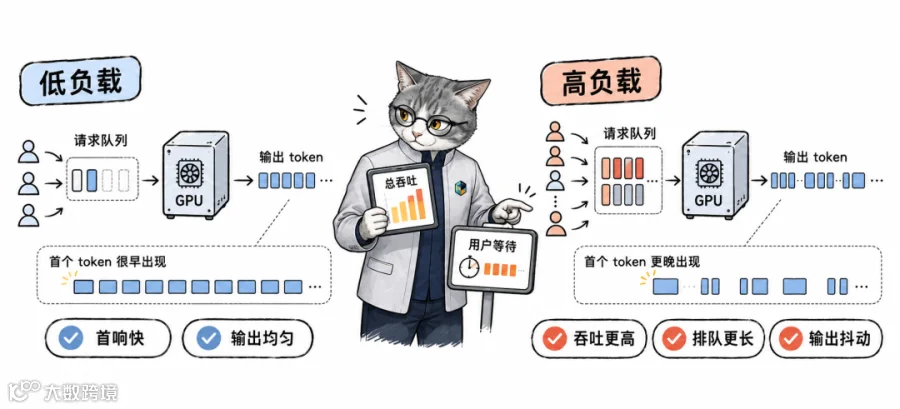
图 1:低负载下首 token 更快、输出更均匀;高负载能提高系统总吞吐,也会增加排队和输出抖动。
核心指标速览
第一类指标:TTFT、TPOT、ITL 与端到端延迟,位于一次流式请求的时间线上,这些指标在一次流式请求中的测量区间如图 2 所示。
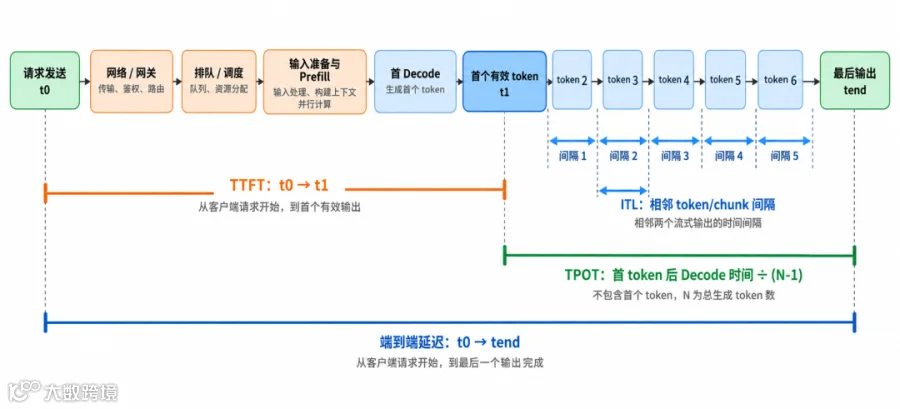
图 2:TTFT、TPOT、ITL 与端到端延迟在流式请求时间线中的测量范围。
第二类指标描述整个服务系统:请求率表示外部送来多少请求,并发表示多少请求仍在系统中,吞吐表示单位时间实际完成多少工作,Goodput 则统计其中有多少请求满足 SLO。
从系统视角看,请求率、并发、吞吐与 Goodput 的关系可以概括为图 3。
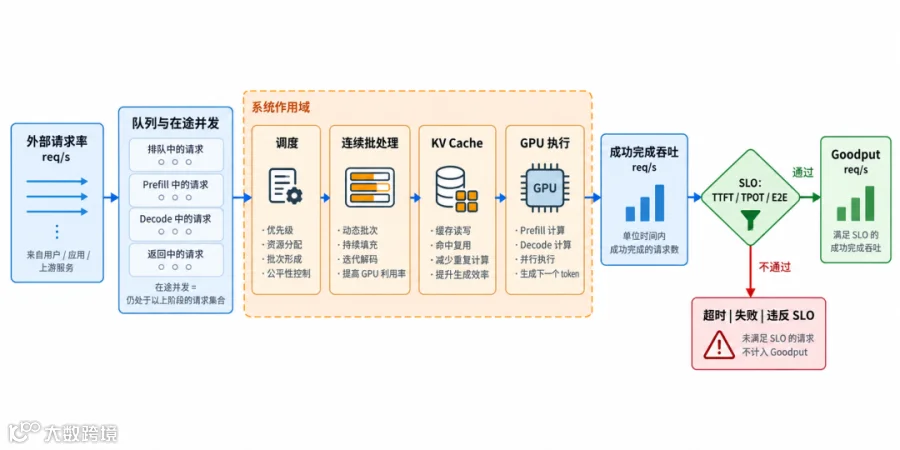
图 3:外部请求形成在途并发,系统执行产生完成吞吐,SLO 再从完成请求中筛出 Goodput。
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
TTFT、TPOT、ITL 和端到端延迟面向单次请求,最终需要比较它们的分布。请求率是进入系统的负载,吞吐是系统完成的工作;并发是仍停留在系统中的请求数量;Goodput 则在成功吞吐上增加延迟约束。
vLLM 的 Benchmark CLI 文档[2]明确提醒,LLM Serving 的指标术语并未在所有工具间完全标准化。跨报告比较时,公式和测量点比缩写本身更重要。
TTFT:用户要等多久才看到第一个 token
通俗理解:TTFT 测量的是从客户端发出请求,到收到第一个有效流式输出之间的时间。
TTFT 是 Time to First Token。对聊天、搜索问答、RAG 和 Agent 来说,它直接决定用户点击“发送”后要空等多久。
把 TTFT 直接理解为 Prefill 时间并不准确。从客户端观察,一次请求在第一个 token 到达前可能依次经过:
Prefill 会处理整段 Prompt,并建立后续生成所需的 KV Cache。输入通常越长,Prefill 工作越多。但在高负载下,请求可能先在队列中停留;启用 prefix cache 时,部分输入计算又可以复用。网络、网关、并行方式和 chunked prefill 也会改变客户端看到的 TTFT。
NVIDIA AIPerf 的指标文档[3]把 TTFT 定义在客户端请求开始与首个非空响应之间,并将网络、排队、Prompt 处理和首段输出纳入这一观测值。
服务端的 Prefill latency 适合诊断 GPU 执行与调度;客户端 TTFT 更接近用户感知。两者可以联合分析,不能直接画等号。
客户端 TTFT 与服务端 Prefill latency 的边界如图 4 所示。

图 4:客户端 TTFT 覆盖请求发出到首个有效输出的完整链路,Prefill latency 只对应服务端输入处理阶段。
测量 TTFT 时,还要注意:
· 空的 SSE 消息、角色字段或结束标记,不应被当作第一个有效 token;
· 重复使用相同 Prompt 可能命中 prefix cache,使后续轮次异常变快;
· 短 Prompt 测出的 TTFT,不能直接代表长上下文 RAG;
· 平均 TTFT 正常时,P95、P99 仍可能因为排队而明显升高。
TTFT 只能说明多久开始回答。首 token 很快,后面的文字仍可能断断续续,这要继续看 TPOT 和 ITL。
TPOT:首 token 之后,平均多久生成一个 token
通俗理解:TPOT 把首 token 之后的生成时间,平均摊到后续每个输出 token 上。
TPOT 是 Time Per Output Token。本文采用 vLLM 官方文档[2]中的请求级定义:
分母减 1,是因为第一个 token 已经计入 TTFT。假设一条请求在 200 ms 时收到首 token,在 1.2 s 时完整结束,总共输出 51 个 token:
对应的单请求平均生成速度约为:
TPOT 的分子与分母关系见图 5。
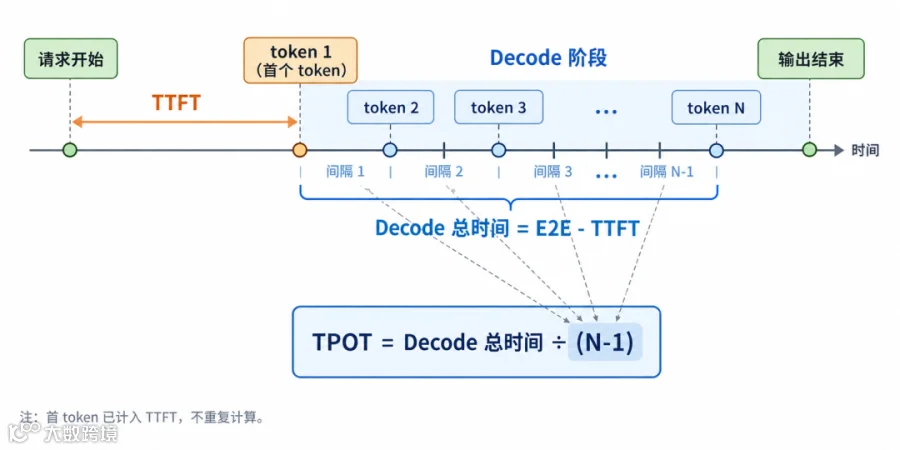
图 5:首 token 已计入 TTFT,因此后续 Decode 时间需要平均分摊到 N-1 个输出 token。
多请求测试通常先为每条请求计算 TPOT,再汇总均值、中位数和分位数。输出 token 数小于或等于 1 时,公式无法正常使用;不同工具可能跳过这类请求,也可能为了计算 Goodput 将其记为 0。
TPOT 接近用户看到的平均生成速度,但仍是一个平均值。Decode 的每一步都要读取已有 KV Cache,序列不断变长;batch、调度、显存带宽、量化和投机解码都会改变生成节奏。
还要分清两个经常被写成“tokens/s”的数字:
· 1 / TPOT 描述单条请求或单个用户看到的平均生成速度;
· aggregate output tokens/s 描述所有并发请求合计的系统产出。
系统总 tokens/s 上升时,单个用户的 TPOT 仍可能变大。
ITL:平均速度相同,输出仍可能卡顿
通俗理解:ITL 记录相邻流式输出之间的间隔,用来观察输出是否均匀、是否出现停顿。
ITL 是 Inter-Token Latency。在理想的逐 token 流式返回中:
假设两条请求都生成 50 个 token,总 Decode 时间也相同。
第一条每隔约 20 ms 返回一个 token;第二条先停顿 200 ms,随后快速补回一串 token,再发生下一次停顿。它们的平均 TPOT 可能接近,但第二条的阅读体验明显更差。
图 6 对比了平均 TPOT 接近、但 ITL 分布明显不同的两条请求。
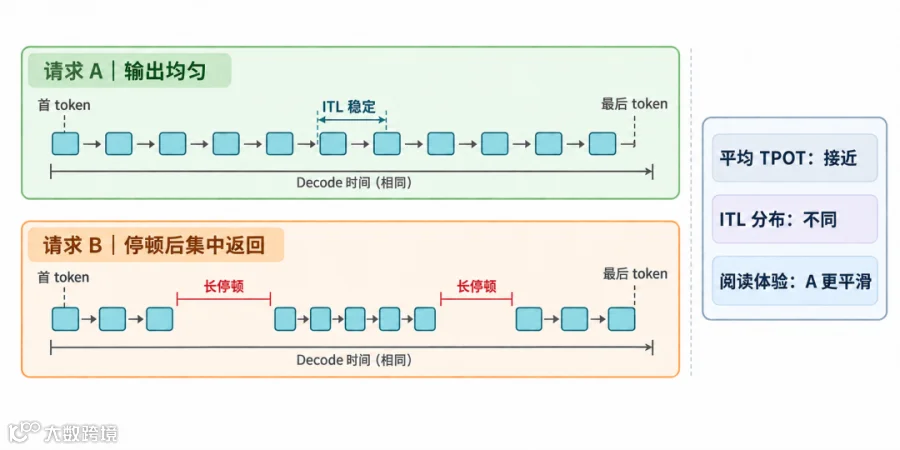
图 6:平均生成速度相近时,长停顿和集中返回仍会造成完全不同的流式阅读体验。
真实 API 通常按 chunk 返回数据,并不承诺每个响应只包含一个 token:
· 标准 Decode 下,一个 chunk 经常对应一个 token,但并非必须如此;
· 投机解码可能在一个 engine step 中接受并返回多个 token;
· 代理层、网络缓冲和客户端 SDK 也可能合并流式响应。
vLLM 当前文档[2]把 TPOT 定义为每条请求的平均值,把 ITL 样本定义为相邻流式输出之间的间隔。投机解码一次返回多个 token 时,ITL 只看到 chunk 之间的空隙,TPOT 仍将 Decode 时间摊到所有输出 token 上。
NVIDIA NIM 的指标说明[4]也展示了把 Decode 阶段平均 token 间隔称为 ITL/TPOT 的常见用法。比较结果时,必须先看公式、chunk 处理和聚合顺序。
ITL 尤其适合暴露 generation stall。Sarathi-Serve[5]讨论了长 Prefill 对正在执行的 Decode 带来的干扰,并通过 chunked prefill 和调度减轻吞吐与延迟之间的冲突。平均 TPOT 正常时,P99 ITL 仍可能暴露长停顿。
测量 ITL 时,需要写清三个问题:记录的是 token gap 还是 chunk gap;分位数基于全部间隔样本,还是先按请求统计;流式协议、代理层和客户端 SDK 是否相同。
端到端延迟:一次请求何时完整结束
通俗理解:端到端延迟从请求发出开始,一直量到最后一个有效输出到达客户端。
端到端延迟常写作 E2E latency 或 request latency:
在普通的逐 token 自回归生成中,如果 TTFT、TPOT 和 token 计数采用一致口径,可以近似写成:
图 7 同时标出了端到端延迟的测量区间和异常请求的统计分叉。

图 7:E2E 从请求发出一直量到最后有效输出;超时、取消和失败是否纳入统计,需要事先明确。
端到端延迟最接近“这项任务什么时候彻底结束”,也最容易受输出长度影响。
一份 30 token 的短回答和一份 1000 token 的代码生成结果,即使使用同一个模型、同一套服务,E2E 也不会处在同一量级。如果两个系统的停止条件不同,一个提前结束、另一个生成更完整,仅比较 E2E 很难得出公平结论。
非流式请求通常只能从客户端直接观察 E2E,无法可靠拆出 TTFT 与 ITL。聊天产品可能更关注首 token 和持续输出;代码生成、文档生成或批处理任务则更关心完整完成时间。
失败、超时和取消的请求是否进入统计,也会改变结果。系统过载后,如果大量慢请求超时并被排除,只统计剩余的成功请求,平均 E2E 甚至可能变好,这属于幸存者偏差。
分位数同样不能直接相加:
这些 P99 可能来自不同请求,输出长度也可能不同。公式可以连接单条请求的测量区间,不能直接连接各自的总体分位数。
吞吐:同为 tokens/s,统计对象可能不同
通俗理解:吞吐描述整个系统单位时间完成的工作量,但工作量可以按请求、输入 token、输出 token 或总 token 计算。
“吞吐达到 5000 tokens/s”是一句信息不完整的话。至少还要确认这 5000 个 token 指什么。
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
requests/s 会被请求长度强烈影响。每条请求只生成 20 个 token,与每条生成 1000 个 token,单位时间能完成的请求数自然不同。
output tokens/s 聚焦 Decode 产出,不能完整描述长 Prompt 带来的 Prefill 压力。total tokens/s 把输入和输出放在一起,但一个输入 token 的 Prefill 计算和一个输出 token 的 Decode 计算也不是简单等价的工作量。
单用户速度与系统总吞吐的区别,可以通过图 8 的算例直观看出。
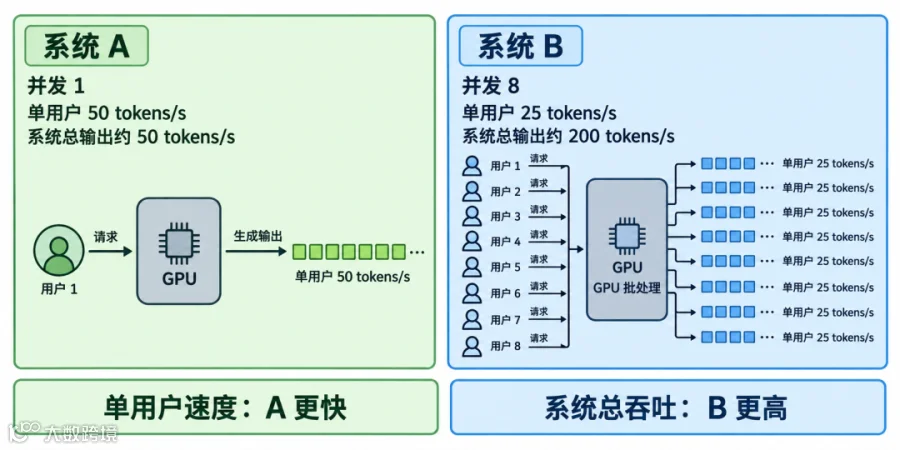
图 8:系统 B 的单用户生成速度更慢,但借助更高并发获得了更高的系统总输出吞吐。
推理引擎利用连续批处理,让新请求加入正在运行的批次,提高 GPU 利用率。vLLM/PagedAttention 论文[6]通过更灵活的 KV Cache 管理减少内存浪费,为容纳更多请求和提高吞吐创造空间。
这些技术改变的是吞吐—延迟曲线。批次扩大后,系统总 tokens/s 可能上升;请求等待调度的时间、每个用户分到的执行机会和尾部延迟也可能改变。
一份吞吐结果至少要注明:
· 是 requests/s、input、output 还是 total tokens/s;
· 采用什么并发或请求率;
· 输入、输出长度怎样分布;
· 测试是否进入稳态;
· 失败、取消和超时请求如何处理。
并发:此刻有多少请求仍在系统中
通俗理解:并发表示同一时刻有多少请求还没有结束,包括排队、Prefill、Decode 和返回中的请求。
并发经常被误写成“每秒请求数”,但它本身没有“每秒”这个时间单位。
固定并发的闭环测试会先发出 C 个请求,每当一条请求结束,立刻补上一条,尽量保持 C 个请求在途:
闭环并发与开环请求率的负载生成方式见图 9。
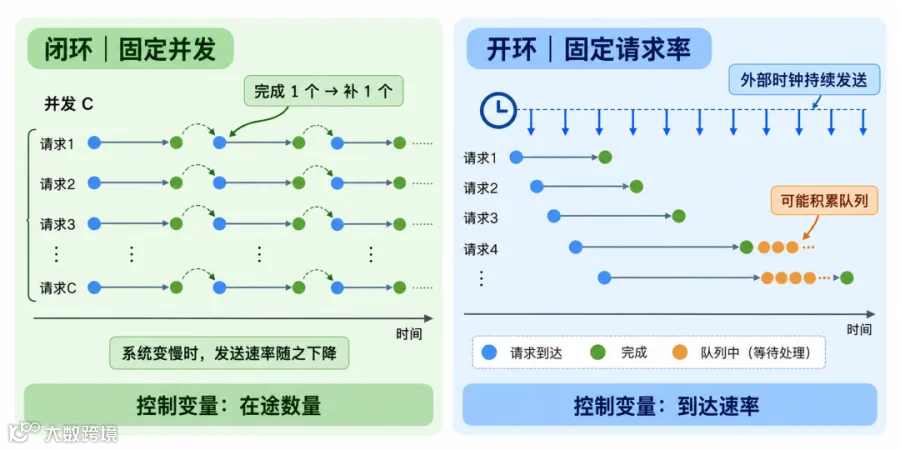
图 9:闭环测试由请求完成事件补充负载,开环测试由外部时钟持续发出请求。
提高并发能给调度器提供更多批处理候选,系统吞吐通常会在一段区间内上升。但并发不等于 GPU batch size:有的请求仍在排队,有的在 Prefill,有的在 Decode,还有的可能等待 KV Cache 空间或网络返回。
并发继续增加后,系统可能出现:
· 队列变长,TTFT 上升;
· KV Cache 占用增加,同时驻留的序列接近上限;
· Prefill 与 Decode 相互干扰;
· 每条请求获得执行机会的间隔增大;
· 吞吐逐渐接近平台上限,尾延迟继续恶化。
在稳定的观测窗口内,Little 定律可以解释请求率、并发与响应时间的关系:
即使请求进入速度不变,只要平均响应时间变长,系统里的在途请求也会增加。因此,高并发既可能意味着更多用户同时发起请求,也可能意味着请求在系统里停留得更久。
客户端 worker 数、最大连接数、服务端 active sequences、scheduler batch size 和最大并发,也不是同一个量。
请求率:外部每秒向系统送来多少请求
通俗理解:请求率描述负载发生器或真实用户每秒发起多少请求,它是输入压力,不是系统已经完成的工作量。
请求率常写作 request rate、arrival rate 或 offered QPS:
低负载、系统稳定时,两者可能接近。请求率逐渐逼近容量上限后:
1. 外部仍按照既定节奏发送请求;
2. 系统完成吞吐接近上限,不再同比增长;
3. 新请求进入队列,并发和 TTFT 上升;
4. 超时、取消、拒绝和错误开始增加。
请求率接近系统容量时,吞吐与延迟通常会出现图 10 所示的分化。
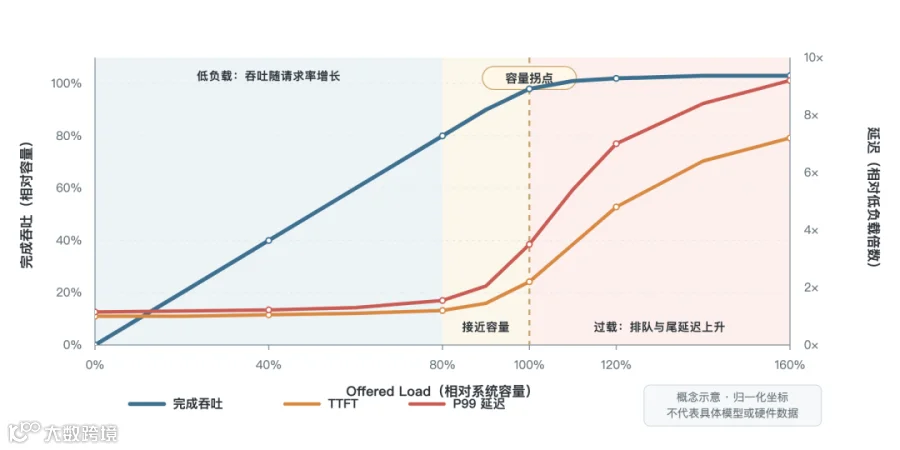
图 10:完成吞吐在容量拐点附近趋于饱和,而 TTFT 与 P99 延迟继续上升。图中曲线为概念示意。
固定并发属于闭环:系统变慢后,请求完成得更慢,负载发生器补充新请求的速度也会下降。固定请求率属于开环:无论系统变快还是变慢,外部时钟仍按计划发送请求,更适合观察过载时的队列增长。
请求率相同,到达模式不同,结果也可能不同。NVIDIA AIPerf 的负载模式文档[7]列出了 constant、Poisson、gamma 与 concurrency burst 等方式:
· constant 让请求以固定间隔到达,便于回归比较;
· Poisson 到达带有随机间隔,是常见在线服务建模方式;
· gamma 可以调节流量的平滑或突发程度;
· burst 会在短时间集中施压,适合观察瞬时排队和保护机制。
MLPerf Inference 的 Server 场景[8]也使用目标 QPS 和 Poisson 到达生成服务负载。重点不在于所有生产流量都服从某一种分布,而在于报告必须说明负载如何到达。
客户端还不一定真的能达到目标请求率。负载发生器的 CPU、连接池、网络或实现本身可能先成为瓶颈,因此测试要同时记录目标 request rate 和实际发送速率。
Goodput:有多少请求按要求完成了
通俗理解:Goodput 统计单位时间内成功完成、并且满足指定性能约束的请求数。
吞吐关心完成了多少,Goodput 还要检查完成得是否足够快:
假设一个聊天服务规定:
一条请求只有同时满足这些条件,才会计入 Goodput。vLLM 的 serving benchmark 源码[9]支持按 TTFT、TPOT 和 E2E 阈值筛选请求,再计算满足约束的完成率。
图 11 说明了 raw throughput 接近时,Goodput 仍可能存在明显差距。
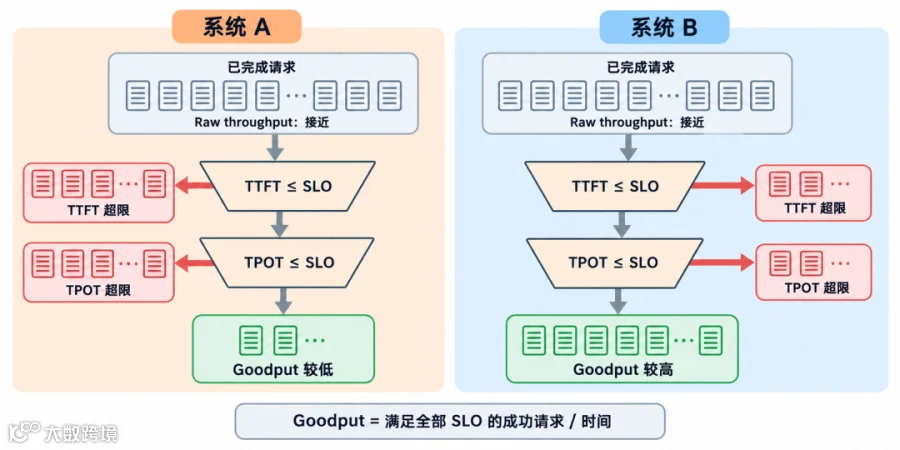
图 11:采用相同 SLO 筛选时,违规请求更少的系统能够获得更高 Goodput。
Goodput 会随输入输出长度、请求到达模式和 SLO 阈值变化,并不是一块 GPU 的固定属性。两个结果只有在模型、负载、阈值与统计规则一致时才可比较。
DistServe[10]将 TTFT 与 TPOT 约束纳入系统容量目标,关注在延迟要求下能够服务的最大请求率。如果 raw throughput 上升,但大量请求已经违反首响或生成速度要求,新增的完成量并没有改善实际体验。
Goodput 通常还要配合 SLO attainment:
NVIDIA AIPerf 的 Adaptive Scale 文档[11]也将 quality goodput 与 TTFT、ITL、请求延迟等过滤条件关联起来。报告 Goodput 时,至少要同时给出阈值、Goodput 数值和通过比例。
随着 offered load 继续增加,三项指标的变化关系见图 12。
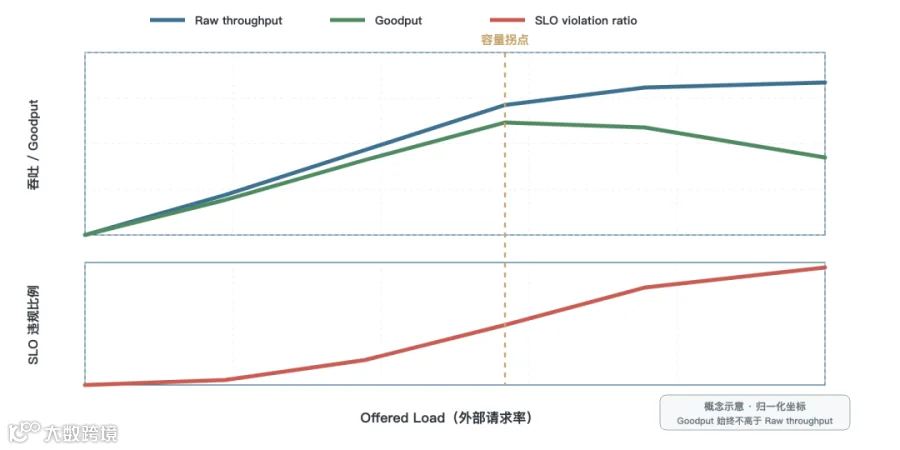
图 12:系统接近容量上限后,Raw throughput 仍可能保持高位,Goodput 却会因 SLO 违规增加而趋平或下降。
如果压测系统主动丢弃预计会超时的请求,或者把失败、取消和空输出排除在分母之外,Goodput 也可能被美化。关于 SLO 与 Goodput 口径的研究[12]专门讨论了这类问题。
Goodput 报告必须写清:
· 哪些 SLO 需要同时满足;
· 失败、超时、取消和主动丢弃如何统计;
· 统计窗口从何时开始、何时结束;
· 输出有效性或质量是否也被检查。
负载上升时,8 个指标怎样变化
随着负载上升,系统通常会经历以下变化:
1. 请求率增加,更多请求进入系统;
2. 排队与活跃请求增多,并发上升;
3. 调度器获得更多批处理机会,GPU 利用率和系统吞吐提高;
4. 接近容量上限后,完成吞吐逐渐饱和;
5. 排队拉高 TTFT,Prefill 与 Decode 干扰可能影响 TPOT 和 ITL;
6. 端到端延迟和尾延迟继续上升;
7. 违反 SLO 的请求变多,Goodput 趋于平稳甚至下降。
8 个指标之间的主要因果关系汇总在图 13 中。

图 13:请求率和在途并发形成系统负载,调度与执行影响延迟和吞吐,SLO 再从成功吞吐中筛出 Goodput。
Prefix cache、chunked prefill、投机解码、量化、并行方式以及 Prefill/Decode 分离都会改变曲线形态。
Prefill 通常更偏计算密集,Decode 常更容易受到显存带宽和 KV Cache 访问影响,实际瓶颈仍取决于模型、硬件、batch 和序列长度。评价一项优化时,需要同时说明它在哪种负载下改善了哪个指标,以及其他指标发生了什么变化。
P50、P95、P99:平均值正常,不代表每个用户都正常
假设 99 个请求在 500 ms 内拿到首 token,另一个请求等了 20 秒。一个平均值很难说明多少用户遇到了异常等待。
在线服务通常同时报告:
· P50:一半请求不超过这个值,代表较典型的体验;
· P95:95% 请求不超过这个值;
· P99:99% 请求不超过这个值,用来观察尾部慢请求。
平均值接近时,CDF 仍能揭示两套系统不同的尾延迟,如图 14 所示。
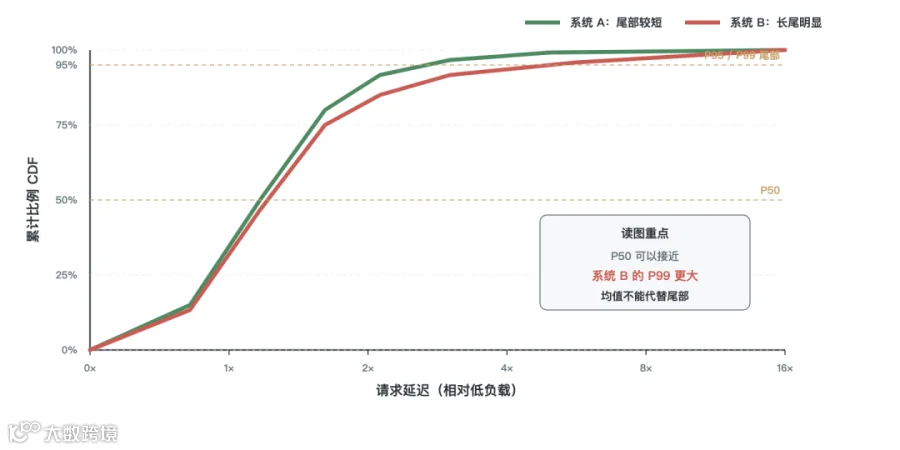
图 14:两套系统的主体延迟可以接近,但系统 B 的长尾会使 P95、P99 明显增大。图中曲线为概念示意。
排队、长 Prompt、缓存未命中、批处理干扰和节点差异常常先出现在尾部。对于生产容量规划,P95、P99 往往比均值更能暴露服务接近饱和后的风险。
分位数也要注明口径:
· TTFT、TPOT、E2E 通常每条请求先得到一个数,再跨请求求分位数;
· ITL 可以汇总所有 token/chunk 间隔,也可以先按请求计算,再跨请求统计;
· P99 必须配合样本量,几十条请求很难稳定估计尾部;
· 不同指标的 P99 可能来自不同请求,不能简单相加。
一份更有用的结果至少应包含:
一份推理服务 benchmark,至少要交代什么
看到一张性能对比表,可以先检查五类信息。
模型与执行配置
· 模型名称、版本、参数规模与架构;
· 权重精度、量化方式、KV Cache dtype;
· GPU 型号、数量、显存与互联;
· 推理框架、版本、并行和关键调度参数。
工作负载
· 使用真实数据集还是合成 Prompt;
· 输入与输出长度的均值、分位数和分布;
· 请求数量、测试时长和预热方式;
· 是否流式返回,采样参数和停止条件是否一致;
· prefix cache 是否启用,命中方式是否相同。
负载模式
· 使用固定请求率还是固定并发;
· 请求率、并发上限、到达分布和突发程度;
· 客户端是否真的达到目标发送速率;
· 测试是否进入稳态,过载时队列怎样处理。
指标口径
· 时间戳在客户端还是服务端采集;
· TTFT、TPOT、ITL 和 E2E 的计算公式;
· 一个流式 chunk 可能包含多少 token;
· throughput 指 requests、input、output 还是 total tokens;
· 分位数基于哪些样本、采用怎样的聚合顺序。
失败与质量
· HTTP 错误、超时、取消、空输出和重试怎样处理;
· Goodput 使用哪些 SLO,是否要求同时满足;
· 输出正确性、模型质量或精度是否保持可比。
MLPerf LoadGen[13]把负载生成、时间记录和性能约束放进一套可复现流程。普通 LLM Serving 测试不必照搬其所有规则,但同样要让别人知道请求怎样产生、结果怎样记录、约束怎样判定。
以下五类结果不能直接比较:
1. 模型或量化精度不同,只比较 tokens/s;
2. 一组结果来自固定并发,另一组来自固定请求率;
3. 一侧命中 prefix cache,另一侧没有相同复用条件;
4. 输出长度不同,却直接比较 E2E 与吞吐;
5. 只统计成功请求,不报告过载时的失败、超时与未完成请求。
最后:先定义体验,再计算系统容量
回到开头的两次测试。
第二次测试获得了更高的总吞吐,这个结果可能完全正确。但它只说明系统在那组负载下,每秒生成了更多 token。用户等待多久、输出是否均匀、慢请求有多少,还需要 TTFT、TPOT、ITL、端到端延迟与分位数回答。
一次流式请求里:
整个服务里:
容量规划最终要回答的是:
在真实的输入输出分布和目标 SLO 下,这套系统每张 GPU 能稳定服务多少请求?
当模型、硬件、工作负载、测量口径和 SLO 都被写清楚后,TTFT、TPOT、ITL 与 tokens/s 才能共同说明这套服务在真实业务中能否稳定运行。
► 从零走向 AGI 系列
► 技术专栏: 多模态大模型最新技术解读专栏 | AI 视频最新技术解读专栏 | 大模型基础入门系列专栏 | 视频内容理解技术专栏 |
参考链接
1. https://ai-mzq.github.io/From-Zero-to-AGI/:https://ai-mzq.github.io/From-Zero-to-AGI/
2. vLLM 的 Benchmark CLI 文档:https://github.com/vllm-project/vllm/blob/main/docs/benchmarking/cli.md
3. NVIDIA AIPerf 的指标文档:https://docs.nvidia.com/aiperf/dev/reference/ai-perf-metrics-reference
4. NVIDIA NIM 的指标说明:https://docs.nvidia.com/nim/benchmarking/llm/latest/metrics.html
5. Sarathi-Serve:https://www.usenix.org/conference/osdi24/presentation/agrawal
6. vLLM/PagedAttention 论文:https://arxiv.org/abs/2309.06180
7. NVIDIA AIPerf 的负载模式文档:https://docs.nvidia.com/aiperf/dev/tutorials/load-patterns-scheduling/request-rate-with-max-concurrency
8. MLPerf Inference 的 Server 场景:https://github.com/mlcommons/inference_policies/blob/master/inference_rules.adoc
9. vLLM 的 serving benchmark 源码:https://github.com/vllm-project/vllm/blob/main/vllm/benchmarks/serve.py
10. DistServe:https://arxiv.org/abs/2401.09670
11. NVIDIA AIPerf 的 Adaptive Scale 文档:https://docs.nvidia.com/aiperf/latest/tutorials/metrics-analysis/adaptive-scale
12. 关于 SLO 与 Goodput 口径的研究:https://arxiv.org/abs/2410.14257
13. MLPerf LoadGen:https://github.com/mlcommons/inference/blob/master/loadgen/README.md