

文献来源
论文: Accelerating protein design by scaling experimental characterization
作者: Jason Qian、Lukas F. Milles、Basile I. M. Wicky、Robert J. Ragotte、David Baker 等
期刊: Nature Communications,2026
DOI: 10.1038/s41467-026-76740-9
这项工作是一项围绕实验规模化基础设施展开的方法学工作:作者认为,de novo protein design 的计算能力已经快速增长,但传统蛋白表达、纯化和生化表征仍然以几十个样品、数天到数周为单位运行,实验验证正在成为蛋白设计的新瓶颈。
摘要
过去几年,RFdiffusion、ProteinMPNN 等方法大幅提高了蛋白设计的生成速度,但计算机一次给出数百甚至数千个候选之后,真正限制项目迭代速度的往往变成 DNA 构建、蛋白表达、纯化和表征。Baker 团队因此开发了 SAPP(Semi-Automated Protein Production) 和 DMX(Demultiplexing) 两套互补流程:前者将从基因片段到 SEC 纯化蛋白及标准化表征压缩到约 48 小时,并能每天处理数百个设计;后者利用组合条形码和 Nanopore 长读长测序,把低成本 oligo pool 转换为数千个序列验证后的阵列化克隆。作者进一步用荧光蛋白重设计和 RSV 中和蛋白优化证明,这类实验基础设施不仅提高 throughput,更能暴露计算设计无法可靠预测的表达性、聚集状态、寡聚装配和功能差异。其更深层意义,是为未来 design–build–test–learn 和主动学习型蛋白设计提供标准化实验数据接口。
1. 为什么这篇论文值得关注?
蛋白设计正在经历一个很有意思的瓶颈转移。过去困难的是如何找到合理的序列和结构;现在,随着结构生成、sequence design 和 binder design 方法快速发展,研究者很容易产生远超实验容量的候选。问题因此从搜索空间中找不到设计,逐渐转变为设计太多,却没有足够便宜、快速且标准化的实验去判断哪些是真的好。
传统 arrayed protein biochemistry 的优势是信息丰富:你不仅知道一个蛋白是否结合,还能获得表达量、可溶性、聚集情况、寡聚状态、SEC 峰形以及后续功能数据。但代价是慢。论文指出,经典流程通常需要克隆、单菌落挑选、测序验证、重新转化、摇瓶表达、纯化和逐样本分析,测试几十个设计就可能花费数周。另一条路线是 yeast display 等 pooled assay,虽然一次可以筛选成千上万甚至百万序列,却通常针对某一个特定 readout,而且很难告诉你每个蛋白最终是否容易表达、纯化以及形成正确的溶液状态。
因此,这篇论文解决的并不是“怎样再设计一个更好的蛋白”,而是一个更基础的问题:能否让 arrayed、可获得真实蛋白样品的实验流程,也进入百到千级规模?
作者进一步指出,只有当不同设计都以统一流程产生结构化实验数据时,这些数据才更适合进入机器学习和主动学习闭环。换句话说,SAPP 的价值不只在自动化,它还在尝试把湿实验从“项目结束后的验证步骤”变成可以持续产生机器可读训练数据的系统。
2. 论文到底做了什么?
整项工作实际上由两个互补模块组成。
SAPP 解决的是:已经有一批设计序列后,怎样快速得到真实蛋白以及统一的生化表征结果。
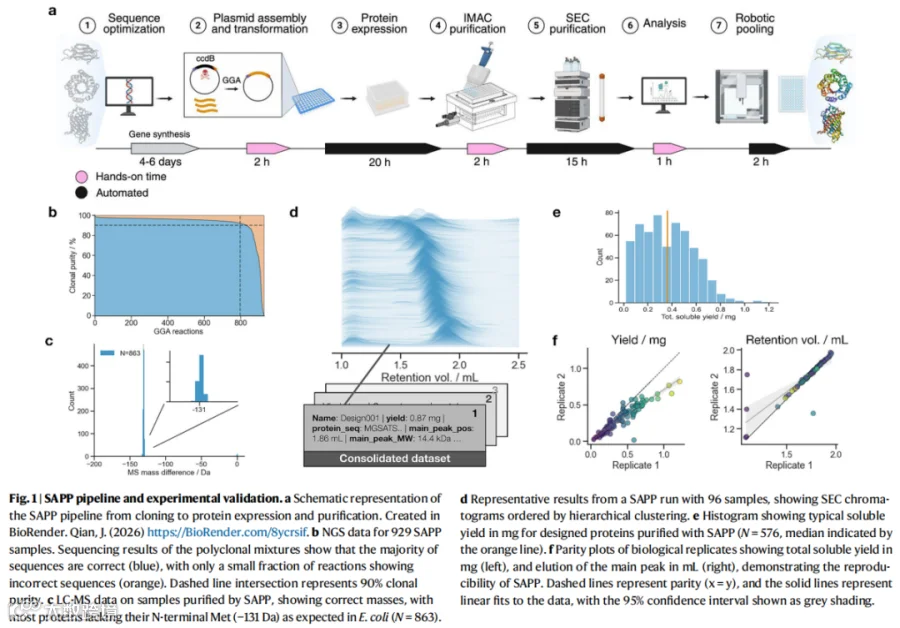
它把序列设计、DNA 构建、直接转化表达、96 孔板培养、亲和纯化、SEC、数据分析和样品归一化串成一条流水线。论文第 2 页的 Fig. 1 很直观地展示了这条链路:从 sequence optimization 到 plasmid assembly、expression、IMAC、SEC、自动分析以及最终 robotic pooling,人工参与主要集中在几个短时间窗口,其余步骤尽量批量化或自动运行。
DMX 则解决另一个瓶颈:当实验规模继续扩大时,最贵的已经不再是纯化,而是每条设计单独购买 gene fragment。作者于是利用廉价 oligo pool、组合条形码和 Nanopore sequencing,把混合 DNA library 重新拆分成阵列化、sequence-verified 的克隆,再送入 SAPP。
所以 SAPP 解决蛋白层面的 throughput,DMX 解决DNA 层面的成本与扩容。两者组合之后,才形成比较完整的规模化 protein design experimental stack。
3. 方法细节:SAPP 真正改变了哪些步骤?
3.1 第一处关键设计:主动舍弃传统克隆流程中的一部分“绝对确定性”
传统工作流默认每个 expression plasmid 必须先经过单菌落分离和测序确认。这个逻辑非常稳妥,却也是最难并行化的环节之一。
SAPP 的策略更激进:作者先用软件将 amino-acid sequence 自动反向翻译,利用 DNA Chisel 同时优化 codon adaptation、重复序列、限制性内切酶位点和异常起始位点,并通过供应商接口检查 synthesizability;较长序列还会自动拆分成兼容 Golden Gate Assembly 的片段。
随后,gene fragment 直接通过 Golden Gate Assembly 装入带有 ccdB negative-selection cassette 的 entry vector。只有正确替换 ccdB 的载体才能高效产生存活细胞,因此背景被大幅压制,GGA 产物可以直接转入 E. coli expression strain,而不再经历“转 cloning strain → 挑单菌落 → 测序 → 再转 expression strain”的经典路线。
这一步是 SAPP 加速的核心。
代价也很明确:样本可能存在 polyclonality。作者因此没有假设它绝对正确,而是对 929 个反应进行 NGS,发现对于长度低于 314 bp 的 insert,89.3% 样品的 clonal purity ≥90%;随后对 863 个纯化蛋白进行 intact-mass analysis,90% 的产物在 ±1 Da 范围内具有预期分子量。因此,这条路线适合高通量 screening,却不能简单等同于需要绝对 sequence certainty 的最终生产流程。
这一点非常值得注意:作者并没有试图把每一步做到最严谨,而是在筛选阶段允许有限错误率,以换取数量级的 throughput 提升。
3.2 第二处关键设计:把 SEC 从“少数候选的最终检查”变成所有设计的标准 readout
很多高通量蛋白筛选最终只做到 SDS-PAGE。但 SDS-PAGE 告诉你的主要是有没有蛋白,却很难判断 native oligomeric state、aggregation 和 dispersity。
SAPP 选择了一条成本更高但信息量也更大的路径:每个设计都直接进行 SEC。
蛋白首先在 96 deep-well plate 中使用 auto-induction media 表达,避免依赖培养 OD 决定 IPTG induction 的人工步骤;细胞裂解后通过 96 孔 Ni-NTA affinity purification,再进入带 autosampler 的 SEC 系统。每个样品不到 5 分钟,192 个样品约 15 小时即可跑完。
真正重要的是后面的软件层。作者开发 Python pipeline 自动检测 chromatographic peaks,并根据标准曲线、A280 和 sequence-specific extinction coefficient 提取 total soluble yield、polydispersity、estimated molecular weight、aggregation state 以及需要 pooling 的 fraction,最终汇总为统一的数据文件。
因此 SAPP 的输出并不是“96 支蛋白”,而是:
protein sample + standardized biochemical phenotype。
典型产量约为 0.1–0.5 mg、浓度 10–100 μM,已经能够支持大量常规 binding、stability、activity 甚至结构生物学下游实验。论文估算单台 chromatographic instrument 的主要瓶颈约为每天 300 个样品。
4. DMX:怎样把便宜的 oligo pool 重新变成数千个“知道身份”的独立克隆?
SAPP 跑快以后,新的成本瓶颈出现了:单独购买成百上千条 gene fragments 太贵。
DMX 的目标就是把低成本 oligo pool 变成arrayed + clonal + sequence-verified 的菌株库。
论文第 6 页 Fig. 4 给出了完整流程:先把 oligo pool 克隆进专门设计的 DMX vector,转化并挑取 colony;随后将不同位置的培养物组合编码,在 cell lysate 中直接完成 isothermal Golden Gate barcoding;最后将全部样品重新混合,使用 Oxford Nanopore 长读长测序同时读出 barcode 和 gene-of-interest,再由 bioinformatics pipeline 将序列重新映射回具体孔位,自动生成最终 re-array pick list。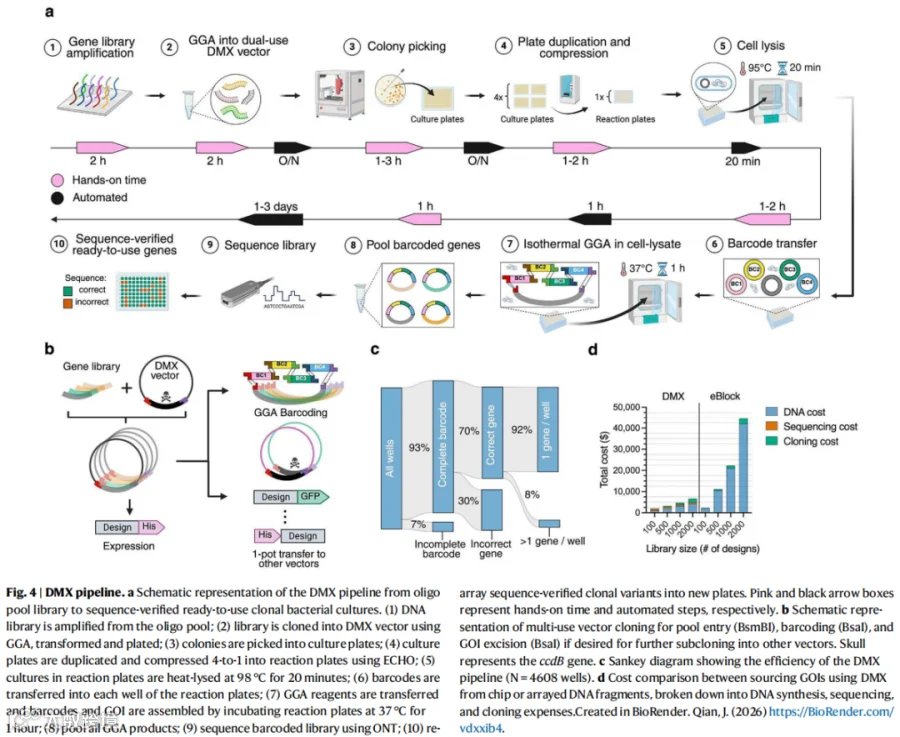
这里最巧妙的设计是 barcode 组合。作者构建四组 position-specific barcode,每组 24 个 UMI,因此理论组合容量达到:
也就是说,只需要四套 24-member barcode 就能编码超过 33 万个位置。更重要的是 barcoding 直接在 bacterial lysate 中通过等温 GGA 完成,不需要为成千上万个样品分别进行 indexed PCR;随后采用 Nanopore long-read sequencing,又避免了 Illumina short-read 对 GOI 长度的限制。
在一个包含 1500 条、长度 275–400 bp 的 de novo protein library 中,作者筛选 4608 个 colony,最终回收了 78% 的 sequence-verified library variants,接近在合成误差、sampling depth 和 library bias 条件下估算的 92% 理论上限。对于较大规模实验,作者估计约 2000 个 gene 的 library 配合约 8000 个 colony 可以获得超过 95% 的 recovery;相比逐条购买 gene fragment,500 和 2000 design 的方案分别可降低约 5 倍和 8 倍成本。
5. 实验到底证明了什么?
真正决定这篇论文说服力的,不是流水线能否跑通,而是跑得快以后是否真的能改变蛋白设计项目的结果。
第一组案例是 fluorescent protein redesign。作者利用 ProteinMPNN 对多种 fluorescent protein 进行大幅序列改造,同时固定 chromophore residues、部分高度保守残基和核心残基,再用 AlphaFold2 等指标预筛设计。最终测试了 96 个构建体,并在一周内得到全部实验结果。部分重设计蛋白表现出比 WT 更高的热稳定性,甚至在 95 °C 加热 1 小时后仍保持 monomeric SEC profile;另一些设计出现 Stokes shift 等光谱变化。
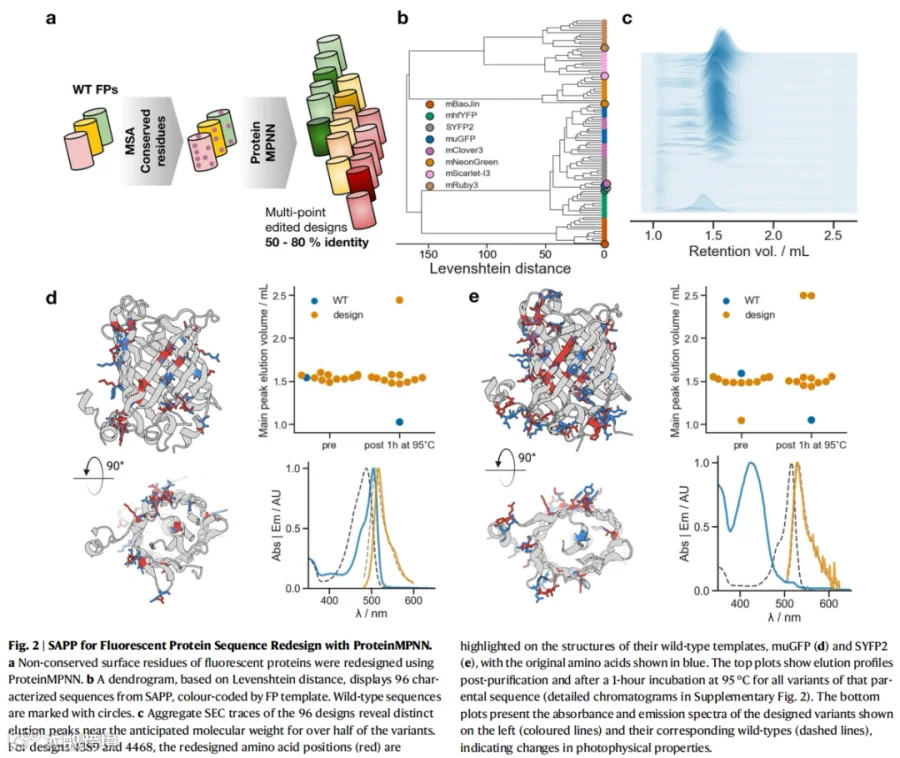
这说明 SAPP 可以处理的不只是“是否表达”这一维,而是能够快速采集表达、SEC、热稳定性、吸收和荧光性质等多维 phenotype。
第二组 RSV 实验则更有说服力。
作者先获得 de novo RSV F minibinder cb13,其 binding affinity 为 35 nM;cryo-EM 结构显示设计模型与实验结构的 binder Cα RMSD 约为 1.9 Å。随后他们不是继续单纯优化 sequence,而是系统筛选 oligomerization geometry:不同 valency、不同 domain spacing、N/C-terminal fusion 都被作为设计维度。
结果非常有意思。单体 cb13 的病毒中和 约为 5.4 nM,而两个筛出的 oligomeric constructs 分别达到 40 pM 和 59 pM。但这并不意味着 valency 越高越好:相同 cb13、相同 dimeric valency,不同 geometry 的两个 construct 可以相差约 25 倍;同一个 trimerization domain,仅仅交换 binder 位于 N 端还是 C 端,活性也能相差约 10 倍,而 C6、C8 等更高阶 multimer 反而没有获得明显提升。
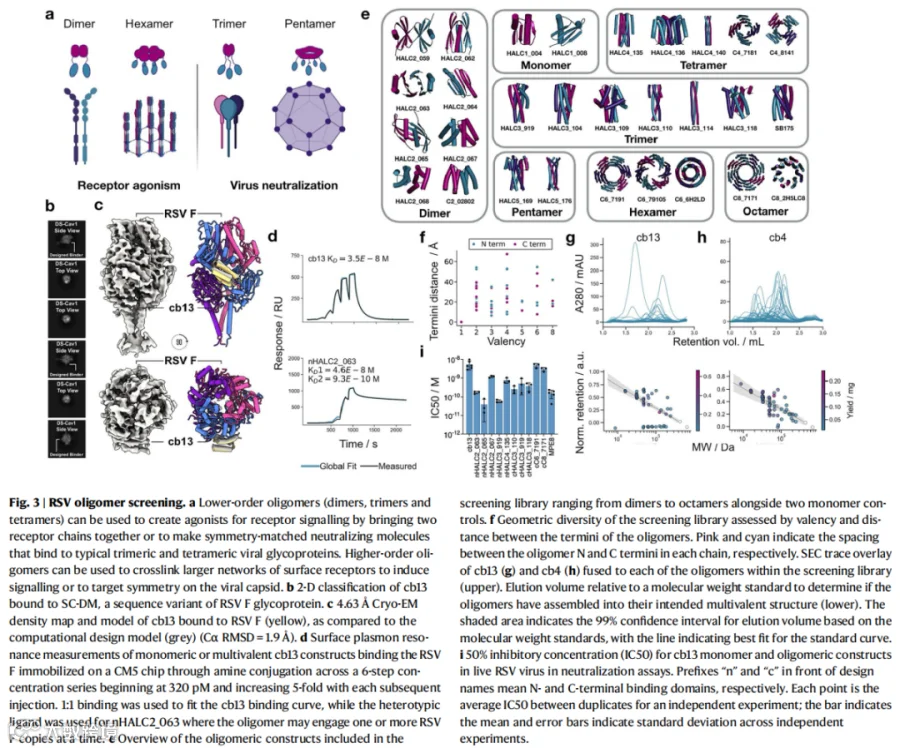
这组实验实际上给出了这篇论文最有价值的科学信息之一:
在蛋白工程中,很多决定最终功能的变量并不能可靠地从单一计算打分中直接推出,只有当实验 throughput 足够高,geometry、valency、orientation 等变量才真正可以被系统搜索。
6. 这项工作的真正价值在哪里?
第一,它让实验开始具有和计算设计类似的“搜索能力”。过去实验经常只是验证 Top 5、Top 10;SAPP 的逻辑则更接近把几十种 geometry、sequence 或 architecture 都变成可枚举变量,再让真实实验决定哪一个方案成立。
第二,它把失败样本也变成了有价值的数据。一个 design 不表达、形成 aggregate、SEC 峰异常或者 oligomerization 错误,以前往往只被记录为“失败”。当这些结果通过同一套 pipeline 自动转化为统一 dataframe 后,它们就可能成为训练 manufacturability、solubility、assembly quality 等模型的数据来源。作者也明确提出,这种标准化 output 有机会支持 active learning 和 closed-loop protein design。
第三,这项工作提醒我们:protein design 的下一阶段不一定只取决于生成模型还能提高多少,而可能取决于实验数据产生速度能否同步增长。 当模型已经能够生成上万条候选时,一个每天只能测试十几条蛋白的实验系统,本质上会把整个闭环重新压缩回低 throughput。
局限性与仍未解决的问题
这篇论文最大的优势是工程真实性很强,但它同样有清晰的适用边界。
首先,SAPP 加速的核心之一恰恰是跳过单菌落分离和逐克隆测序,因此它不可避免地接受一定程度 polyclonality。作者的 sequence-purity 数据主要来自较短 insert,并明确指出合成错误具有 length dependence,长蛋白可能更容易出问题;错误 clone 也可能产生 false negative。因此 SAPP 更适合作为筛选基础设施,而不是直接替代最终候选的严格 clone verification。
其次,它仍然是 arrayed protein biochemistry,而不是百万级 pooled screen。SEC 虽然高度自动化,但单台仪器约数百样品每天,随着规模继续增加,chromatography 会重新成为物理瓶颈。
第三,流程主要围绕 E. coli 中较容易表达的 engineered/de novo proteins 优化。需要复杂 post-translational modification、膜环境、特殊 chaperone、哺乳动物 expression system 或高度定制 purification condition 的蛋白,并不能直接假设获得同样的 throughput;作者自己也指出,该平台对需要复杂表达与纯化流程的蛋白可能不够适合。
第四,论文多次强调 standardized data 对 active learning 的价值,但真正的 machine-learning closed loop 并没有在本文中被建立或验证。目前论文证明的是实验基础设施已经具备成为闭环组件的条件,而不是证明 SAPP/DMX 已经能够自动提高下一轮设计模型的成功率。
最后,统计学层面也需要谨慎。论文说明实验未预先进行 sample-size determination,也没有 randomization 或 blinding。对于验证 workflow throughput 和工程可行性,这不构成致命问题;但如果未来要比较不同设计算法成功率,标准化 pipeline 之外仍需要更加严格的 prospective benchmark。
未来意义:蛋白设计可能真正进入“实验数据规模化”阶段
这篇论文最值得关注的地方,也许并不是 48 小时、300 samples/day 或节省几倍 DNA 成本这些单独的数字,而是它揭示了一种正在形成的 protein design infrastructure:
Design → Build → Express → Purify → Characterize → Learn → Redesign。
过去几年的重点主要放在第一个 Design 上——更强的结构生成、更好的 inverse folding、更准确的 binder design。但模型性能继续提高之后,真正限制下一轮进步的可能逐渐变成后面几个步骤。
如果未来 RFdiffusion、ProteinMPNN、protein language model 或其他 generative model 每一轮提出数百至数千条候选,而类似 SAPP/DMX 的平台能够持续产生 standardized positive + negative experimental data,那么 active learning 才真正有机会在 protein design 中形成高频迭代闭环。
尤其值得重视的是失败数据。为什么某些设计表达失败?为什么预测结构正确却聚集?为什么相同 binder 和 valency,仅仅连接 geometry 不同就产生 25 倍功能差异?这些信息很难从现有 PDB 或成功案例数据库中得到,却恰好可能是下一代蛋白设计模型最缺的数据。
论文已经公开相应代码、数据、质粒和 barcode resources,包括 GitHub、Zenodo、Addgene 以及 cryo-EM/PDB 数据,这也意味着该工作更像一套可以被社区复用的实验基础设施,而非单次实验展示。
总结:这篇工作应该如何理解?
这篇论文没有提出一个新的生成模型,却触及了当前 AI 蛋白设计一个非常现实的问题:
当生成能力扩展几个数量级以后,实验系统是否也能以接近的速度扩展?
SAPP 的核心贡献,是通过简化 cloning、plate-format expression、全样本 SEC、自动 chromatogram analysis 和可选机器人,把高信息量 arrayed protein characterization 推到每天数百个设计;DMX 则进一步利用 combinatorial barcoding 与 Nanopore sequencing,把廉价 oligo pool 转化成 sequence-verified arrayed clones。
更重要的是 RSV 案例证明,规模化实验并不仅仅意味着“更快验证 Top hits”。当实验容量足够大时,研究者可以把 geometry、orientation、valency 等过去很难系统探索的变量真正纳入搜索空间,而实验本身开始成为 design algorithm 的组成部分。
因此,这篇工作的意义可以浓缩为一句话:
下一代蛋白设计竞争的不只是模型一次能生成多少序列,而是谁能够更快地把计算假设转换成大规模、标准化、可重新进入模型的真实实验数据。