


昨天写 Drex 1.5,讲的是「一个能下载的决策层」。隔了一夜,vLLM Semantic Router 把 Decision 3.0 整族模型推上了 Hugging Face:从大约 0.6B 的 d3-edge,到大约 26B 的 d3,中间还有 lite、nano、mini、flash。读 text、JSON,也能塞图片和短视频;一次调用同时回答选择题、是非题、打分题,直接吐概率,不写散文。
许可是 Apache-2.0。底座也清楚:大号 d3 基于 Qwen3.8-27B,小号基于 Qwen3.5 系列。做路由、护栏、工单分流的人,终于可以按预算挑尺寸,而不是只能盯着某一个 9B。
全家桶、可下载、协议干净,这些都让人想动手。可模型卡上的分数是官方自报,接到你自己的样本上,照样可能翻车。
和昨天比,角度故意错开。昨天是「单模型怎么跑起来」;今天是「一串尺寸怎么选、多模态能多干什么、协议从 Open RAIL-M 换成 Apache-2.0 之后商用心里踏实多少」。下面就把这族模型拆开:能干嘛、怎么下、大概多重、一个能跑的例子,以及上线前怎么泼冷水。
01
PART
它到底干什么
WHAT IT DOES

普通大模型回答「这条工单该交给谁」,常常先客套两句,再给结论,程序还得从自然语言里抠答案。选项一换顺序,结论有时跟着飘。
Decision 3.0 反过来。你先准备好一段 state(文本或 JSON),可选地附上图片或视频,再列出一组命名好的问题。每个问题只能是三种类型之一:choice(多选一)、noul(是非题)、score(有序量表)。模型给每个选项一个概率,不采样 token。你给什么选项,它就只能在这些选项里选——限制即可控。
接口形态在模型卡里叫 system_one。Python 侧大致是:`AutoModel.from_pretrained("vllm-sr/d3-flash", trust_remote_code=True)`,然后 `model.system_one(...)`。依赖写得很死:transformers==5.17.0;可选 flash-linear-attention。
差别在于它把「看图、看短视频再拍板」也收进来了。客服贴收据截图、审核看海报、Agent 看操作录像,都可以和文本一起进同一次调用。同一请求可塞多个 questions,每个问题各自对输入做前向——延迟账比连着调两次大模型清楚。
26.09B
d3 约参数
59.0
flash 自报指数
Apache
开源许可
02
PART
怎么选、怎么下、可跑例子
RUN IT
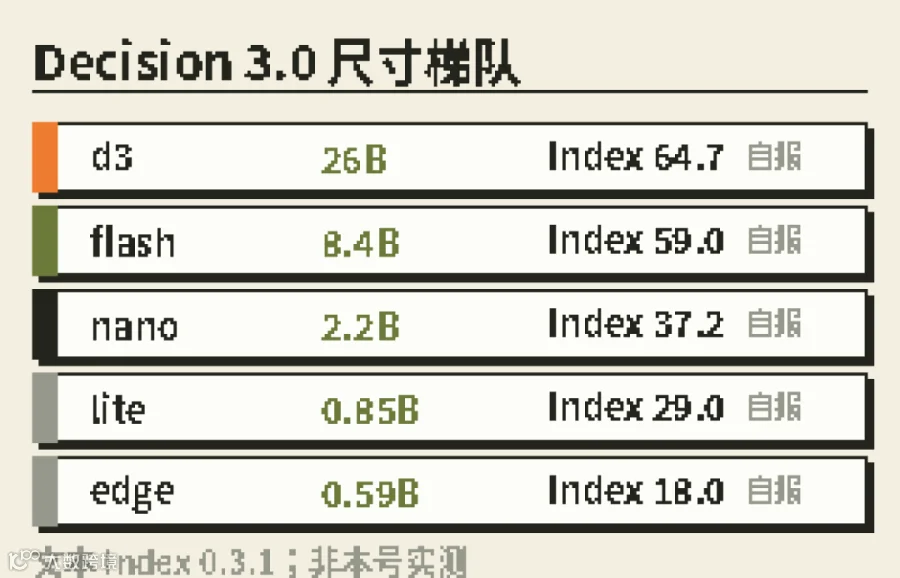
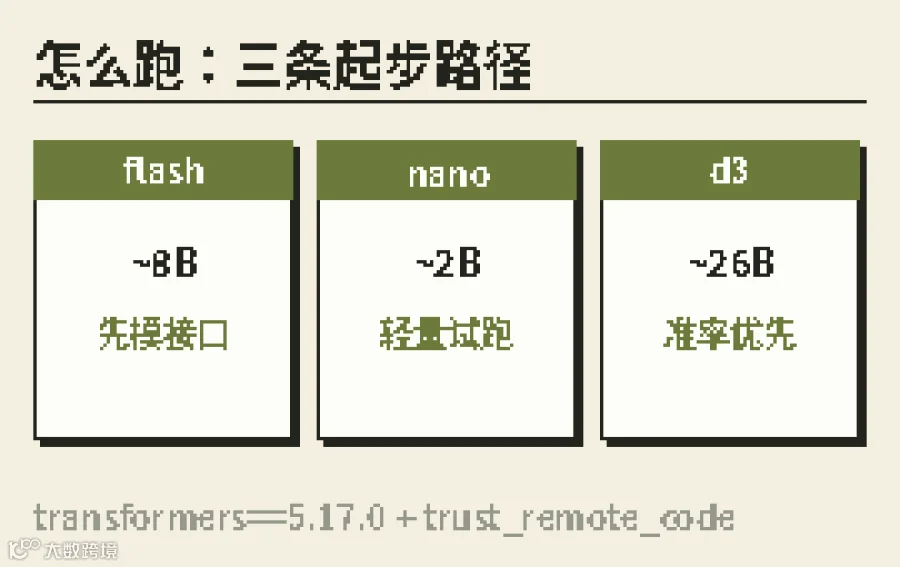
数字来自各尺寸 Hugging Face 模型卡;成绩一律按「官方/模型卡自报」理解。
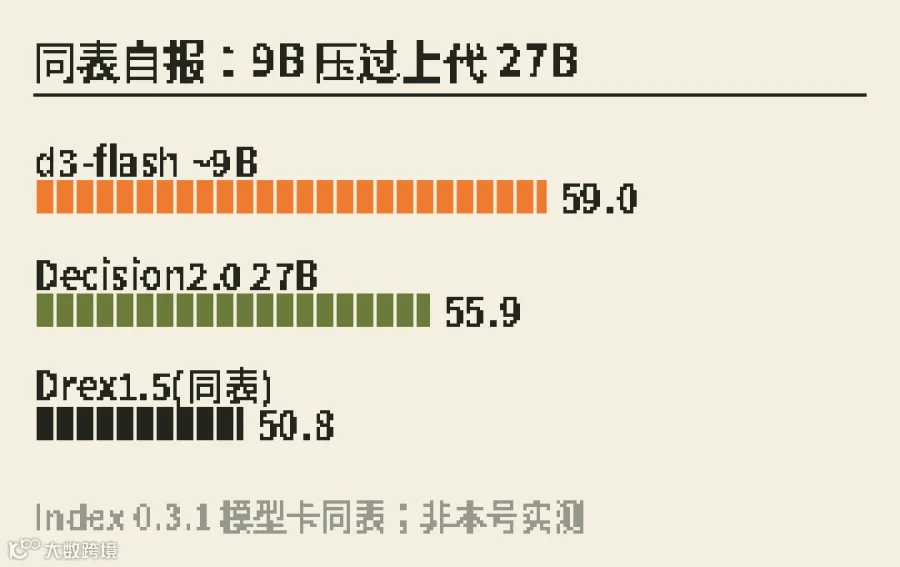
选型可以先记一句:大约每换小一档尺寸,就在准率和延迟/显存之间再砍一刀——但别迷信线性。模型卡同表上,d3-flash(约 9B)文本指数自报 59.0,已经高于 Decision 2.0 那代的 27B(同表 55.9)。小不一定弱,前提是你真的用自己的集复测。
显存官方卡没给统一量化表。按 bf16 粗算:26B 大约五十多 GB 量级,8B 大约十几 GB,2B 大约四五 GB。具体能不能塞进你的卡,只能下载后用 nvidia-smi 说话。
最小可跑例子(d3-flash):先 `pip install "transformers==5.17.0" torch ...`,再 `AutoModel.from_pretrained("vllm-sr/d3-flash", trust_remote_code=True)`,对破损订单 state 问 route / receipt / urgency。模型卡还附了带收据图、带短视频的例子。仓库统一在 vllm-sr/ 下。
和昨天 Drex 比协议:Drex 是 Open RAIL-M;Decision 3.0 各卡写的是 Apache-2.0,通常对商用更友好。法律结论仍以你法务读 LICENSE 为准。边缘侧可看 edge(约 0.6B),但文本指数自报只有 18.0——适合当探针,不适合当唯一裁判。
03
PART
成绩单与冷水
BENCHMARKS
d3 模型卡在 Jev Decision Index 0.3.1 文本表上自报 64.7,视觉板自报 71.6。公开视觉任务里文档抽取类很高,仇恨表情包审核、R-Bench-M、MMMU-Pro 视觉则明显更弱——强弱不均,别只看总分。
flash 同板自报 59.0;同表里昨日 Drex v1.5 为 50.8。注意:这是官方自报同板数字,不是本号对齐评测;Drex 昨天那篇里的 58.08 来自另一套公开指数口径,两套数不要硬加硬减。
冷水:自报不是你的 F1;越小越要警惕(nano 文本自报 37.2,同表 LiquidAI d1-3B 约 40.1);它几乎不解释;依赖钉死 transformers==5.17.0;延迟数字来自 1× AMD MI325X 单请求中位,带图时 d3 卡自报约 273 ms、flash 约 149 ms。
口令句:在模型卡同表上,大约 9B 的 flash 自报文本指数已经压过上一代 27B;但若你每测 10 个真实业务题,仍要默认至少有几题会翻车,除非你自己的金标准证明相反。
04
PART
如何判定值不值得上线
DECIDE

我把这套东西叫做开源多模态决策层。判定步骤可复用昨天那套,只加一条:要不要看图。
第一步:划界。只把选项可穷举的判断交给它。要写回复、写方案,继续用大模型。
第二步:建金标准。抽 200–500 条真实样本。若业务本来就看图,标注集里必须有图。
第三步:先小后大。用 flash 或 nano 打通 system_one,算准率、校准、P50/P95。不满意再考虑 d3。
第四步:定阈值,不要裸 argmax。例如最高概率 ≥0.85 自动执行;中间带换大模型复核;低置信交人。数字按业务损失调。
第五步:看失败模式。审核类、部分推理类视觉题偏弱(模型卡已提示)。把最贵的失败案例单独建子集。
多模态不是免费午餐。纯文本中位延迟可以到几十毫秒量级(模型卡自报),一上图就跳到百毫秒以上。护栏若打在每一个 Agent 步骤上,要先算预算。
就目前能下载、协议相对干净、还带视觉的决策层来说,这套值得优先摸一遍。不是银弹。若只记一个对比:flash 自报 59.0,Decision 2.0 的 27B 同表 55.9——两笔都是自报,不是你业务集上的 F1。
05
PART
文末清单
CHECKLIST
CHECKLIST · 照着做
☐ 打开 HF Decision 3.0 集合,确认尺寸与 Apache-2.0 LICENSE
☐ 固定 transformers==5.17.0,trust_remote_code=True 加载
☐ 先跑 d3-flash(或 nano)文本 system_one 例子
☐ 用自己的 20 条样本改 state/questions
☐ 业务看图:加 images=,单独建带图评测集
☐ 准备至少 200 条金标准,写清标注规则
☐ 写清自动执行 / 复核 / 人工的概率阈值
☐ 不要用它写长文、写代码、当百科;弱项子集单独压测
和本号近期三篇对着读,故事线是清楚的:闭源产品看生态与延迟,开源单模型看下载与校准,今天这篇看「按预算选尺寸 + 多模态」。三条线都在回答同一个问题——Agent 里那些小判断,还要不要每次都去烦一个会写小说的大模型。
往期 · 接着看
Drex 1.5开源:9B可下载,自测58.08,24GB显卡能跑
微软发了个只做选择题的模型,自测比GPT-6 Sol快35倍
Step 5:600B 只激活 27B
出处:Hugging Face vllm-sr/d3、d3-flash、d3-nano、d3-lite、d3-edge 模型卡及 Decision 3.0 集合;MarkTechPost 2026-10-11;本号 10-10 Decision-1、10-11 Drex 1.5 相关背景。分数与延迟均为模型卡/报道自报,非本号实测。
觉得有用的话,点个赞或在看,我们下篇见
THANKS FOR READING