编者摘要:本文提出自优化软件是必然趋势。当前编码智能体已经实现软件开发的前向传播:接收需求,一键生成、部署应用并接入可观测工具。但生产环境产生的日志、链路追踪、用户行为、客服工单等运行信号,回流到智能体的反向传播环节仍高度依赖人工,工程师与产品人员充当 “人肉中转代理”,在多套割裂工具之间搬运信息、判断问题优先级。
依靠告警、Webhook 驱动的传统智能体自动化存在局限,只能处理预先定义的已知问题,无法识别 “未知的未知”,存在天然盲区。作者借用神经网络类比:代码是权重,生产信号是模型输出,反向传播就是根据结果自动调整代码。随着推理成本大幅下降,智能体可以读取全量多源信号,自动定位缺陷并提交代码变更。
未来人类的核心工作不再是排查 bug、排迭代优先级,而是定义适应度函数,设定系统优化目标与约束,权衡相互冲突的指标(延迟、转化率、营收等)。最终形成完整闭环:智能体持续采集生产信号,自主发现问题、修复并验证效果,让软件持续自我迭代。
10 个关键问题 Q&A
-
Q:什么是自优化软件? A:能够自主读取生产运行信号、判断需要修改的代码、上线变更并验证优化效果,持续自我迭代改进的软件。 -
Q:什么是 “人肉中转代理(meat proxy)”? A:人作为中间人,在两套本可以直接通信的系统之间搬运信息(例如截图指标面板粘贴给编码智能体)。 -
Q:文中的前向传播与反向传播分别指什么? A:前向传播:输入需求,智能体生成并部署代码;反向传播:收集生产信号,评估效果,自动调整代码。 -
Q:基于告警的智能体自动化有什么短板? A:只能捕获提前配置好的已知问题,无法发现系统涌现出来的 “未知的未知”,存在固有盲区。 -
Q:为什么现在才有机会实现自优化软件? A:大模型推理成本大幅降低,智能可以低成本读取、关联海量日志、会话回放、工单等多源异构信号。 -
Q:自优化软件时代,工程师、产品经理不再写代码、排 bug 吗? A:不是完全不用,核心工作转移:不再手动做大量故障排查与工单流转,重点转为定义优化目标与约束条件。 -
Q:什么是适应度函数(fitness function)? A:一套可量化指标集合,告诉系统 “什么叫更好”,包含延迟、错误率、留存、工单量等多维度目标。 -
Q:适应度函数最大的难点是什么? A:各类指标经常互相冲突,需要权衡取舍,确定哪些是硬性约束、面向哪类用户优化。 -
Q:完整的自优化闭环会如何运行? A:智能体定时采集全量生产信号,自动聚类同类问题,定位引入缺陷的版本,自动提交修复 PR 并验证效果。 -
Q:作者正在做的 Polylane 项目目标是什么? A:打造基础设施,让所有软件都具备自我优化的能力。
发布时间:2026 年 10 月 10 日
标签:智能体、可观测性、软件开发生命周期(SDLC)
今早上线的版本,其实早就暴露出自身存在的问题。一整天里,它在多个平台持续向外输出异常信号。生产环境故障迟迟未能修复,唯一的阻碍就是人类。
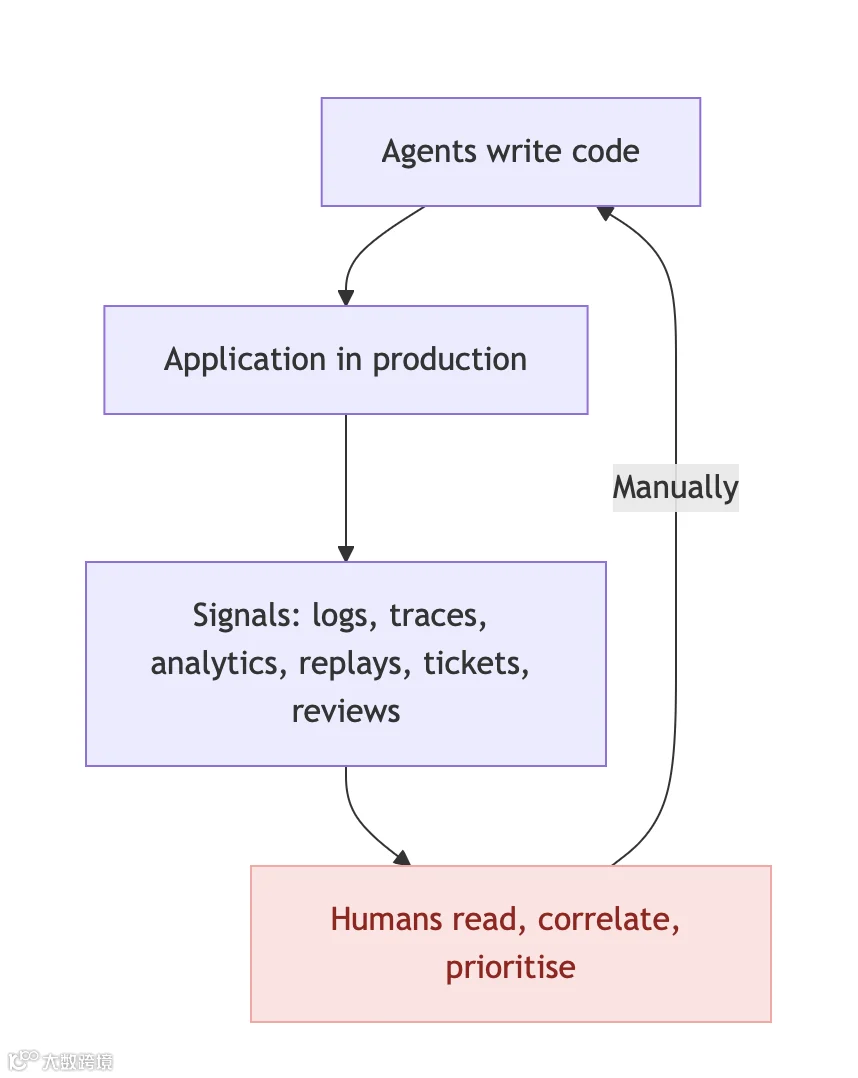
如今,智能体已经可以编写绝大部分软件。它们能一次性生成完整应用、完成部署,在你一杯咖啡还没凉之前,就把全套可观测性链路配置完毕。但这条链路目前是单向的:智能体产出更多软件,软件产生海量运行信号,可几乎没有任何信号能回流到智能体内部。目前只能靠人工,把这些数据重新喂给智能体。
人工闭环流程: 智能体编写代码 → 应用上线生产环境 → 产生信号:日志、追踪链路、数据分析、会话回放、工单、用户反馈 → 人工读取、关联信息、排定优先级
过去十年,我一直在搭建可观测性工具,开发各类系统帮助我们查询、可视化、整理、筛选、排优这些运行信号。但归根结底,仍然需要人去读懂数据、判断需要优化的内容。
自优化软件是必然的。软件应用能够自主读取自身运行信号、判断需要修改的地方、提交变更上线,并验证优化效果。一旦软件可以自我改进,它还能迭代优化这套自我改进机制:更强的可观测能力、更精准的异常检测、更深度的问题分析、更完善的修复方案,每一轮循环都会让下一轮迭代变得更高效。
想要实现这一点,我们必须交出控制权。工程师、产品经理、设计师,所有人都一样。我们不能再充当 “人肉中转代理”,由人来决定接下来修复什么、何时修复。
当前:人类是反馈回路
各类信号数据分散在不同工具中:工程师与 SRE 使用 Datadog,产品经理看 Amplitude,设计师用 FullStory,客服依托 Zendesk,彼此割裂。
当用户在生产环境遇到问题:可观测工具记录报错,会话回放留存用户愤怒点击记录,产品指标下滑,客服工单上涨。 产品经理需要发现所有这些线索,调研并关联多源信号,压缩信息生成工单,排入下周迭代。之后工单流转到工程师手上,工程师再给智能体写提示词,将工单转化为代码。
2026 年,智能体已经能够解决人类史上最难的部分数学难题,而解析报错、给问题排优先级根本不需要极高的智能。这套流程现在看来非常不合理。
我们都在做人肉中转代理吗?
如果你把产品分析仪表盘截图,粘贴进 Claude Code,提示它 “分析指标下跌原因并修复”,这时你就是人肉中转代理。
人肉中转代理:唯一工作就是在两台本可以直接通信的系统之间传递信息的人。 仪表盘拥有数据,智能体拥有推理能力。人夹在中间,决定看什么、什么时候看、如何描述问题,这就是人肉代理。
理想链路:产品分析数据 → 直接传给编码智能体 → 产出代码 现实链路:产品分析数据 → 人截图、粘贴、写提示词 → 编码智能体 → 产出代码
MCP 协议与各类连接器虽然可以加快中转流程,但人依然是中间代理。
自动化存在 “未知的未知” 难题
现在很多智能体工具自带自动化能力,我自己也开发过这类系统。本质上是定时任务 + Webhook,触发智能体执行预设提示词:
-
监听 Honeycomb 告警,每次告警触发就自动排查 -
Sentry 新增异常时,自动分析并提交修复 PR -
每日早上检查产品指标,激活率低于 10% 就自动排查并编写修复代码
看上去生产力极强。所有人打开电脑前,告警已经自动生成分析报告;每一条新增异常,都自动生成修复代码合并请求。
但这类自动化,只能看到预先定义好值得关注的信号。它继承了触发系统自带的所有盲区。
必须有人预先定义告警规则、SLO 指标,而这些定义天生就是不完备的。复杂应用涌现出来的行为,根本无法全部提前配置告警。
这就是未知的未知问题:已知问题可以被检测,因为有人提前写好了告警或异常捕获逻辑;未知问题永远无法被发现,因为不存在对应的检测规则。智能体可以飞快修复那些我们已经知道如何找到的问题;而那些造成大量用户流失的重大故障,恰恰是我们一开始根本预料不到的。
应用需要反向传播
我们可以把软件类比成神经网络: 代码就是权重与偏置,每一次代码变更,等价于更新权重。用户和软件交互产生的信号(链路追踪、点击行为、工单、流失率、营收等),就是模型输出结果。
在这个类比里,自优化软件分为两个阶段:
- 前向传播(Forward pass)
输入需求意图,输出代码。编码智能体基本已经打通这个训练环节。一条提示词就能生成复杂度不低的应用,完成部署,对接全部可观测与产品工具。 - 反向传播(Backpropagation)
对比实际输出与预期目标,计算差距,将梯度回传给系统以调整权重。对应到软件:读取生产环境全部信号,推导代码存在的问题,自动修改代码。
当前现状:前向传播已经自动化,反向传播仍靠人工。 我们每周往生产环境推送几十次 “权重更新”,但梯度计算只能在规划会议上手算。很多公司一周一次,甚至季度一次。判断依据只是产品经理的记忆、二十条会话样本、几条呼声最高的客户投诉。 如果训练大模型也用这种方式,我们根本得不到任何有价值的模型。
智能已经廉价到近乎不计成本
之所以反向传播仍由人工完成,过去的理由是:没有别的主体,能够读取日志、找到对应追踪链路、交叉比对会话回放、理解用户不满根源,并且决定代码改动方向。这件事需要判断力,而优质判断力过去稀缺且昂贵。
但现在情况变了:智能已经廉价到近乎不计成本。智能体可以在几分钟内读取全部追踪链路、每一条用户会话、所有工单与访谈记录,并把多源信息关联起来。
我们可以同时把智能部署在前向与反向环节,大幅提升迭代速度,最终实现自优化软件。
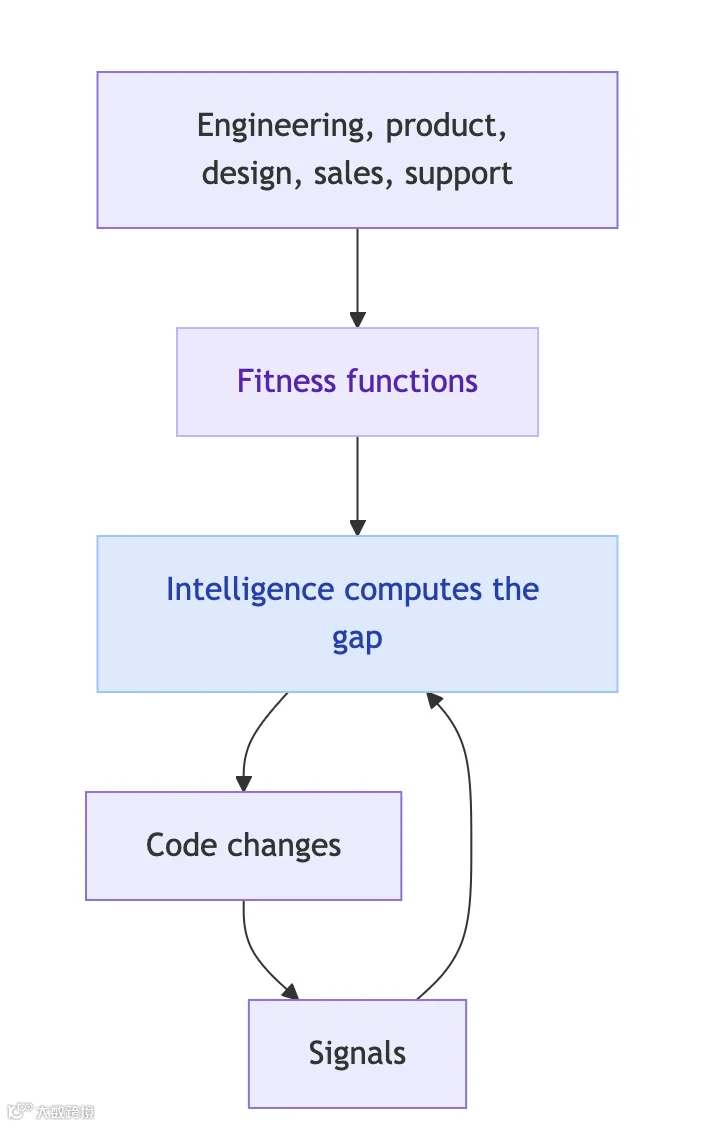
闭环:意图与目标函数 → 智能体计算偏差 → 代码变更 → 生产环境 → 产生信号 → 回流
那人类的角色是什么?
没有损失函数的神经网络,只是一台昂贵的随机数生成器。反向传播必须知道 “更好” 该如何定义。
放到这个类比中,我们的工作,就是定义系统优化所依据的适应度函数(fitness functions)。工程师、产品、设计、销售、客服,所有人的工作变成定义这套系统的优化目标。
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
流程:各角色定义适应度函数 → 智能体计算现状与目标的差距 → 生成代码变更 → 生产环境产生信号
难点在于,这些目标之间常常互相冲突:更快的结算流程可能削弱风控;简化的新手引导可能降低重度用户激活率;降价可以提升营收,但侵蚀利润。
如何权衡各项指标、哪些是硬性约束、要为哪一类用户做优化,才是真正的难题。本质上就是明确公司的目标,并且把目标精准描述到机器可以直接优化的程度。说实话,这本来就一直是最难的工作。
即将到来的生产力丰裕时代
给云端编码智能体开启全部信号源的读取权限(可观测、产品分析、会话回放、客服工单),同时赋予代码仓库写入权限,设置定时任务:
-
每小时:读取过去一小时所有新增报错、追踪链路、会话回放与工单。把相似问题自动聚类,哪怕这些问题分散在不同工具中。针对每一类问题,定位引入缺陷的版本,附带全部证据自动提交修复 PR。 -
每日早晨:对比昨日数据与预设目标:结算 P99 延迟低于 300ms、错误率低于 0.1%、激活率高于 25%、每日工单少于 20 条。任何指标恶化,自动定位代码根因并提交 PR。如果全部指标达标,则寻找最有可能提升指标的优化点,提交对应的 PR。
我们距离这个目标已经很近。自优化软件是大势所趋,现在,它已经近到可以动手落地构建。
正在搭建 Polylane,目标就是让所有软件都能实现自我优化。
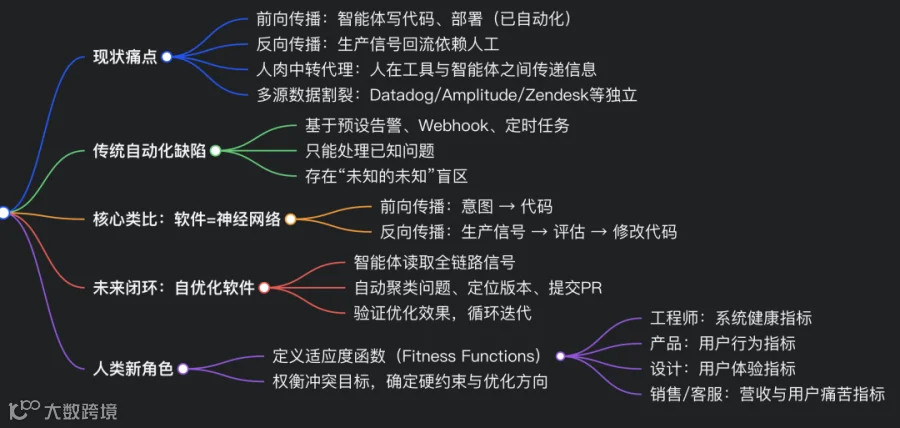
要点提炼
- 现状矛盾
编码智能体快速写代码、部署,但生产侧的运行信号(日志、埋点、工单)回流到智能体的反馈链路仍然依靠人,人充当 “人肉中转代理”。 - 传统自动化局限
告警、Webhook 触发的智能体自动化,只能处理预先定义好的问题,无法发现 “未知的未知”,存在天然盲区。 - 神经网络类比
软件开发分为前向传播(需求→代码,已基本自动化)和反向传播(生产信号→评估→修改代码,目前人工)。随着大模型推理成本大幅下降,反向传播可以交给智能体完成。 - 人类新定位
不再是逐一定位 bug、写工单、排迭代优先级;核心工作转为定义适应度函数,设定系统需要优化的目标、约束条件,平衡多目标冲突。 - 未来闭环构想
智能体定时读取全链路多源数据,自动聚类问题、定位版本、提交修复 / 优化 PR,软件持续自我迭代,也就是作者所说的自优化软件。
核心概念名词对照
-
Self-improving software:自优化软件 -
Meat proxy:人肉中转代理 -
Forward pass:前向传播 -
Backpropagation:反向传播 -
Fitness function:适应度函数 -
Observability:可观测性 -
Agents:智能体 -
SDLC:软件开发生命周期 -
PR(Pull Request):代码合并请求 -
SLO:服务等级目标 -
P99 latency:P99 分位延迟