



10 个关键问题 Q&A
Q:这份文章是谁发布的?A:Anthropic 研究院。
Q:文章核心目的是什么?A:提出一套可量化的指标,用来客观衡量前沿实验室 AI 技术的发展速度,提升行业透明度。
Q:什么是递归自我改进?A:AI 系统辅助甚至自主完成新一代 AI 的研发,加速自身能力迭代。
Q:第一个测量维度是什么?A:AI 主导 AI 研发,评估 AI 在 AI 研发链条中承担多少工作。
Q:第二个测量维度关注什么?A:对 AI 智能体的监督,衡量人类能不能管控 AI 智能体的行动。
Q:第三个测量维度监测什么?A:算力资源分配,区分算力投入是用来增强模型能力还是做安全评估。
Q:这套指标只给企业内部使用吗?A:不是,目标是支持公众、第三方研究者、监管机构独立核验。
Q:指标能否直接保证 AI 安全?A:不能,指标仅用于观测进展,测量不等于安全。
Q:为什么需要衡量 AI 发展节奏?A:AI 自我迭代加速,仅靠企业对外宣传不足以判断风险,需要客观数据辅助决策。
Q:这套指标可以替代模型基准测试吗?A:不能,它侧重研发过程的监测,传统基准测试侧重模型最终能力评估,二者互补。
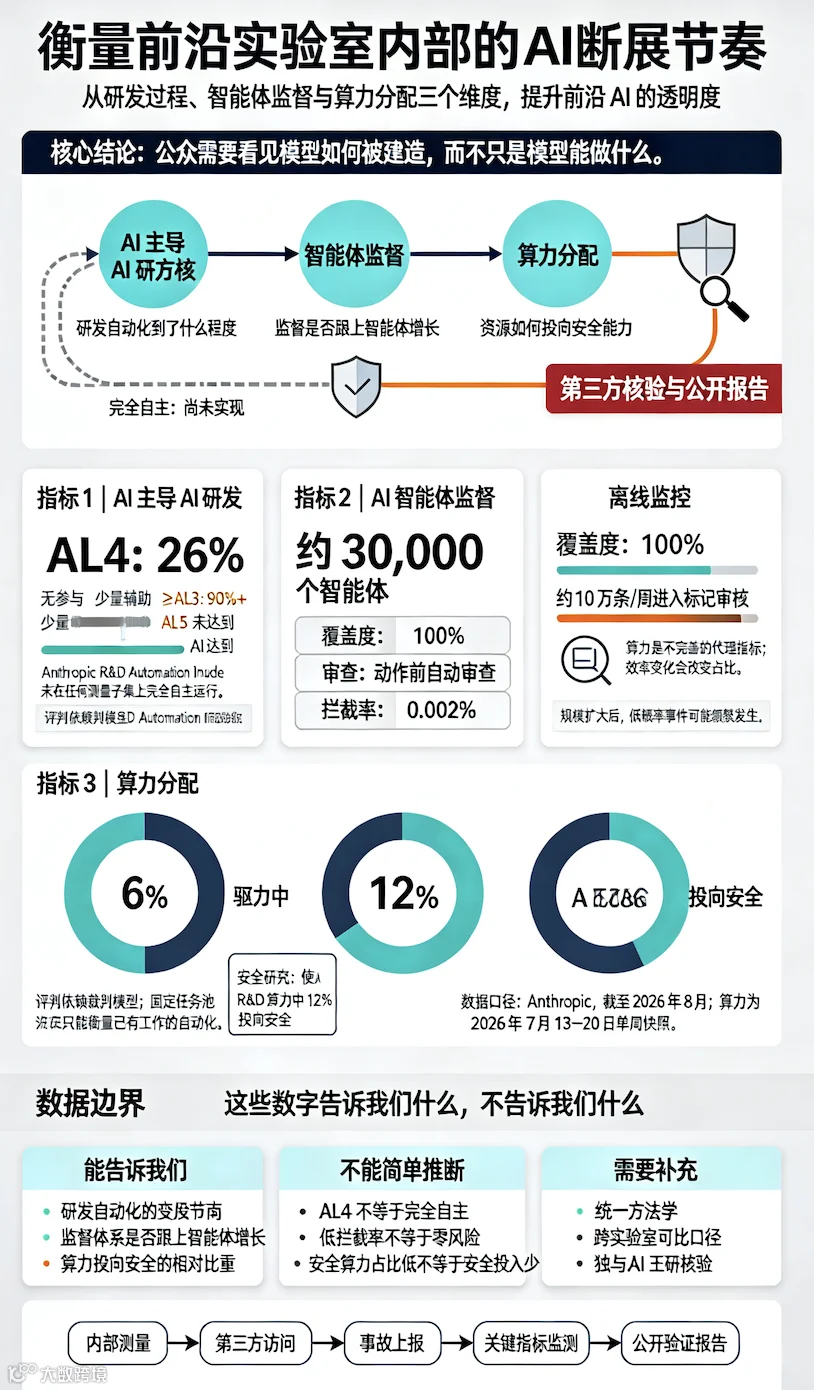
Anthropic 发布这套可对外公开的三大度量指标体系,目标是缩小前沿 AI 实验室与公众、监管之间的信息差,用来量化 AI 自我迭代的速度,支撑 “前沿节奏管控(pacing the frontier)” 的讨论;同时计划引入独立第三方评估机构,核验安全实践、监控指标、上报事故。
这套指标侧重模型研发生产过程,和传统能力评测(测模型能做什么)互为补充:能力评测看模型输出,本套指标看模型研发输入与自动化流程。
三大测量维度(截至 2026 年 8 月数据)
1. 衡量由 AI 主导的 AI 研发(AI-led AI R&D)
核心目的:量化 AI 在开发下一代 AI 模型中的参与程度,判断距离递归自我改进(模型完全自主构建后继版本)有多近。
-
工具:Anthropic 自研R&D 自动化指数,采用 Epoch AI 提出的自动化等级 AL(Automation Level) -
AL0:无 AI 参与;AL1 少量辅助;AL2 AI 协助;AL3 AI 协作;AL4 AI 主导;AL5 完全自主 -
实测结果: -
没有任何 AI 研发任务达到 AL5 完全自主; -
Claude主导(AL4)了 Anthropic 26% 的 AI 研发工作; -
AI 协作及以上(≥AL3)的工作量占比超过 90%。 -
方法论:从 Slack、内部文档采样,2026 年 7 月采集约 15000 条细粒度研发任务,构建 542 节点任务树;用人时作为任务权重,由 Claude 评估自动化等级。 -
局限:评判依赖 “裁判模型”;基准任务池固定,只能衡量原有任务的自动化,无法自动捕捉全新类型研发工作;模型与人类评级一致率约 59%,人类之间互相一致率仅 35%。 -
跨实验室对比难点:缺少统一标准;自评容易产生偏差;建议引入第三方或其他厂商模型交叉校验。
2. 衡量 AI 智能体的监督(oversight of AI agents)
核心目的:随着员工把越来越多任务委托给可长期自主、互相委派任务的 AI 智能体,需要评估监督体系能否跟上智能体的决策权增长。
监测对象:Anthropic 内部平台同时有约 30000 个用于研发工程的智能体。分在线监控(实时阻断)和离线监控(事后审计)两套机制。
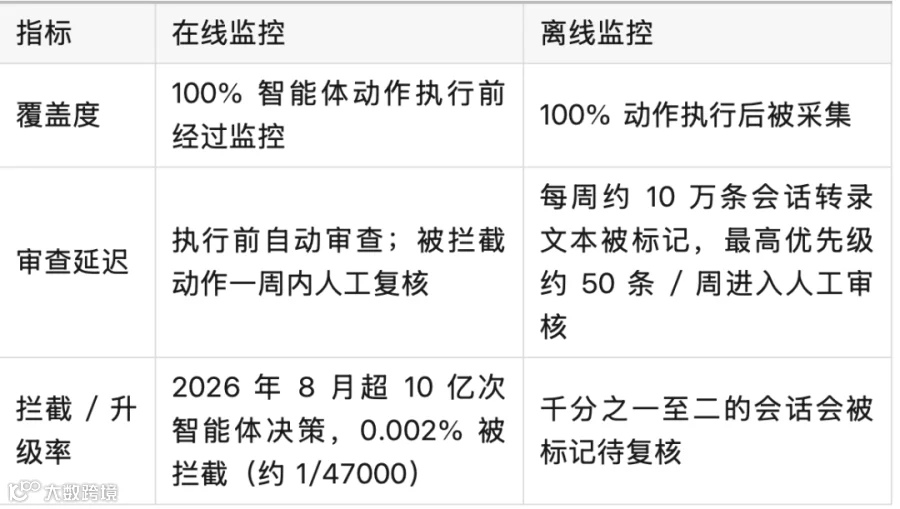
配套工程设计:
- 独立身份
:每个智能体有唯一身份,所有行为绑定身份,支持跨模型版本持续审计,区分自身与其他智能体输出; - 开放通信
:智能体在共享消息系统通信,消息留痕可溯源,便于跨智能体行为监控。
局限:监控时间尚短,很难覆盖全部未知风险行为。
3. 算力分配测量(compute allocation)
核心目的:追踪算力资源投向,看研发资源在能力提升研究 vs 安全研究之间如何分配;算力是 AI 研发中相对可核验的投入指标,可作为未来管控前沿 AI 的抓手。
样本窗口:7 月 13–20 日单周算力快照(算力池动态调度,不是固定预算)
-
定义:安全研究= 核心目标是让 AI 更安全、可解释、更稳健;如果一项工作同时提升能力与安全,则不计入安全算力(保守口径)。 -
实测结果: -
全部 AI 研发算力中,6% 分配给安全研究; -
AI 驱动的 AI 研发算力中,12% 分配给安全。 -
重要提醒:算力是不完善的代理指标。安全研究本身往往不需要超大算力,更多是研究者做实验设计;算力占比低不等于安全投入少。 -
方法:采样约 14% 算力任务,优先高算力任务;用 Claude 分类器打标签,人工边界案例校准。 -
局限:仅一周快照,无法看长期趋势;原始标签为自动标记,未完全核验;算力效率变化会扭曲算力占比(安全分类器效率提升会直接降低安全算力占比,但不代表安全工作量减少)。
结论与落地思路
-
公开这类过程指标,提升透明度,让外部能评估 AI 自我迭代的速度; -
目标推动行业形成统一标准,各实验室定期发布同类指标,接受第三方核验; -
指标可作为监管触发条件:例如新模型投入 AI 研发前强制测试窗口期、实验室承诺最低安全算力占比。
附录要点(审计任务分类规则)
审计人员需要逐个作业判断归属:
-
✅安全研究:主导目的是提升 AI 安全性、可解释性、系统安全; -
❌不属于安全研究:以提升模型能力、产品开发、训练基础模型、通用工程工具为主; -
边界难题:部分研究同时兼具能力增益与安全增益,本文采用保守口径,只要二者收益相当,划归能力研发。
边界案例可以通过书面定义 + 样例,让 AI 分类器和人工评审差异控制在 1–2 个百分点,但仍存在少数人工长时间评审也无法判定的场景。
关键名词简释
-
Recursive self-improvement 递归自我改进:AI 系统自主改进自身,迭代生成更强版本;本文 AL5 为此状态,Anthropic 目前未达到。 -
Pacing the frontier 前沿节奏管控:Dario Amodei 提出的理念,对前沿模型研发速度做协调约束,降低极速迭代带来的风险。 -
AL(Automation Level)自动化等级:Epoch 提出的分级框架,用来衡量 AI 在研发任务中的自主程度。 -
Online/offline monitor:在线监控(事前实时拦截高危动作)、离线监控(事后复盘,识别缓慢显现的对齐问题)。