

⭐ 设为星标 · 第一时间收到推送
大家讨论的,其实是四种体验
我有一个做老师的朋友。偶尔聊天聊到AI,我一下就兴奋起来,越说越多,恨不得把最近看到的新能力都讲一遍。
她却有些不解:“AI真的有这么厉害吗?可是我感觉,它没给我的工作带来多少变化啊,做个PPT都不行。”
我当时只问了她两句:“你用的是什么模型?你是怎么用的?”

聊到这里,就得先把“AI”拆开看了。模型、工具、交给它的工作不同,“用过AI”并不意味着体验过同一种东西。
今年4月,Karpathy把这种分歧描述成两群人互相说不到一块:一群人的印象来自旧模型、免费产品和日常聊天;另一群人在数学、编程等技术工作中使用前沿Agent。
到了北京时间10月12日凌晨,他重新引用这段话,认为差距还在扩大,把体验分成了四层。

他为这个漏斗配了一组人数,称为“napkin math”,也就是随手粗估,不是调查统计。
第一层,约60亿人,约占75%,几乎没接触过大语言模型。
第二层,约10亿到20亿人,约占20%,偶尔使用免费聊天产品。AI像一个更好的搜索入口或写作助手。Karpathy说,他的一些非技术朋友觉得用处不大,他认为这完全可以理解:不少岗位的大量时间花在和人沟通上,能理解技术进展,也未必能在自己的工作里直接体会到。
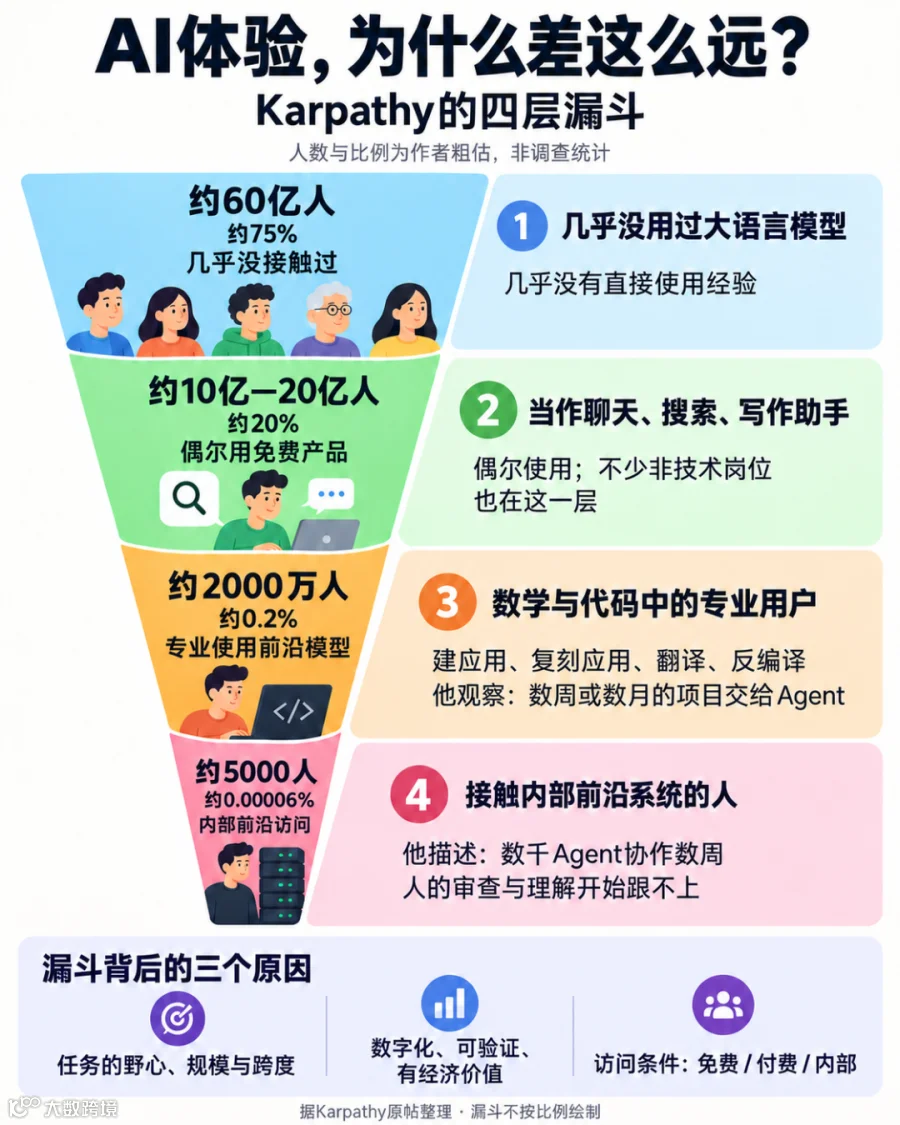
第三层,约2000万人,约占0.2%,在数学、代码等领域专业使用前沿模型。Karpathy举的例子包括新建、复刻、翻译应用,以及从二进制反推程序。他的判断是,一些原本需要数周甚至数月的大项目,如今可以通过提示交给Agent完成。
他还提到自己的变化:不到一年前,自己还在逐字敲代码,偶尔按Tab补全一小段。
这个说法很强,但它是Karpathy的观察,不是所有项目的成功率承诺。需求是否完整、结果是否合格、还要花多少时间修补,这些都得算进去。
第四层,约5000人,约占0.00006%,能接触内部前沿系统。Karpathy描述的画面是:数千个Agent持续数周协作,处理大型软件、安全或科研问题;他还担心,人的审查与理解开始跟不上。内部系统的部署规模和成功率,不能仅凭这段描述确认。
他觉得古怪的正是这一点:有人看到笨拙的聊天机器人,多数专业人士感到有限提效,少数人却已经有了能力曲线突然陡升的眩晕感。这些体验发生在同一时刻。
为什么会分开?他给了三条原因
第一条:影响随任务的野心、规模和时间跨度变化。
问一个只需要一段话回答的问题,很难充分用到系统的能力。Karpathy认为,要看到明显差异,你得有一批很在意、又大又难的问题交给它。
按他的思路,专业用户可能更受震动:原本要反复查资料、写代码、调试、验证的工作,如果其中一大段能被接走,省下的可能是多个工作环节的时间。
不过,任务大并不意味着更容易成功。长流程里的错误也会往后传。目标没说清,让它跑很久,最后也可能得到一份看起来完整、却没法用的成果。
第二条:能力有高有低,尤其偏向数字化、可验证、经济价值高的领域。
代码能运行,测试能给出通过或失败;数学推导可以逐步检查。相比之下,“这篇文章是否打动人”“这个建议能不能促成合作”,评价更难固定成一个明确的对错信号。
Karpathy把这种差异归因于两件事:可验证的结果,能给强化学习训练提供更清楚的对错反馈;公司也会优先投入有收入潜力的任务环境。这是他的机制解释,原帖没有给出能量化两者贡献的实验。
这套解释允许两种体验同时成立:数学和代码用户感到进步很快,其他一些岗位只得到有限帮助。程序测试通过,也不等于需求做对了,更不能据此判断AI能同样可靠地处理人际协调或审美判断。
第三条:访问条件。
免费、付费、内部系统,是原帖直接列出的三个层次。讨论体验时,至少要说明自己用的是哪个版本、带了什么工具、交了什么任务;只说“我也用过AI”,很难比较。
付费不会自动给你内部系统的能力,也不会补齐没有接入的数据或没有说清的目标。反过来,免费工具完成一项简单任务,也不能说明更复杂的工作没有价值。

这三条要放在一起看:同一个人升级了模型,如果仍然只问日常问题,体验未必剧变;同样是Agent,换到难以验收、缺少数据的任务,也可能很快碰壁。
漏斗里面,也还有差别
评论区里,有人补充了区分:即使在第三层,也有人是在更快地完成原来的工作
有人却已经在做以前做不了的事。
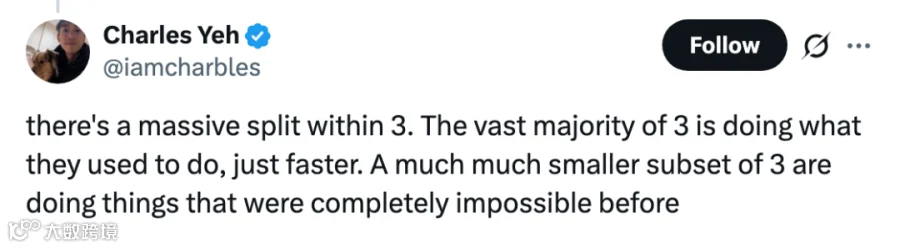
“快了多少”和“多了哪些能做的事”,我觉得值得分开算。两个人都在用前沿Agent,也可能因此有完全不同的感受。
另一条不同意见来自Kartik。他说,自己给父亲开了Codex订阅;父亲没有专业编程背景,却为自己的生意搭了一个目录类网站,还加了支付功能。他更看重的是:有人把具体用法教给普通用户
让他们看到AI能怎么帮忙。

这是Kartik的个人自述,网站质量和后续使用效果还看不到。但它提醒我,职业标签未必能决定你在哪一层。除了模型和访问权限,有没有具体需求、有没有人示范、愿不愿意学着用,也可能改变体验。
给AI什么工作,才值得试?
沿着这个解释,我的建议是:先找一件做完后能说清省了什么的工作。
比如,把一批格式不同的订单文件统一成表格,检查重复记录与金额差异,输出异常清单,保留原文件。它比“帮我提高工作效率”更容易判断有没有用。
选问题时,可以先问自己四件事:
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|

这个任务不保证Agent能一次做对。如果你缺的是和客户谈妥一个说不清的条件,AI整理得再快,卡住工作的仍然可能是协商本身。
试完以后,记下自己投入了多久、验收和返工又花了多久。只有把这些算进去,才能知道它到底接走了多少工作。
觉得AI用处不大,不必急着怀疑自己落后;看到别人回不去了,也不用先认定他夸张。拿一个真实任务,交代环境、看交付、算返工,才有办法比较两种体验。