

前腾讯AI Lab NLP中心总监史树明老师最近作为一作发了一篇技术报告《Counting and Min-Cost Encoding for Tokenization in Large Language Models》,年过50的他依旧宝刀不老,文章思路优雅,不带一丝冗余。

同样一万字文本,有的分词器切出 8000 个 Token,有的只需要 5000 个。在模型架构不变的前提下,Token 数量越少,推理速度越快,KV‑Cache 占用显存越少,长文本处理压力越小,调用成本也随之降低。分词器的压缩效率,直接影响大模型落地的成本上限。
时至今日,几乎所有主流大模型,GPT 系列、Llama、Qwen,底层都在使用 BPE及其变体作为分词器。BPE 通过不断统计、合并高频相邻子词构建词表,简单高效,久经工程验证,但它与生俱来的缺陷正在逐渐凸显。
行业一直存在一个疑问:能不能绕开合并操作、摆脱反复迭代,直接构建一套更高压缩效率的分词器?
为此,史树明团队给出了 CNF‑MCE 这一套完整答案,分别为CNF 词表构建与MCE 最小代价编码两大模块,二者既可以组合使用,MCE 甚至可以直接赋能现有的 BPE 词表。
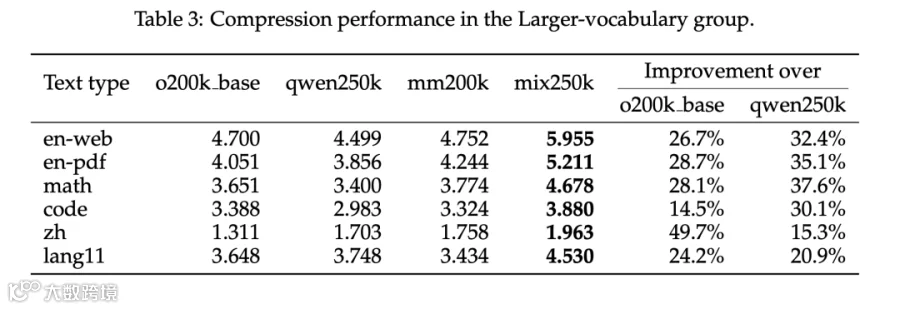
在250K词表下,针对英文网页文本,相较于o200k base 与 qwen250k 分词器,CNF‑MCE 的压缩率分别提升26%和30%。词表扩到1M时,token效率提升超过60%,词表利用率从52.9%直接拉到96.9%。
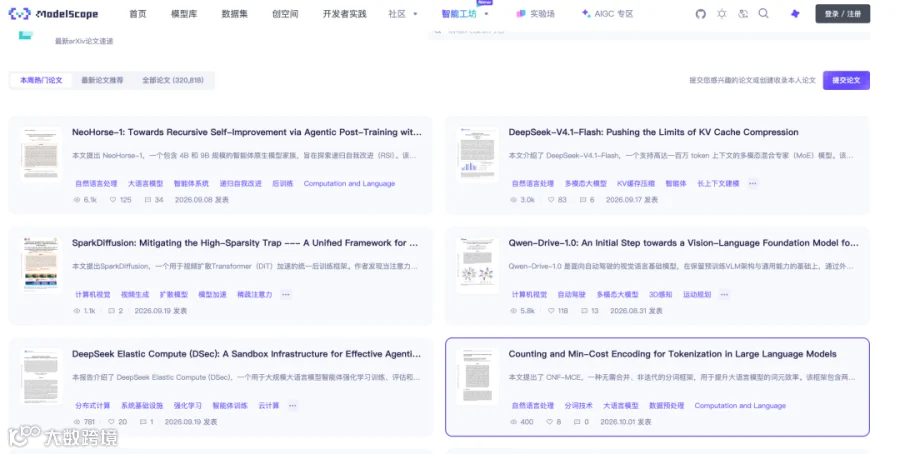
此外,该技术报告登上了ModelScope的本周热门论文榜。
01
CNF:先数清楚,再按
真实用法筛
CNF(Counting and Filtering)分两步。
第一步是计数。在训练语料里直接统计“合法候选token”的出现次数,选出最高频的一批作为原始词表。这里的“合法”有清晰规则:允许单词、子词,也允许完整的多词短语,但会过滤那些从词中间开始、跨多个词却不完整的奇怪片段。
为了在百万级文档上跑得动,研究团队设计了多轮、按长度区间、带提前停止的并行计数算法。32线程处理一百万英文文档,不到一小时就能完成。
第二步是过滤。用下面要介绍的MCE,把训练语料完整分一遍,统计每个候选token在真实分割结果里实际被用了多少次。按这个“真实使用频率”再筛一次,得到最终词表。
关键点在于过滤只做一次。词表选择从“原始出现次数”转向“在全局最优分割下真正被用到的次数”,更贴近实际编码行为。

02
MCE:全局最小代价分割
有了词表之后,怎么切同样重要。
MCE(Min-Cost Encoding)把分词定义成一个代价最小化问题。给每个可能的token片段定义代价:基础代价是1(鼓励用更少的token),再加上边界惩罚和可选的小偏好项。
边界惩罚的设计很精巧。文本被标成一个个“类词单元”。完整落在一个单元内的token,或完整覆盖多个单元的token,惩罚为0;只跨一个边界且端点不完整的,给一个很小的惩罚;跨更多单元且不完整的直接禁止。
这样既开放了有意义的多词短语(进一步压缩),又抑制了语义不自然的跨界切分。
求解用动态规划,在字节序列上找总代价最小的全局最优路径。因为代价可加,得到的就是最优解。
更重要的是MCE不依赖合并列表,也不依赖token概率。它可以对BPE词表、Unigram词表、CNF词表,甚至其他方法构建的词表直接使用。报告里在固定的qwen250k词表上,MCE也比原BPE编码更省token。
03
实验
在 250K 词表规模下,针对英文网页文本,CNF‑MCE 对比 o200k base 压缩率提升 26.7%,对比 qwen250k 提升 32.4%。中文场景提升更为亮眼,相对 o200k base 压缩提升接近 50%。
为了验证 MCE 编码算法的通用性,研究者直接拿 qwen250k 这套原生 BPE 词表,抛弃 BPE 原生编码逻辑,改用 MCE 做切分。
结果显示,即便词表完全不变,只更换编码算法,也可以进一步减少 Token 数量;并且 MCE 与 BPE 的分词字节一致度多数场景高于 96%,切分结果不会发生翻天覆地的变化,具备落地迁移的可行性。

为了验证压缩效率的提升是否会影响模型能力,研究团队分别训练了 1.8B 和 8B 参数规模的大模型,并在 11 项英文基准上进行评测。

结果显示,CNF-MCE 在两种模型规模下都保持了与 BPE 基线相近的平均表现。其中,8B 模型在 GSM8K 上从 20.8 提升至 38.7,LAMBADA 也有明显提升。不过,HumanEval 从 11.6 降至 4.3,MMLU、TriviaQA 等任务同样存在不同程度的下降。
04
总结
长久以来,分词器在大模型研发中属于 “配角”。大家把目光聚焦模型深度、MoE 架构、海量预训练数据,但分词器是所有文本输入的第一道关卡。
BPE 已经陪伴大模型走过很多年,它简单好用,但词表浪费、扩展性受限的短板越来越突出。
CNF‑MCE 跳出 “合并构建词表” 的固有范式,证明不靠迭代合并,也能得到高压缩、高利用率的分词系统。
未来,随着长上下文、百万 Token 窗口成为标配,分词器的效率价值会进一步放大。更少 Token 意味着更低推理成本,更长的有效上下文,同样硬件可以服务更多用户。
END
关注+星标,获取AI前沿进展与开源一线动态