

9月21日,在智猩猩联合主办的2026全球AI芯片峰会上,迈特芯具身智能产品经理谢齐家带来了一场主题为《让具身拥有物理智能:3D AI芯片推动具身加速落地》的演讲分享。
谢齐家分享了公司为解决端侧VLA模型落地而设计的3D芯片方案。他认为,目前VLA模型正在经历三大趋势:数据飞轮推动模型参数规模持续变大、快慢系统协同提升动作流畅度、Few-shot模型将率先落地。在此背景下,端侧算力需在实时性、功耗、带宽之间实现平衡。
迈特芯核心技术为3D-IC。谢齐家在演讲中指出,只有 3D-IC 才能实现 10 tps/W 这样的能效水平。
在等带宽条件下,传统2D方案功耗最高约40多瓦,难以满足端侧要求,而3D-IC方案最高仅需约7W。在PPA微架构上,传统3D/2D IC共用统一总线,数据需要先经总线traffic再分发至各PE,耗时明显。迈特芯采用3D直连架构,让上层IO直接对应下层PE,显著缩短带宽访问路径,带宽利用率可提升至80%以上。
此外,谢齐家还提到,针对Transformer的算术特性进行优化、避免算子间的reshape overhead,也是PPA提升的关键贡献点。
迈特芯想做的,就是用3D存算协同架构创新,打破端侧大模型的内存墙以及功耗墙。
以下是演讲整理:
谢齐家:大家下午好。我作为迈特芯的具身智能产品经理,主要来分享一下迈特芯的芯片在具身场景的应用。我的分享主要分为以下几个部分。
01
VLA部署的三个趋势
VLA 是一个非常新的东西,它从 2024 年才开始被广泛研究,到 2026 年已经有非常多的模型了——从 VLA 到 WAM,再到现在的 MoT,同时也涌现了一批原生具身智能模型。
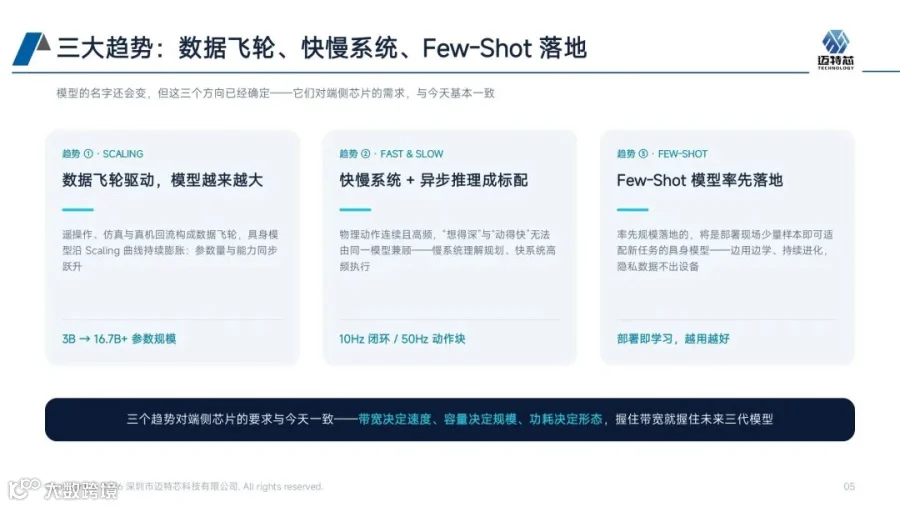
我们团队基于对机器人行业的观察,总结出具身智能模型部署的三大趋势。
第一个趋势是数据飞轮推动模型参数规模持续变大。 大家的真机数据从原先只有 1000 多个小时,到现在可能已经达到 5 万个小时。数据量的增长直接带来模型规模的扩张,从之前的 3B,到现在 16.B 以上的 VLA 模型都已经开始出现。
第二个趋势是快慢系统协同提升动作流畅度。 之前的做法是必须先把上一帧的运动结果捕获下来,才能进行下一步推理;现在大家都在用快慢系统来做,让整体动作更加平滑。
第三个趋势是 Few-shot 模型将率先落地。 我们做芯片的按道理应该多预演一代——也就是说,我们的芯片本身也应该具备 Few-shot 的能力。
芯片在做定义的时候其实非常担忧未来模型的演变。但我们的判断是:只要做好 Transformer 的加速,对于 VLA 这种应用的落地就已经有很大帮助了。
02
端侧算力三重硬约束

英伟达今年上半年做了一项研究:他们对自家所有芯片都搭建了一个非常理想化的性能模型,然后去分析当 VLA 负载 scale up 之后,这些芯片是否还能达到实时控制的要求。他们对失败的归因定位非常明确——之所以无法实现实时,是因为 memory-bound,带宽实际上只有大概 270GB/s 左右。

基于这样的分析,我们认为未来端侧 VLA 的算力需要在三个方面取得平衡:实时性、功耗,还有带宽。 迈特芯重点关注带宽和功耗这两项。
03
迈特芯3D AI芯片四大技术特点
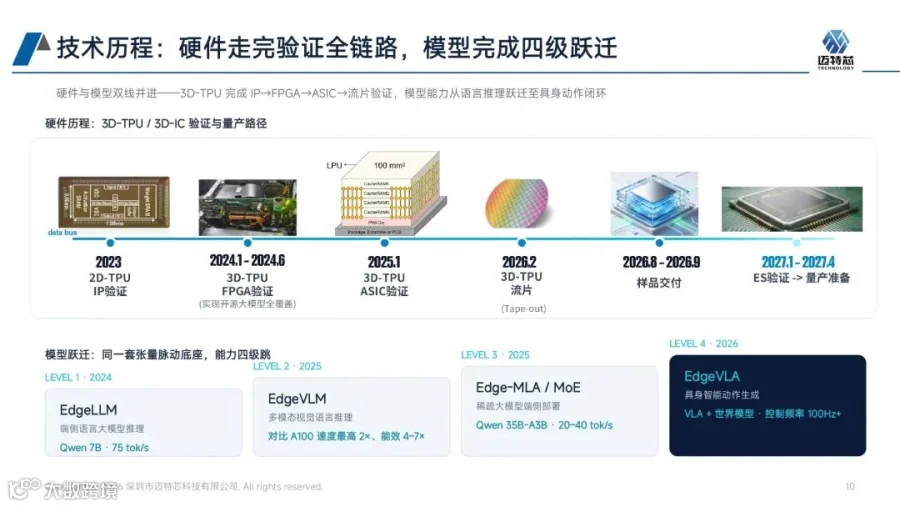
迈特芯从 2023 年开始,在孔雀计划结束之后筹备孵化公司,同步启动了这些产品的预研;到今年上半年正式投片;我们的产品将于明年 Q1 正式发布并销售。在模型支持能力上,我们从 LLM 到 VLM,再到后面的 MoE 以及 VLA,提供全链路的支持。
接下来介绍一下我们的技术特点。

在等带宽条件下( 600GB/s),如果用 2D 的方法去实现,它的功耗最高能到 40+W,这显然在端侧层面是不可能实现的。
使用迈特芯的 3D-IC 只需要最高可能7W左右就可以实现同样的带宽。这是 3D-IC 给我们带来的最大优势。此外我们的产线是采用 SMIC 和 CX 的全国产工艺。
此外还有一些 PPA 层面的微架构优化。
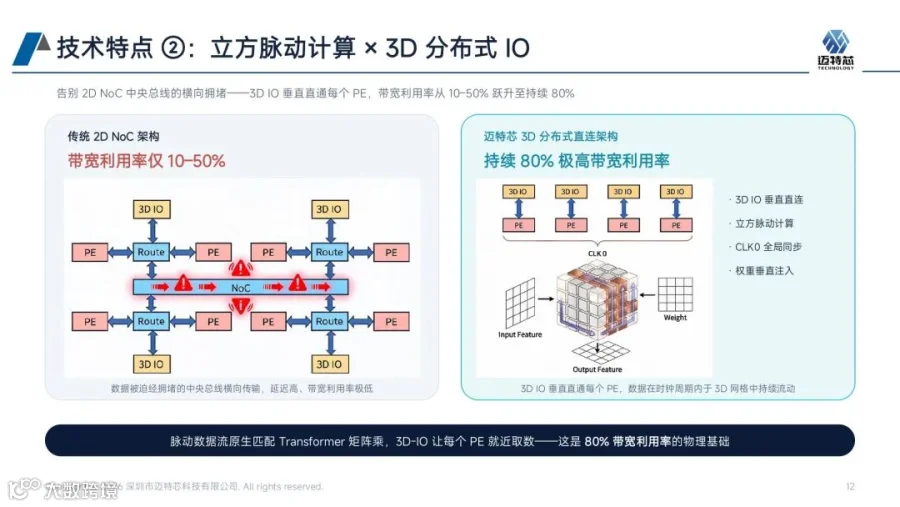
传统的 3D-IC 芯片、乃至 2D-IC 芯片,内部其实都有一条统一总线。数据进来之后,需要先在总线上经过一些 traffic,再搬移到每一个 PE,这个过程会浪费很多时间。
迈特芯采用的方案是用 3D 直连替代统一总线,上面一层的 IO 直接对应到下面的 PE,显著缩短带宽访问路径,把带宽利用率提升到 80% 。
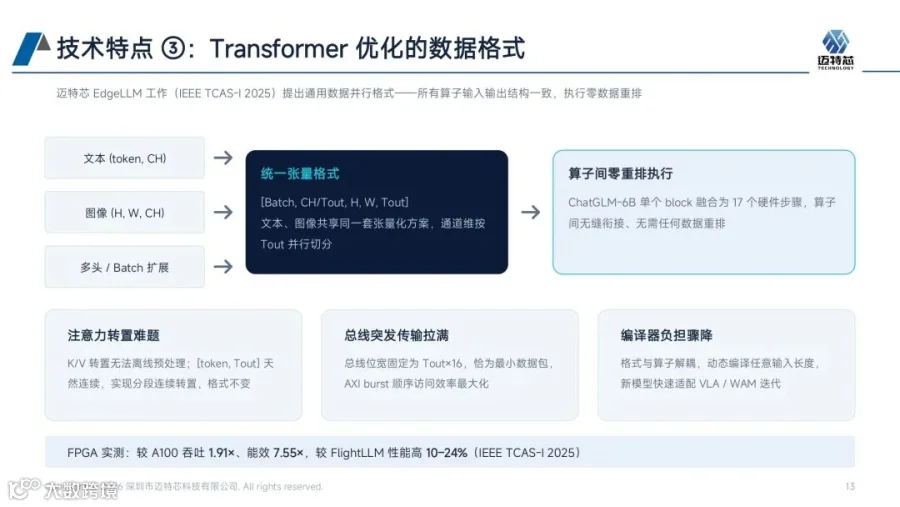
针对 Transformer 运算的特点,迈特芯对数据流做了特殊处理,避免了每个算子之间的 reshape overhead。这也是我们 PPA 提升的一个非常大的贡献点。
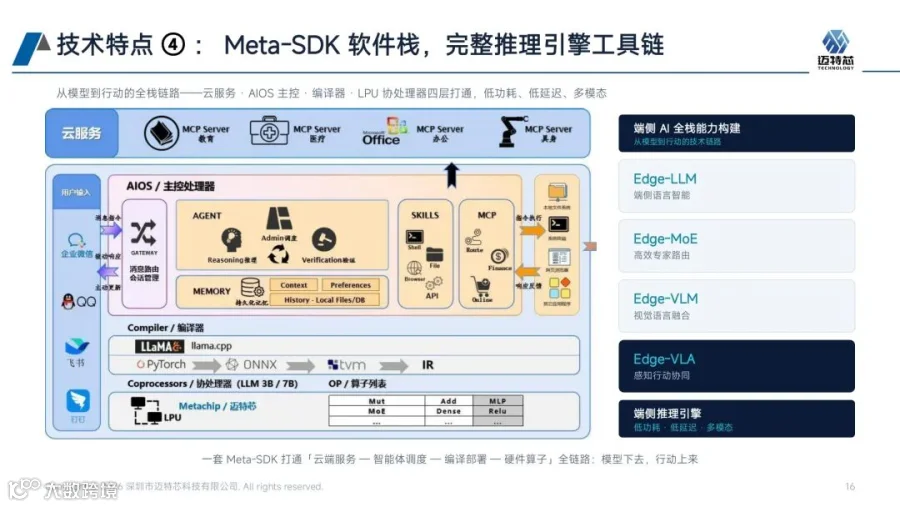
迈特芯也配套了基于 llama.cpp 构建非常完善的 SDK,芯片造出来之后让大家能用得上。
04
为什么说3D-IC是
一个非常好的端侧解决方案?
为什么说 3D-IC 是一个非常好的端侧解决方案?只有 3D-IC 才能实现 10 tps/W 这样的能效水平。
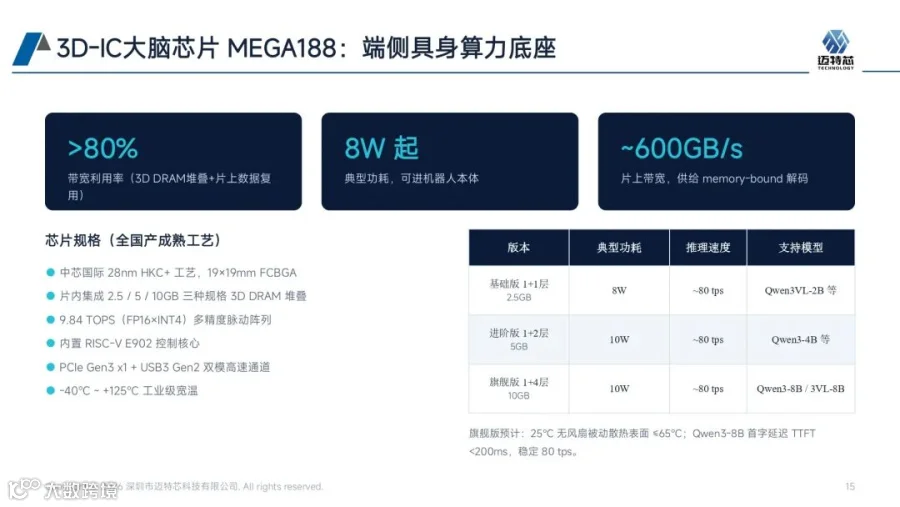
芯片的一些 specs:
带宽利用率:高达 80%,这是我们 PPA 提升最大的一个关键点;
功耗:非常低,典型只有 8-10W ;
带宽:600 GB/s;
容量配置:我们提供三款芯片。一款是 1+1 的配置,只封了一层 memory die,容量为 2.5GB;也可以选择封两层或者封四层,不同配置能承载的模型是不一样的,供大家根据实际场景选择。
最后和国内友商进行一下对比。

对比国内友商 A(同样采用 3D-IC),他们带宽利用率比较低。迈特芯相当于在一个更低的峰值 TOPS 和更低的能耗下,达到了和它差不多的性能;再加上我们的一些优化,整体的芯片成本也比较低。
对比国内友商 B(面向 VLA 场景,走 2D 路线),他们选择的是 2D 大算力的方式,堆到了 560 TOPS 的算力,实际上运行 VLA 模型也就实现了大概十帧左右。而迈特芯的效率差不多是它的十倍。
05
真机验证
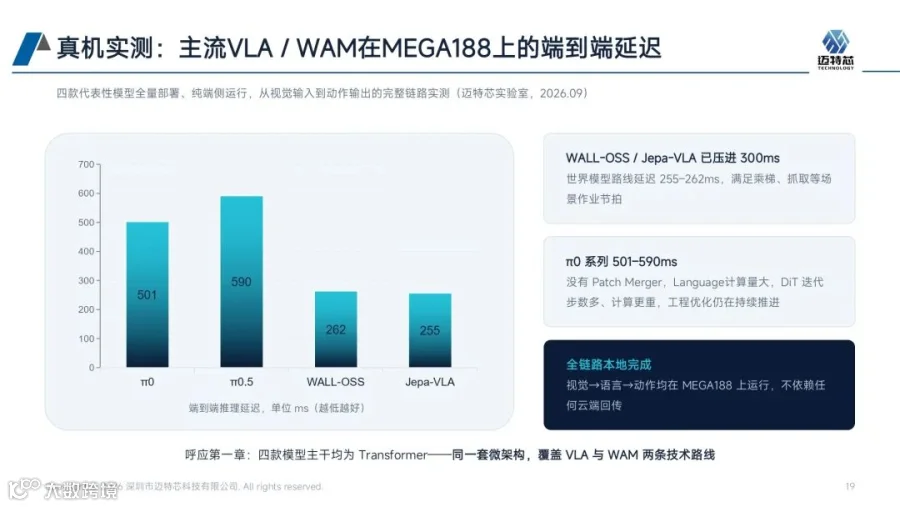
这是我们评测的一部分主流 VLA 模型在我们芯片上的延迟数据。这里需要特别说明 π 系列:因为它没有 PatchMerger,所以 Language 这边的 token 比较大,导致整体的 latency 偏长。而如果是基于 Qwen 系列这些具备比较好 PatchMerger 的模型——比如 WALL-OSS、Jepa-VLA 其实都已经可以压到 300ms 左右的端到端延迟。
当然,目前的成绩还不是最终结果,我们依然在紧锣密鼓地推进优化工作。大家未来上手芯片后,模型整体性能还会有一个较大的提升。

我们和普渡机器人做的一个应用落地:自主乘电梯。这是一个乍看之下比较奇怪的需求。后来跟他们聊了之后才发现,背后的原因是他们想拓展海外市场——海外有很多电梯,电控后台是不对外开放的,你想要落地,就必须让机器人自己去摁。这其实是一个非常不错的应用场景。

这是我们搭建的一个原型验证平台:我们预估最终的延迟小于 300 毫秒,整个任务大概只需要 5 秒左右就可以完成。

这是和自变量(X Square Robot)公司做的一个合作项目,把他们的模型部署到我们自己的端侧平台上,实现一个物流分拣的功能。
06
趋势判断
最后讲一讲我们对未来趋势的判断。
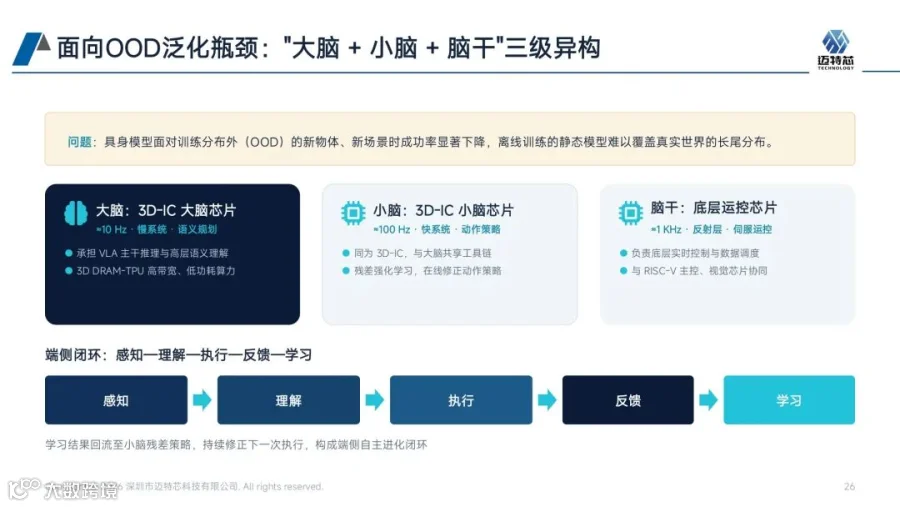
OOD 场景是现在 VLA 无法落地的一个最大的问题。
未来的异构算力应该是一个"大脑、小脑、脑干"这样的结构。我们也在小脑芯片上做一些基于残差 RL、或者 Few-shot 的适应性改进。
我们这个芯片真正到未来要落地的时候,Few-shot 应该会成为第一个落地的场景。我们这一代芯片虽然还不具备完全的 Few-shot 能力,但下一代已经开始预研了。
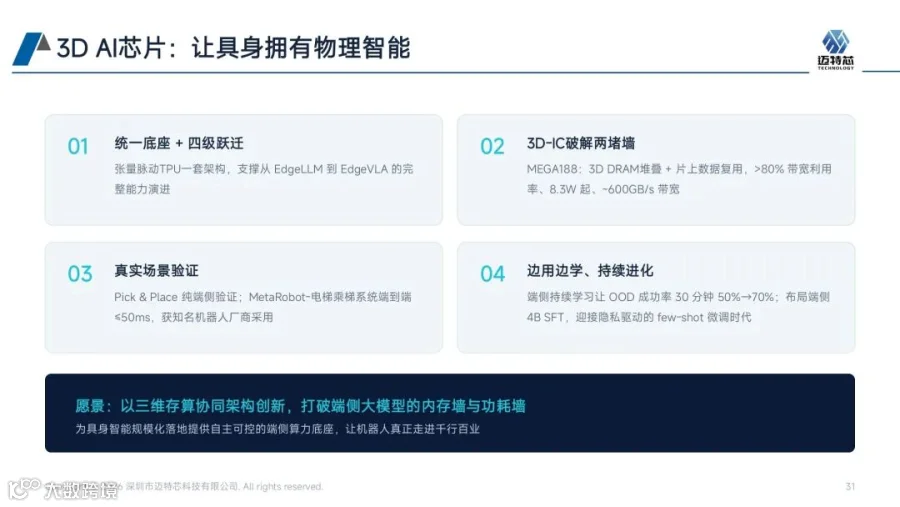
最后做一句总结:迈特芯希望以 3D 存算协同架构创新,来打破端侧大模型的内存墙以及功耗墙。
好的,谢谢大家。
END
关注+星标,获取AI前沿进展与开源一线动态