

AlphaFold 发布五年,蛋白质结构预测在新闻里常被说成「已经解决」。但在这期建模专场圆桌上,Pushmeet 认为离真正搞懂蛋白质还差得远:我们做的事其实是复现数据库里存的一个结构,「不等于我们搞懂了蛋白质的全部动态」;Sal 则强调这些模型确实很有用,只是它解的并不是大多数人想解的那个问题。
Pushmeet 说,我们总把蛋白质叫生命的积木,「这话我天天说,但我自己其实并不信」——蛋白质无序、形状随环境变,我们甚至不知道它真正稳定在哪个基态,也不知道它真实的结构分布是什么样。而现在做的事情,是复现某个人解出来、并存进蛋白质数据库里的一个结构,「就这么回事」,只不过碰巧很有用。
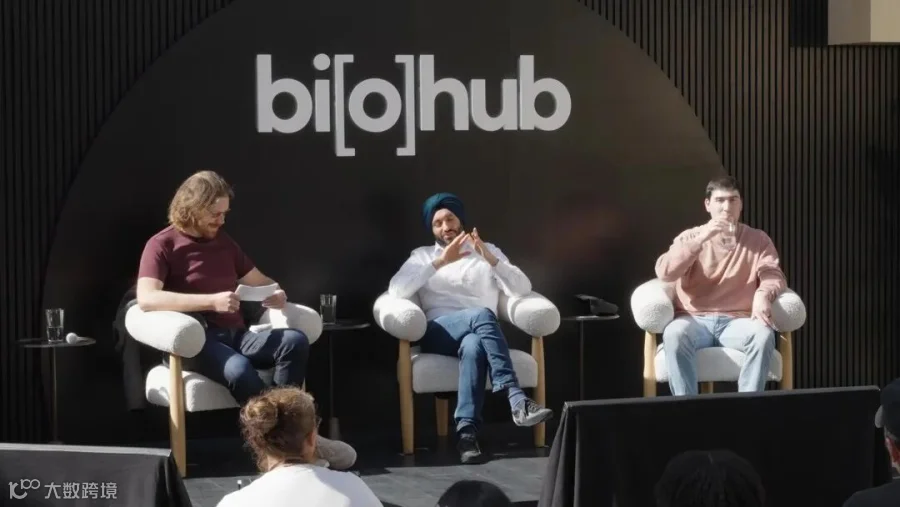
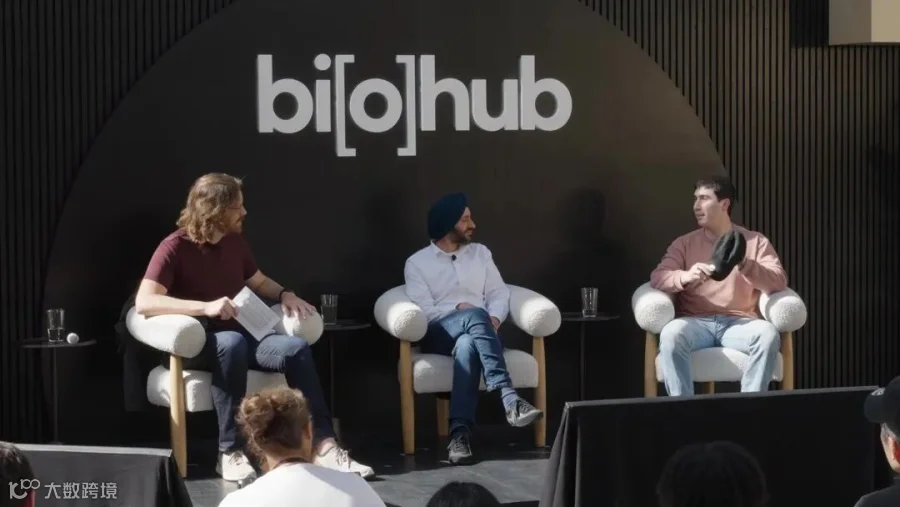
Pushmeet Kohli 是 Google DeepMind 研究副总裁,主管科学方向的 Science and Strategic Initiatives 单元,是 AlphaFold 2 论文作者之一,长期负责 AI for Science,也参与过 AlphaTensor、AlphaGenome、AI Co-Scientist 等项目。Sal Candido 是 Biohub 工程院士兼副总裁、EvolutionaryScale 联合创始人兼前 CTO,他在对话里谈的是 Biohub 想开放地与社区协作、先定义需要什么数据。这场对话从「数据上有没有苦涩的教训」谈起,延伸到先定义问题再决定解法空间、手工设计与归纳偏置的取舍、蛋白质折叠到底解决到什么程度、可解释性该对谁可解释,以及临床上还要等多久。他们的主要观点包括:
规模定律不是到处都在,很多时候工作量恰恰在于找到它。 Sal 说,关于规模定律有个误解,以为它到处都是、永远存在。他喜欢那种「多投算力、多投数据结果就更好」的情况,因为一旦成立,事情就变成一个工程问题,可以一直摇手柄;但很多时候,先得搞清楚什么情况下它才成立。
把容易生成的数据做大,不一定是对的做法。 Sal 说自己比较懒,有什么数据就用什么:用宏基因组序列训练蛋白质语言模型,里面很多序列根本不是真实完整的蛋白质,却照样提升性能。但如果你手上的数据没有解决目标问题所需要的信息和统计特性,就做不出想要的能力,你只能从有的数据里抽取信息再泛化。所以他看好 Biohub 的做法——走出去问,解决这个问题需要什么数据。
问题在先,解法空间要保持灵活。 Pushmeet 认为苦涩的教训不是「数据有没有用」这种结论,而是别用宗教式的心态想解法:我是做模型的,或者我是造数据的。做 AlphaFold 时,团队没有扩充蛋白质数据库的核心专长和资源,而这份数据是全世界科学家建起来的,所以投入只能放在建模上、追求最大回报;细胞基因组学则相反,数据还不到位,支撑不起造虚拟细胞这么大的野心。
归纳偏置在小数据时有用,数据变多后可能拖后腿。 Sal 同意 AlphaFold 2 里那些来自生物物理的直觉不是偶然,数据少的时候需要它才能出结果,但模型变大后可能发现你本来不知道的东西,而不完全正确的归纳偏置反而会拖后腿,中间有一个拐点。他还强调,做规模化本身也有很多手艺,包括改架构让它们更贴合用途。
蛋白质折叠只在概念层面解决了,我们复现的是数据库里存的结构。 Pushmeet 说蛋白质不是积木,它无序、形状随环境变,我们并不知道它真正稳定在哪个基态、真实的结构分布是什么样。他常和 John Jumper 聊这件事,值得庆祝的东西很多,但不能因此就停止资助蛋白质结构预测和蛋白质动力学的研究,因为才刚刚开始。
折叠模型解的并不是大多数人想解的那个问题。 Sal 打了个比方:想搞懂自行车怎么工作,结果在给车上的一根辐条建模;真正需要的是从辐条走到轮子、再走到整辆自行车,因为那才是大家想搞懂的东西。他说折叠模型还得继续做,它们只会越来越好,等我们把模型放到它们真正工作的生物学环境里,就能在更大的尺度上学到更多相互作用。
理解是必需的,但「可解释」要先问对谁可解释。 Pushmeet 说 AlphaFold 2 的置信度指标如果没校准,谁敢信它;它在行为和泛化上是可解释的,发布后大家还发现它是个很好的无序蛋白预测器。但对受限于人脑认知的人类来说,它并不可解释;对更大的模型来说,也许它可解释,只是我们看不懂。Sal 补充说,蛋白质语言模型的表征里不止有结构,还藏着功能和运动的信息,可解释性上还有一大堆东西没解锁。
基础研究该换个问法:不是改进百分之十,而是要做到十倍需要什么。 Sal 说,别问怎么改进百分之十,去问要做到十倍提升需要什么——不是说十倍那条路更容易走,而是它能让你把视野放宽,看到以前根本没采用过的解法,回到第一性原理去问这件事到底该怎么做。他也说百分之十和十倍两种思路都有价值,都应该做。Pushmeet 则说,AI 今天已经用在药物发现的每一个环节,要看到十倍百倍的加速,得先问加速的是什么;更大的加速,只有在我们对生物学模型理解得更好之后才会被解锁,而这个项目要建的正是这种模型。
数据上的苦涩的教训:谁会找到规模定律
Brandon:很高兴能来。今天早上太让人兴奋了,发布了一堆很酷的东西,我觉得生物科学的未来正在这里被宣布。这一场是建模专场,我们这儿都是做模型的人,所以聊到数据太自然了。聊数据的时候我常想的一件事,就是怎么把它规模做对,这就让我想到苦涩的教训,只不过换成数据这个角度重讲一遍。
不是做 AI 的朋友可能不知道,苦涩的教训说的是:能规模化的方法最终会赢,只要你能规模做得足够大,它就赢。所以我的问题,先从 Sal 开始:数据上有没有苦涩的教训?
Sal:肯定有。你得有对的数据,事情才成立。关于规模定律有个误解,就是以为它到处都是、永远存在,其实很多时候,工作量恰恰在于找到那条规模定律。我们做的很多事,就是想搞清楚:什么情况下,你多投算力、多投数据,出来的结果就更好?这种情况太好了,因为一旦成立,你就可以一直摇手柄,它就变成一个工程问题了,我喜欢这样。这跟架构有关,但更跟数据有关。如果你手上的数据没有解决目标问题所需要的信息和统计特性,你就做不出具备你想要的能力和理解的模型。你只能从你有的数据里抽取信息,再用它去泛化到数据之外。
Brandon:说到数据采集,你怎么判断哪些模态最好?还有个相关的问题:做模型的人是不是更倾向于做数据现成的问题,而不是对自己的目标最有用、或者对转化医学影响最大的问题?
Sal:确实。我不替所有做模型的人说话,但我比较懒,所以有什么我就用什么,这事有好的一面也有坏的一面。好的一面是,做传统机器学习的时候,大家往往追求最干净、质量最高的样本;但像我这种人,是跑到后面的储物间里翻箱倒柜,看别人剩的破烂里有什么。举个具体的例子,用宏基因组序列去训练蛋白质语言模型,这些数据质量并不高,我敢保证,里面很多序列根本就不是一个真实完整的蛋白质。可它照样能把模型性能提上去,不管是设计能用的真蛋白,还是理解我们已知的蛋白。这是好的一面。
但它也可能把你带到一个坏地方,就是你会想,那就把我们容易生成的数据规模做大吧。我不觉得这一定是对的做法。今天在这儿聊 Biohub 让我兴奋的一点就在这儿:它是走出去问,解决这个问题我们需要什么数据?这既关乎对的资源,也关乎对的社区。我们在 Biohub 想做的一件事就是开放地做、跟社区一起做,把整个社区往前推。这很关键,因为如果只有做模型的人,我们就会偏向已有的数据;如果只有生成数据的人,他们就会偏向容易生成的东西。但如果整个社区一路都能开放协作,你就能搞清楚自己真正需要什么数据,然后你才能找到那条规模定律。
先定义问题,再决定搜哪个解法空间
Brandon:Pushmeet,你怎么看数据上的苦涩的教训?
Pushmeet:Rich 还在我们这儿的时候我就在 DeepMind,当时就在想苦涩的教训这个说法。我从他最早在 DeepMind 那场演讲里得到的,并不是数据有没有用、或者我们该怎么看机器学习这种具体结论。我的理解是,他讲的是更概念层面的东西。
我们看问题的时候,常常用一种很宗教的方式去想解法:我是做模型的,或者我是造数据的。我觉得这才是那个苦涩的教训。你要是带着这种心态去做问题,可能做不成。问题在先,你的解法空间应该保持灵活,两条路都该试。你得理解自己要解决的是什么问题:如果它需要建模投入,那就投建模;如果它需要更多数据,那就去收数据。
当时机器学习界发生的事是,大家都在说,我们是机器学习研究者,数据集就在那儿,这是一份训练数据,这是一份测试数据,我们把模型优化就行了。这有问题,因为如果你的最终目标是解决问题,你就必须同时看这件事的两个方面。而进入这个过程的不只是数据和建模,还有专业知识。比如做 AlphaFold 的时候,我们是看现有数据集能做什么,因为我们没有那个核心专长,甚至也没有资源去说,我们把蛋白质数据库扩充一个数量级吧。全世界那么多机构和科学家投入建起来的这份数据,太宝贵了。所以在那里,你必须把投入放在建模上,追求最大回报。但在别的领域,比如细胞基因组学,我们用同样的思路问,用细胞乘基因的数据能做出什么?做了很多工作之后就很清楚,数据还不到位,支撑不起造虚拟细胞这么大的野心。这会让人们聚到一起去关注推进科学真正的难题,而不是宗教式地追数据生成或者建模的进展。
Brandon:这个回答我很喜欢。可落地的结论是什么?永远先定义问题,再去决定搜哪个解法空间。但更广一点说,在走向下一代转化医学的过程中,整个社区该怎么想这件事?
Pushmeet:我给刚进入这个领域的人的建议是,把自己当成一个跨学科的人。先理解问题:你为什么做这件事?你想达成什么?然后再想需要什么,是建模、是扩大算力,还是生成数据。理解问题极其重要,当然你也得建立自己的专长。
还有约束。也许你能生成的数据只有那么多,也许你能负担的模型规模就那么大。要理解这些约束,尽量快速失败,然后看哪些路线长期可行,能带你达到你想要的那种影响力。

手艺还是规模:AlphaFold 2 的艺术与第一性原理
Brandon:这就接上了我下一个问题。看建模这些年的演变,AlphaFold 2 基本上是一件艺术品,里面有很多精心手工设计的特征,解法的每一部分都是有意为之的思考。Google 或者说 Alphabet 有些工作还留在那个路子上,但整体共识似乎在往更可扩展、更通用的策略走。那某些问题上我们还需要这种手工艺式的解法吗?还是资源更应该先投在规模上?资源和钱是固定的,你可以投算力、投人才、投数据。这个取舍该怎么想?
Pushmeet:我们从第一性原理来看。构造一个更好的模型,那种艺术和手艺不是偶然的。我们做了很多实验,但背后是有愿景的。来自生物物理和生物化学的科学直觉告诉我们,氨基酸残基不是各干各的,它们会受其他残基影响,那我们就把它写进去。如果你从科学界学到了什么,就用上这些信息,给模型这个不公平的优势。这会让模型的数据效率高很多,因为它不用把所有东西重新学一遍。
我还得说,筛选整理好数据本身就是一门艺术。不是你说一句多塞点数据就行的,你把同样的数据复制一遍,那是原地踏步。所以关键不只是大数据,而是好数据,以及理解要取得进展所必需的数据覆盖范围。这本身就是一个更有意思、也更难的问题。
Brandon:Sal,你好像有想法。你怎么看?
Sal:我非常同意。这取决于要解决什么问题。数据少的时候,模型里多一点归纳偏置会帮到你,在小的数据规模下你确实需要它才能出结果。随着数据越来越多,有时候模型会发现一些你本来不知道的东西,而那个归纳偏置如果并不完全正确,反而会拖你后腿。事情变好的过程中是有一个拐点的。
不过我也想稍微反驳一下你这个问题,因为做规模化这部分里也有很多手艺。要把模型拿过来,用更多数据训练、投更多算力、做得更大,这里面有大量的算法工作。而且这还不只是基础设施层面,也不只是让模型推理跑得更快。我们看到的东西已经超出标准 transformer,走向更定制的架构。我不觉得我们以任何形式进入了后 transformer 时代,但我们确实在改这些架构,让它们更贴合用途、效果更好,哪怕面对互联网规模的数据。随着数据进来,挑战不只是筛选整理数据,或者挑下一批模型需要的信息,还包括在每一步、每一个规模上问:什么才是能把这些信息榨到极限的对的架构。
蛋白质折叠真的解决了吗:动力学与设计的空白
Brandon:你看现在蛋白质结构预测的状况,新闻里会说这个问题已经被解决了。但你要是跟我那些朋友聊,他们会说,这儿还差得远呢。功能、动力学、设计,全都还是完全开放的问题。AlphaFold 2 发布到现在大概五年了,确实有进展。Pushmeet,你觉得还会有一次大跃迁吗?解决这些问题有什么卡点?是我们还没有对的数据、算法或者想法,还是只是时间问题?
Pushmeet:科学的路子是这样:先把一个问题单独拎出来,然后一步一步往前推。大家说蛋白质折叠问题已经解决了,从概念层面讲,确实有进展。
但你想,我们总说蛋白质是生命的基本单元,是积木。可蛋白质不是积木,它也不像积木那样工作。这话我天天说,但我自己其实并不信。蛋白质极其复杂,它是无序的,它的形状会随环境变。John Jumper 和我以前经常聊:我们到底要解决什么?我们并不知道蛋白质真正稳定在哪个基态,也不知道它真实的结构分布是什么样的。我们做的事情,其实是复现某个人解出来、并且存进蛋白质数据库里的一个结构,就这么回事。只不过碰巧它很有用。但这不等于我们搞懂了蛋白质的全部动态。在最高的层面上,跟大家说我们有进展,比较容易;但这个圈子里的科学家都知道还剩多少活没干。值得庆祝的东西很多,但我们不能因此就停止资助蛋白质结构预测和蛋白质动力学的研究,因为我们才刚刚开始。
Brandon:那最大的卡点是什么?如果你能挥一下魔杖,说这个东西再多一点就好了,就能加速功能、动力学或者设计的研究,你会想让什么出现?
Pushmeet:我的背景挺杂的。一开始是做安全研究,后来做计算机视觉、贝叶斯理论、判别式机器学习、深度学习、AI 写代码,最后才做科学。所以你问这个问题的时候,我心里的那个计算机视觉研究者对冷冻电镜图像特别兴奋。我当时想,这个蛋白质数据库的数据算什么?我应该直接去源头干活,我应该去看冷冻电镜的原始图像。那些结构我不想要,它们肯定丢了一大堆信息。我应该直接在冷冻电镜图像上做。要是能做出那种规模、又有足够数据支撑的模型,把里面记录的动力学和分布信息提取出来,那该多好。我试过,但这事需要更多的工作。
Brandon:还有活要干,但你觉得这条路能拿到那些信息?
Pushmeet:对。我觉得总有一天,可能有比我更厉害的人来试一把,然后我们就能往前走一步。
理解还是能造出来:费曼那句话在 AI 时代
Brandon:Sal,你怎么看?
Sal:这事挺有意思,因为这些模型确实很有用,但它解的并不是大多数人想解的那个问题。它解决的是一个非常具体的目的,当然你也可以拿它干别的,比如用它来设计新的蛋白质,而这本来并不一定是你一开始想做的事。
我打个比方,我们现在做的这些模型,就像一个人想搞懂自行车是怎么工作的,结果他在给车上的一根辐条建模。这些模型可以越做越好,但你真正需要做的是从辐条走到轮子,再走到整辆自行车,因为那才是大家想搞懂的东西。接着这个比方说,现在的情况像是大家想拿自行车的模型去设计皮卡上的一个零件。等我们把这些模型放到它们真正工作的那个生物学环境里去,我们就能在更大的尺度上学到更多相互作用。我觉得方向就在这儿。但我也同意,折叠模型还得继续做,因为它们只会越来越好。
Brandon:说到设计,费曼有句名言:我无法创造的东西,我就没有真正理解。现在这个世界是,你完全不用理解,也能很轻松地把东西造出来。那么一边是帮人理解的模型,一边是能一次性给你做出一个皮摩尔级结合物的神奇黑箱,你觉得理解这件事有多重要?
Sal:在 AI 出现之前很久,我们就在用神奇黑箱做设计了,从某种意义上说,那到现在也还是有用。但理解真的非常重要,这也是我琢磨 AI 时想得最多的几件事之一。这些模型有太多东西可以学。当智能越来越便宜、越来越唾手可得,你就可以拿它去学世界上越来越多的东西。但你怎么把知识从机器里拽出来,让我能看懂?也许这只是我自己的一种冷门的好奇心。我觉得要学的东西太多了。
Brandon:很多科学家是真的想把事情搞明白,终点对他们来说可能没那么重要。但我们在这儿是要解决转化医学这个问题的,对吧?
Sal:我觉得你越往里钻,就越能找到继续往前推的正确方式。有一件事我特别有感触:这些模型里的信息比我们知道的多得多。比如我们在模型的可解释性上做了很多工作,你能从里面挖出大量信息。大家都知道蛋白质语言模型在它的表征里学到了某种结构的概念,但我们还发现了关于功能和运动的信息。
就算是我们现在手上的这些模型,也还有一大堆东西没解锁。我们要提升它们的能力,搞懂这些就很重要。说到底,你把这么多信息压缩进一个模型,是期待里面能长出一个世界模型的。它是怎么干活的?它怎么设计出一个蛋白质?它把进化里的信息压缩进了这个模型。除了能产出对我们有用的东西,光看看里面有什么,就肯定有东西可学。
Brandon:Pushmeet,你怎么看?设计和理解,选哪个?
Pushmeet:我的看法不太一样,我认为某种程度的理解是必需的。我说说是什么程度的理解。AlphaFold 并不完美。当时那个测试集上,AlphaFold 2 的全局距离测试分数大概在九十。但就算它能到九十五,如果它的预测局部距离差异检验,也就是置信度指标,完全没有校准,谁敢信它?你想象一下,它神奇地给出了正确答案,还告诉你它非常有把握,结果你照着做了一年,最后发现全错了。不确定性度量的校准极其重要。
从这个意义上说,我们是理解 AlphaFold 2 的,我们在理解它的行为上进步很大。但这跟理解它内部是怎么算出答案的不一样。在这一点上我同意 Sal,可解释性问的是:它为什么能成?它为什么给出这个答案?从最高层面讲,AlphaFold 2 在行为和泛化能力上是可解释的,而我们在发布之前并没有把这些全搞清楚。我们把 AlphaFold 2 发布出来、公开了权重之后,大家发现它是个特别好的无序蛋白预测器,它能判断出蛋白质里哪些部分是无序的。这说明它有泛化能力。
但可解释性还有另一个问题:对谁可解释?如果你说的是对人这个理性系统可解释,受限于人脑的认知和算力,那 AlphaFold 2 不可解释。但如果你问的是,对一个更大、更复杂的模型来说,它内部是怎么运作的、是否可解释,那也许它是可解释的,只是我们看不懂。作为 AlphaFold 2 的使用者,我们确实需要知道它能干什么、不能干什么。搞清楚它的行为特征、长处和局限,极其重要。没有这些刻画,我们就不能随便用这些模型,否则它们不但帮不上忙,还会害了我们。
Brandon:所以你的观点是,严格意义上的可解释性并不是必需的,真正该花力气的是确保模型值得信任,让人类能据此做出可以行动的决策。
Pushmeet:没错。可解释性也是看谁在看,是谁在解释它?如果是一个人类科学家想解释模型是怎么做出预测的,那是一个问题;而把模型的激活层交给另一个大得多的 LLM,问它你能不能预测 AlphaFold 会怎么做,那是另一个问题。也许未来那些前沿模型真能预测出来,还能给出一套理论,说清 AlphaFold 2 是怎么理解、怎么得出结果的。
量化预测:临床上多久能看到 AI 的成果
Brandon:我们只剩两分钟提醒了,所以最后一个问题,两位都答一下。AI 在不久的将来真有可能让人类健康出现大幅改善。我喜欢量化预测,所以你们猜,还要多久我们才能在临床上看到 AI 的成果?Pushmeet,你先来?
Pushmeet:我觉得「在临床上看到 AI 的成果」这个问法本身就有问题。今天 AI 已经用在药物发现的每一个环节里了,从这个角度看,它早就到了。
但如果你问的是什么时候能看到时间线加速十倍甚至一百倍,那下一个问题就是:我们在加速什么?是先导化合物优化?是靶点发现?还是临床前或者毒理?
未来几年里——也正是今天宣布的这个项目极其重要的原因——我们得啃下生物学里一些硬骨头。只有到那时候,我们才能真正解锁那种彻底改变药物发现的加速。AI 会一直用在那些最终进临床的东西上,但更大的加速,只有在我们对生物学模型理解得更好之后才会被解锁,而这个项目要建的正是这种模型。
Brandon:好,谢了。Sal,能简短说一句吗?我们快没时间了。
Sal:回答这个问题,我特别想戴上我那顶生物黑客的帽子。关键是得想清楚,什么才叫把整个领域往前推。我们真正想看到的,是结果被改变。什么时候能有一种药完全由 AI 做出来?我不知道,这很难预测。但我确实觉得进展会来得非常快,因为这些工具已经在被用了。
回到你说的基础研究和基础理解,我职业生涯很早的时候在 Google 学到一件事:有时候换个问法更容易下手,别问怎么改进百分之十,去问要做到十倍提升需要什么。不是说十倍那条路更容易走,而是它能让你把视野放宽,看到以前根本没采用过的解法。你会回到第一性原理去问,这件事到底该怎么做,我们怎么才能真正把它推起来。百分之十和十倍,这两种思路都有价值,都应该做。
我很高兴 Biohub 有一个漂亮又高远的使命宣言:治愈、预防或管理所有疾病。要真想做这件事,你就必须搞清楚十倍的做法是什么。能有这样的机会去做,非常难得。
Brandon:太棒了,谢谢两位。谢谢你们坐在真正的热座上,非常有意思。
原视频:Why AlphaFold Didn't Solve Protein Folding — Pushmeet Kohli, Google DeepMind & Sal Candido, Biohub
https://www.youtube.com/watch?v=NufiHZfMwaw
中文播客:在小宇宙App搜《播客快译》,或直接访问下面的链接
https://www.xiaoyuzhoufm.com/episode/6ac9c0cbe742e36efcc0b64b
编译:磊哥Thomas