

——《象信 · 系统一》系列之二
先说一句可能让你不太舒服的话:请你只返回 JSON 格式,不要输出任何解释——这行提示词,是你系统里最脆弱的一行。
不是因为它写错了。是因为它在请求一件本来就不该由生成模型做的事。
那行提示词背后,你写了多少代码
先看一段我们都很熟悉的东西:
python resp = client.chat.completions.create( model="deepseek-v4.1-flash", messages=[{"role": "user", "content": f""" 从下面这段简历里抽取信息,只返回 JSON,不要输出任何解释。 格式:{{"name": "...", "years": 0, "city": "..."}}
简历:{resume} """}], ) raw = resp.choices[0].message.content |
然后真正的工程量从这里开始:
python raw = raw.strip() if raw.startswith("```"): # 它给你套了代码围栏 raw = raw.strip("`") raw = raw.split("\n", 1)[1] if "\n" in raw else raw if raw.startswith("json"): raw = raw[4:] try: data = json.loads(raw) except json.JSONDecodeError: # 它多写了一句话 / 少了个括号 / 用了中文引号 / 结尾有个逗号 data = retry_with_stricter_prompt(resume) if not isinstance(data.get("years"), int): data["years"] = int(re.search(r"\d+", str(data.get("years", ""))).group() or 0) |
这里面每一个 if,都是你为"让模型好好说话"付出的代价。
而最讽刺的是:这些分支你测不完。模型的输出是采样出来的,同一个输入换个批次、换个版本,可能就走进另一条分支。你不是在写解析器,你是在给一个不可控的输出做防抖。
问题不在提示词,在接口形状
我们换个角度看这件事。
你要的是什么?三个值:name(字符串)、years(整数)、city(字符串)。
你发出了什么?一段自然语言指令,附带一个"请按这个格式"的请求。
你收到了什么?一段自由文本——然后你用代码把它硬拗回三个值。
所以整条链路上有三处不确定:
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
三处不确定叠起来,就是那种"时不时有几条请求解析失败"的日常。
而这不是模型不够聪明。是我们用错了接口。
换一种问法:不生成答案,只选答案
象信(系统一模型)的做法是:你先把答案的"形状"定死,它只在这个形状上分配概率。
同一份简历,同一个需求:
json { "state": { "resume": "……候选人的简历原文……" }, "questions": { "has_backend_exp": { "type": "noul", "instructions": "`resume` 是否写明候选人在工作中使用过 Python 做后端开发?" }, "years_bucket": { "type": "choice", "instructions": "`resume` 里体现的后端工作年限落在哪一档?", "criteria": { "lt1": "不足 1 年,或完全没有写明", "1to3": "1 到 3 年", "3to5": "3 到 5 年", "gte5": "5 年以上,且有明确的时间线" } }, "city": { "type": "choice", "instructions": "`resume` 提到的现居城市是哪一个?不在列表里就选 unknown。", "criteria": { "hangzhou": "杭州", "shanghai": "上海", "beijing": "北京", "shenzhen": "深圳", "unknown": "文中没有提到,或不属于以上任何一个" } } } } |
返回:
json { "has_backend_exp": { "type": "noul", "noul": 0.93 }, "years_bucket": { "type": "choice", "choice": "3to5", "confidence": 0.78, "probabilities": { "lt1": 0.02, "1to3": 0.11, "3to5": 0.78, "gte5": 0.09 } }, "city": { "type": "choice", "choice": "hangzhou", "confidence": 0.94 } } |
三点变化:
- 没有一句话需要解析。
has_backend_exp.noul是 0.93,是数字;years_bucket.choice是"3to5",是枚举;city.choice是"hangzhou"。你的代码直接if。 - 不存在"格式不对"。
输出按构造就是结构化的——模型只能在你给的选项上分配概率,不可能返回 "3-5年"这种你没定义的写法。 - 不存在"编造类别"。
如果简历里没写城市,它只能在 unknown上给高概率,不会凭空给你一个"苏州"。
注意我把 years 改成了 years_bucket。这不是偷懒——这是设计。后面会说为什么。
两种接口形状放在一起对比,差别一眼就能看出来:

同一份简历,两种要三个值的办法
「抽取」不是象信的活,但「从候选里挑」是
这里必须坦白一件事:象信不生成文本,也不能凭空抽出一段任意长度的文字。
所以"从简历里抽出姓名"这种需求,不要直接交给它。正确做法是两步:
python # 第一步:用正则找出候选(确定性的活交给代码) candidates = re.findall(r"姓名[::]\s*([\u4e00-\u9fa5]{2,4})", resume) # 也可能来自一个姓名库、一个下拉框、一个已有的候选人列表
# 第二步:让象信从候选里挑 resp = client.system_one( state={"resume": resume, "candidates": candidates}, questions={ "name": Choice( instructions="`resume` 里这份简历的姓名,是 `candidates` 中的哪一个?都不对就选 none。", criteria={**{c: c for c in candidates}, "none": "候选里没有正确答案"}, ), }, ) |
这个模式在文档里叫预解析取值:先把可能的值找出来,再让模型做它擅长的判断——"这几个里面哪个对"。
同样的思路适用于日期:
python questions = { "year": Choice(instructions="`text` 里提到的年份是哪一年?", criteria={...}), "month": Choice(instructions="月份?", criteria={...}), "day": Choice(instructions="日期?", criteria={...}), } # 组装、比较、算"还有几天"——全部在代码里做 deadline = date(int(a["year"].choice), int(a["month"].choice), int(a["day"].choice)) days_left = (deadline - date.today()).days |
为什么不让它直接输出 2026-10-15? 因为象信不生成文本,而且它的数值推理弱——计数、算术、日期比较都不可靠。日期的正确处理方式是:让它从有限选项里挑出年、月、日各部件,再在代码里组装和比较。见日期抽取。
一句话总结这条边界:
判断交给模型,计算留给代码。
为什么我把 years 改成了 years_bucket
假设你的代码里要判断"是否满 3 年后端经验"。
错误做法:让它输出一个数字,然后 if years >= 3。
为什么错:象信的数值推理弱,让它数"2019 到 2022 是几年"不可靠;而且简历里的时间线常常有断层、有实习、有兼职,连人也要想一下。
正确做法:让它判断语义上的档位("不足 1 年" / "1 到 3 年" / "3 到 5 年" / "5 年以上"),档位的边界你在 criteria 里写清楚。代码里比较的是枚举,不是算术。
如果确实需要精确的年限,就在代码里算:正则把起止时间抠出来 → datetime 算差值 → 象信只负责判断"这段经历算不算后端经验"。
这条边界可以画成一张图:
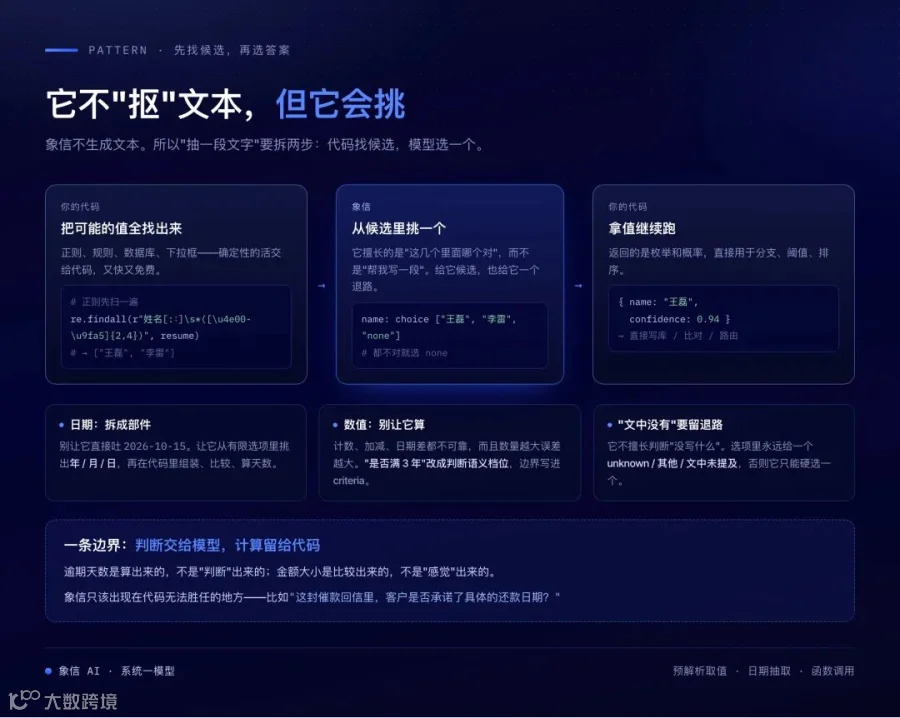
先找候选,再让它挑:代码负责确定性,模型负责语义
同一个答案,问法不同,置信度差 5 倍
日期抽取里记录了一组对比,我觉得是整篇文档里最值得抄走的一条经验。
同一份文档、同一个答案(16 日),两种问法:
|
|
|
|
|---|---|---|
|
|
|
0.16 |
|
|
|
0.91 |
答案一样,但一个几乎不可用,一个可以直接自动填。
原因不难理解:条件句让它同时做了两件事——判断"是不是写明月日的公历日期"和"这是几号"。而它擅长的是单点判断。
文档里的结论是:一道题只问一件事,前提条件交给代码去判断。
那个手册里还有一条同类经验:抽年份时,它一开始把 1900–2050 全表列成选项,结果这个"几号"题的置信度中位数只有 0.17、输入 token 要 179,103;改成先用正则取文中实际出现过的年份再列选项之后,token 降到 60,576,自动通过数从 2 涨到 17。
给选项不要给全集,要给"这份材料里可能出现的那个子集"。 选项越少越准,这是违反直觉但实测有效的一条。
实测:解析失败换成了什么
回到开头那个问题:改用"先找候选、再让它挑"之后,"解析失败"这件事为什么消失了?
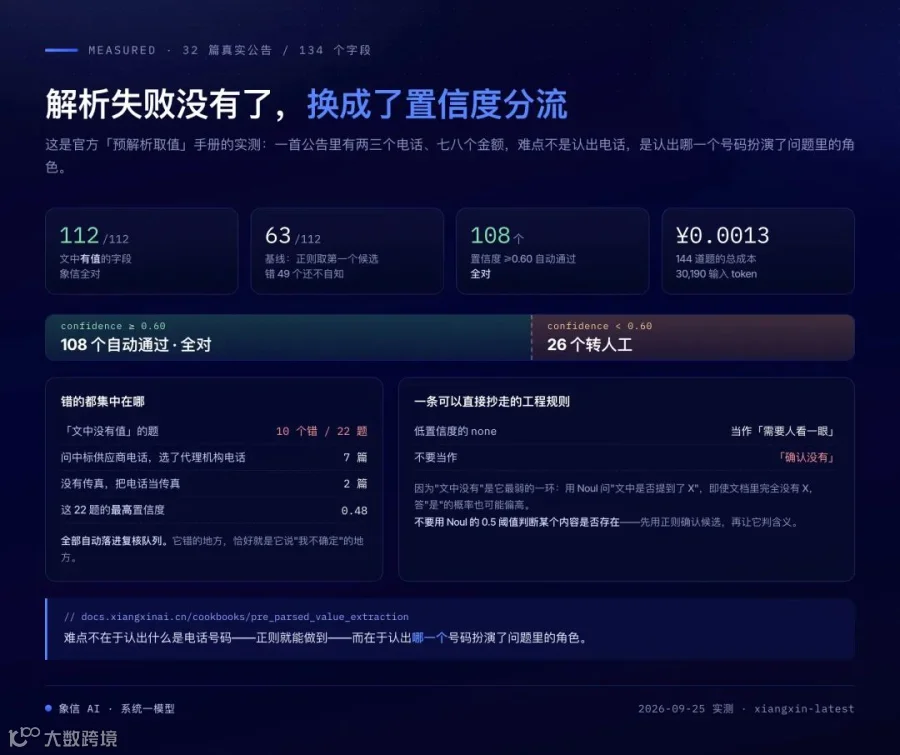
实测:112 个有值字段全对,108 个高置信度自动通过
官方那个预解析取值的实测数据可以直接回答。32 篇真实公告、134 个字段(电话 79、金额 31、邮箱 24,其中 22 个字段文中根本没有值):
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
总数是 32 次请求、144 道题,30,190 输入 token,约 ¥0.0013。
而且看它错在哪:10 个错误全部集中在"文中没有值"那 22 题上——7 篇问中标供应商电话,它选了代理机构的电话;6 篇没有传真,2 篇把电话当成了传真。但那 22 题里,置信度最高的也只有 0.48,全部自动落进了复核队列。
这就是关键:它不只是给答案,它把自己不确定的地方标出来了。
对比一下基线为什么差:正则取第一个候选,对 63 个错 49 个——它根本不知道自己错在哪,因为"哪个号码是哪个角色"这件事正则表达不了。文档里那句话说得很好:
难点不在于认出什么是电话号码——正则就能做到——而在于认出哪一个号码扮演了问题里的角色。
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 判断本身错了 |
|
也会 |
| 错了你不知道 | 会 |
|
最后两行是关键,也是我们不想含糊的地方:象信不会消除"判断错误",它只消除"接口错误"。
区别在于,大模型的错你事后才知道——靠解析失败、靠人工抽查;象信的错它当场告诉你——每个答案都带 probabilities 和 confidence。
python ans = resp.answers["applicant_phone"]
if ans.choice == "none" and ans.confidence < 0.6: flag_for_review("可能文中没有这个字段") # 不急着下结论 elif ans.confidence >= 0.85: auto_fill(ans.choice) # 有把握,自动填 elif ans.confidence >= 0.5: flag_for_review(ans.choice) # 拿不准,标记待复核 else: send_to_human(doc) # 没把握,交给人 |
文档里还有一条工程建议值得抄走:低置信度的 none 要当"需要人看一眼",而不是当"确认没有"。因为"文中没有"恰恰是它最弱的一环——不要用 Noul 的 0.5 阈值去判断某个内容是否存在。
必须说清楚:什么时候不该用它
写到这里,必须放一段劝退。因为官方文档里就明明白白记着一次"我们没赢"的实验。
我们用 60 条中文行情指令测了函数调用——自然语言 → 函数名 + 参数:
|
|
|
|---|---|
|
|
83.3% |
|
|
98.3%(59/60) |
文档里原话是:
只看准确率,本任务应该用大模型。
差距主要在集合参数("同时取出这几只股票"这种要选多个的)和角色分配("宁德时代和比亚迪一年的滚动相关系数"——它把基准选成了沪深300)。
但它也不是没有用处,因为它有概率:
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
| 0.8 | 30% | 100% |
|
|
|
|
阈值 0.8 时,它只处理 30% 的指令,但这 30% 全对;剩下 70% 交给大模型的 tool calling。
这才是它在这类场景里的正确用法:不是替代 tool calling,而是给你一个便宜的前置分流器。 官方文档把这叫意图路由。
还有一条更有意思的发现:这 60 条里,象信错误调用的平均置信度是 0.50,正确调用是 0.73——它确实"知道自己什么时候不行"。
什么时候该用哪种
我把判断标准压成三句话:
|
|
|
|---|---|
|
|
象信
|
|
|
生成式大模型 |
|
|
代码找候选 → 象信从候选里挑 |
|
|
就用大模型
|
一个常见的组合是:象信负责分流和把关,大模型负责真正需要写作的部分。先用象信判断意图,只把需要推理的请求交给昂贵的大模型——这叫意图路由,能省下相当一部分调用。
今天就试一次
找一段你现在用"只输出 JSON"处理的数据——一条要抽字段的简历、一张要分流的工单、一段要打标签的评论。
改成这样的结构:
-
把答案的形状写出来(是分类?是档位?是是非?) -
用 criteria把每个选项的边界写清楚,包括"其他 / 未提及" -
如果答案是一段文字,先用正则或规则找出候选,再让它从候选里选
你会发现:写的"问题"变多了,写的"解析代码"变没了。
下一篇:《一次调用,问 24 个问题》——聊聊你为"一个问题一次请求"多付了多少钱。
动手入口
-
领免费额度(注册送 ¥5):console.xiangxinai.cn -
从候选里选值:预解析取值 -
日期怎么处理:日期抽取 -
自然语言 → 函数调用:函数调用 -
哪些别交给它:象信 2.0 已知短板
数据说明:文中示例为便于说明做了简化;生产使用前请用你自己的数据评估准确率,并参考「已知短板」确认边界。