

——象信 · 系统一系列之三
先算一笔账。
假设你要从一张客服工单里判断 24 件事:该转哪个组、顾客多不满、有没有退款意图、要不要人工介入……
做法 A:一个问题一次调用,24 次请求。
做法 B:24 个问题放进同一次请求。
很多人会本能地选 A——因为那是"聊天的习惯":一问一答、一步一步来。但象信不是聊天机器人,它是数据库。而数据库用法的第一原则是:
能用一次查询解决的事,不要查二十四次。
为什么多问几个问题"几乎是免费的"
关键在于象信的工作方式:state 只读一遍。
你的代码 ──state + 24 个问题──▶ 象信 ──一次响应,24 个答案──▶ 你的代码 (一次请求) (并行评估每个问题) |
对比一下两种开销的构成:
|
|
|
|
|---|---|---|
|
|
|
1 遍 |
|
|
|
|
|
|
|
并行,一次往返 |
|
|
|
不会,互相隔离 |
|
|
|
|
所以"多问一个问题"的成本,从"再调一次模型"变成了"多写几十个 token"。
文档里有一句话建议直接背下来:
多问一个可能用不上的问题,几乎是免费的。
官方那组对比实验
官网首页有一段对比视频,物理条件是这样的:同一张客户工单,同样 24 个问题。
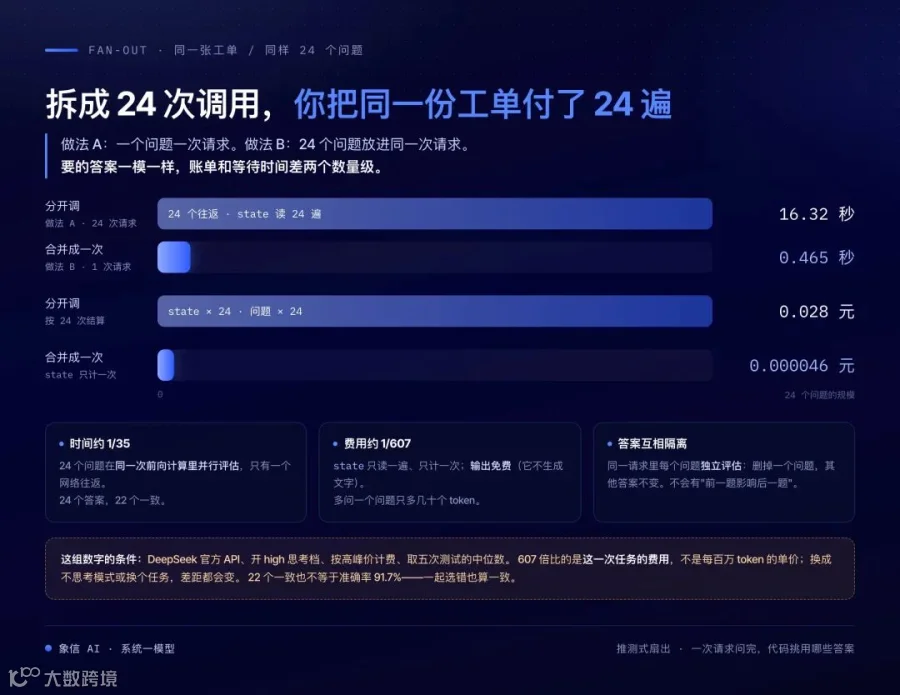
拆成 24 次 vs 合并成一次:时间与费用的量级差
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
时间约是对方的 1/35,费用约是对方的 1/607。24 个答案,22 个一致。
这几个数字必须把条件说全,不然就成了标题党:
-
用的是 DeepSeek 官方 API、开 high 思考档、按高峰价计费、取五次测试的中位数; - 607 倍比的是这一次任务的费用,不是每百万 token 的单价
; -
22 个一致不等于准确率 91.7%——两个人选了一样的答案,也可能一起选错了; -
换个任务、换成不思考模式,差距都会变。
但有一点是结构性的、跟具体模型无关:左边要为每个问题写一遍答案,右边不需要写答案。 象信输出免费,因为它不生成文本。
三个必须合并的理由
1. 省钱:state 只计一次
计费依据是 usage.input_tokens,包含 state + 所有问题的 instructions 和 criteria。
如果你把 state 拆成 24 次请求,同一份工单你就付了 24 遍钱。
按 ¥0.042/百万 token 算,一份 500 token 的工单,拆成 24 次就是 12,000 token;合并成一次,state 那 500 token 只算一遍,剩下的是问题本身的量。
2. 省时间:没有串行等待
24 次请求 = 24 个网络往返 + 24 次排队 + 24 次模型启动。
合并成一次 = 1 个往返,问题在同一次前向计算里并行评估。
对实时场景(输入框提示、表单校验、Agent 执行前的检查),这一条比省钱重要得多。
3. 更准:问题之间互相隔离
这一条最少被提到,但可能是最重要的。
在生成式大模型里,多个问题是顺序生成的——前面的回答会成为后面的上下文。于是:
-
第 3 题的回答措辞会影响第 7 题的判断; -
你调整了第 1 题的问法,第 5 题的结果莫名其妙也变了; -
想定位"到底哪一步错了",只能靠猜。
象信里,同一请求的每个问题独立评估:一个问题的答案不会成为另一个问题的隐藏上下文。删掉一个问题,其他答案不变。
这意味着你可以放心地一次问 24 个"假如用得上"的问题,然后在代码里挑用哪几个。
这就是「推测式扇出」
这个模式在文档里叫推测式扇出(Fan-out):
把代码可能用到的问题全部问上,包括只对部分输入有意义的问题,由代码事后挑选有用的答案。
举个具体的例子。一张工单进来,你不知道它是什么类型,但你可以在一次请求里把所有可能用到的判断都问了:
python QUESTIONS = { # 分流用 "topic": Choice(instructions="`ticket.message` 应该由哪个组处理?", criteria={...}),
# 安全用(只在少数工单上有意义,但问了也不花钱) "asks_for_code": Noul(instructions="`ticket.message` 是否在索要验证码或密码?"), "claims_staff": Noul(instructions="发件人是否自称平台工作人员并要求转账?"),
# 情绪用 "anger": Score(instructions="顾客的愤怒程度?", criteria=["平静", "有些不满", "明显愤怒", "扬言投诉"]),
# 只有"退款类"工单才用得上——但照样先问 "refund_amount_mentioned": Noul(instructions="`ticket.message` 是否提到了具体退款金额?"),
# 只有"物流类"工单才用得上 "mentions_order_id": Noul(instructions="`ticket.message` 是否提到了订单号?"), }
resp = client.system_one(state={"ticket": ticket}, questions=QUESTIONS) a = resp.answers
# 代码决定用哪些答案——用不上的直接忽略 if max(a["asks_for_code"].noul, a["claims_staff"].noul) > 0.7: return "security_review" # 安全信号优先
if a["topic"].confidence < 0.75: return "human_triage" # 分类没把握,交给人
if a["topic"].choice == "billing" and a["refund_amount_mentioned"].noul > 0.6: return "refund_fast_track" # 只有这条路径用到它
if a["topic"].choice == "logistics" and a["mentions_order_id"].noul > 0.5: return "logistics_with_order" # 另一条路径用到它
return "queue_" + a["topic"].choice |
注意 refund_amount_mentioned 和 mentions_order_id 这两个问题——大多数工单根本用不上它们。但它们只多花几十个 token,却省掉了"发现是退款工单后要再发一次请求"的往返。
用不上的答案,忽略它就行。
什么时候才需要第二次请求
不是所有问题都能塞进一次。判断标准文档里写得很清楚:
不拿到第一个答案,代码就无法构造第二个请求。
只有两种情况符合:
- 需要按答案去查更多数据再放进 state
。比如先判断"这笔订单属于哪个平台",然后去那个平台的数据库里取详情; - 下一题的选项取决于上一题的答案
。比如在很深的类目树上逐层走。
除此之外,都应该在第一次请求里一起问。
文档里还有一句提醒,我觉得写给自己看的成分更多:
编程智能体比人更容易养成"一次调用只问一个问题"的习惯。
这个我们深有体会。你让 AI 帮你写代码,它很容易写出"一个问题一次请求"——因为那是它见过的对话式 API 的写法。所以我们在象信 Skill 里明确告诉智能体:把同一状态下的问题尽量合并到同一次调用里。
拆问题 vs 拆请求:一个容易混淆的区别
这两件事经常被混为一谈:
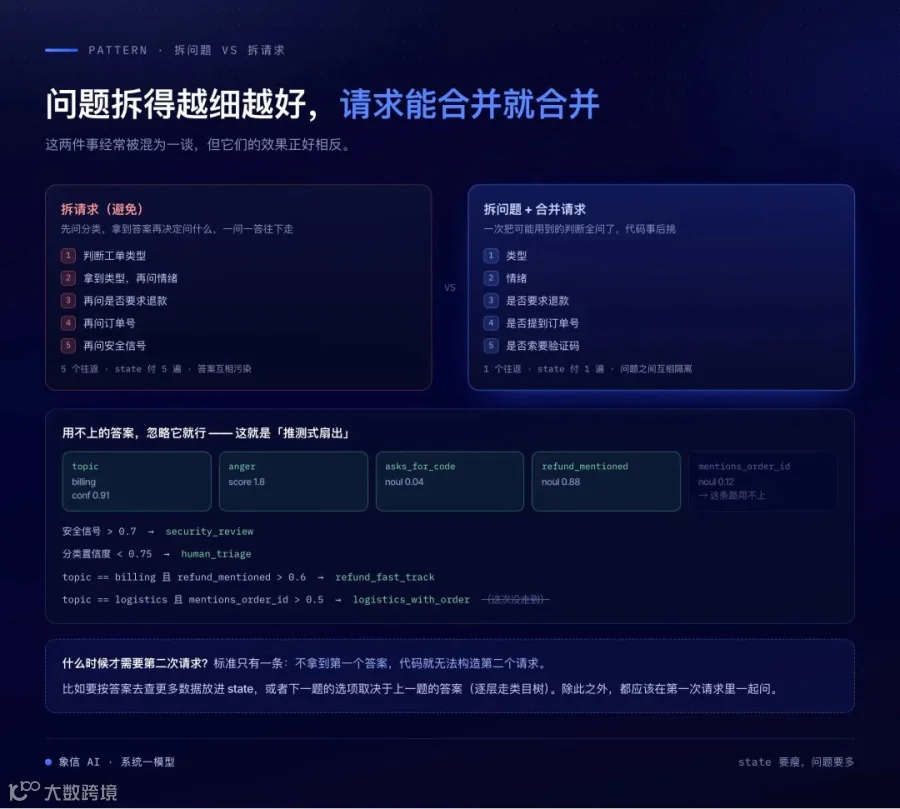
拆请求 vs 拆问题:一个越少越好,一个越细越好
|
|
|
|
|---|---|---|
| 拆问题 |
|
|
| 拆请求 |
|
|
正确的组合是:问题拆得越细越好,请求能合并就合并。
比如判断"这家供应商靠不靠谱",不要问一个大问题,也不要分成多次请求,而是:
python { "has_license": Noul(instructions="`supplier.docs` 里是否包含营业执照信息?"), "price_too_low": Noul(instructions="`supplier.quote` 是否明显低于 `market.avg_price`?"), "has_delay_complaints": Noul(instructions="`supplier.reviews` 里是否提到过延期交货?"), "has_quality_complaints": Noul(instructions="`supplier.reviews` 里是否提到过质量问题?"), } |
一次调用问完四个原子问题,然后在代码里按你的权重合成:
python score = ( 0.35 * (1 - a["price_too_low"].noul) + 0.25 * a["has_license"].noul + 0.20 * (1 - a["has_delay_complaints"].noul) + 0.20 * (1 - a["has_quality_complaints"].noul) ) |
业务重点变了,改一个系数就行,不用重写提示词。
一个提醒:别把 state 撑爆
多问问题几乎免费,但多塞 state 不是。限制写在这里:
|
|
|
|
|---|---|---|
|
|
|
422 max_tokens_exceeded |
|
|
|
422 max_tokens_exceeded |
|
|
|
422 |
|
|
|
422 |
不会悄悄截断——超了直接报错,这一点比"静默丢内容"要好。
而且能放进去不等于放进去最好:state 里无关内容越多,判断越容易被干扰,"文中没有"也更难判断。所以正确顺序是:
-
先用关键词、向量检索或规则把内容缩小到相关部分; -
再发送; -
然后在这份精简的 state 上尽可能多地问问题。
state 要瘦,问题要多。 这是用好象信最省事的一条经验。
今天就试一次
挑一个你现在"一个问题一次调用"的地方——最典型的是分类之后还要再做几个判断的那种流程。
把后面几步的判断提前合并到第一次请求里:
-
列出这条路走完之后可能会用到的所有判断; -
不管用不用得上,全部写成问题放进第一次请求; -
代码里按实际分支挑答案用。
你会发现请求数从 5、6 次降到 1 次,而代码里多了几行"忽略用不上的答案"——那几行不花钱。
下一篇:《不知道就说不知道,是一项工程特性》——聊聊 confidence 到底该怎么用。
动手入口
-
领免费额度(注册送 ¥5):console.xiangxinai.cn -
推测式扇出:patterns/fan-out -
原语总览:primitives -
并行提问实战:并行提问 -
状态怎么组织:状态
数据说明:官网对比实验对应特定任务、配置与样本(DeepSeek 官方 API、high 思考档、高峰价、五次中位数),已在上文说明条件;文中数字为任务级费用对比,不是单价对比。价格与限额以官网当前公布为准。