

2026年,字节Seed完成一轮面向产品化的组织调整。年仅30岁、博士毕业两年的秦禹嘉接过大旗,出任Product Posttrain-Work团队负责人。
该团队主要面向B端与办公场景,致力于将Agentic模型深度整合进产品,提升任务规划、工具调用及最终交付的稳定性。其核心目标是满足客户简洁明了的需求:用户只需提供资料,Agent即可明确任务、进行长程规划、自动补全信息、精准调用工具,并交付可直接使用的结果。
从WebCPM让模型像人一样搜索组织材料,到ToolLLM学习组合上万种API,再到UI-TARS实现看懂屏幕、操作键鼠,秦禹嘉的研究始终围绕一个核心:模型能否在外部环境中连续采取正确行动。
校园科研:从“读懂解释”走向“自主探索”
早期的自然语言处理研究中,模型往往依赖简单的标签判断,缺乏对判断依据的理解。秦禹嘉参与的一项早期研究聚焦于此:能否将标注者的自然语言解释转化为模型可学习的规则,使其在面对措辞不同但语义相近的新句子时,仍能借助解释做出准确判断?
2016年进入清华大学电子信息科学与技术专业后,秦禹嘉于2019年赴南加州大学访问研究,参与完成了ICLR 2020论文《Learning from Explanations with Neural Execution Tree》。该研究尝试将自然语言解释转换为模型可用规则,并有趣的是,他与另一位作者王子祺因贡献相同,通过抛硬币决定了共同第一作者的署名顺序。
本科毕业后,秦禹嘉在清华攻读计算机博士,并在微信Pattern Recognition Group担任研究实习生。随后,他转向更基础的问题:如何让模型在不从头训练的情况下,持续吸收新数据并保留已有知识。2021年的《Knowledge Inheritance》和2022年的《ELLE》正是这一方向的成果,标志着其研究从理解自然语言解释深入到高效获取与更新知识。
2022年,秦禹嘉的研究方向正式转向“工具学习”,核心问题变为:当模型缺乏完成任务所需的信息或能力时,能否主动寻找并使用工具?
技术突破:构建模型的检索与执行能力
WebCPM:记录人类寻找答案的过程
2023年,秦禹嘉作为第一作者发表WebCPM论文。该研究并未直接将问题和答案交给模型,而是记录了人类寻找答案的全过程。针对需要查阅多份资料才能回答的问题,WebCPM让标注者在使用网页搜索界面时,留下搜索、浏览和组织答案的操作记录。
通过整理5,500组问答、125,954条支持事实及121,330次网页搜索动作,WebCPM将原本隐性的检索过程转化为可观察、可训练、可评测的行为数据。这使得模型能够学习在意识到信息缺失时主动向外寻找,并在获取材料后判断哪些内容值得纳入最终答案。
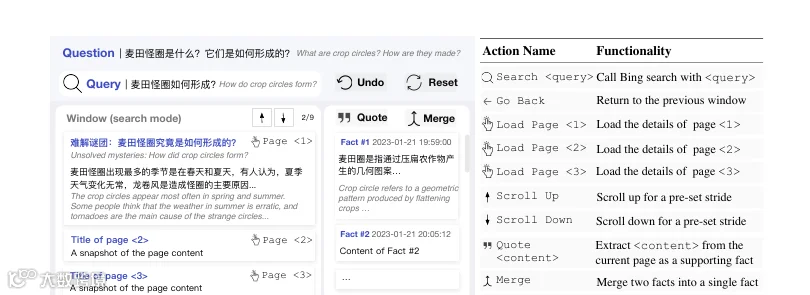
图片来源:WebCPM论文中的人工搜索界面,ACL Anthology
ToolLLM:从查找信息到调用服务
解决“找到信息”的问题后,下一步是“调用外部服务完成任务”。2023年,秦禹嘉与梁时浩共同发表的ToolLLM搭建了一套涵盖数据构建、模型训练、API检索及评测的工具学习框架,覆盖16,464个真实世界REST API和49个类别。
ToolLLM的关键创新在于处理调用失败的情况。它设计了搜索不同执行路径的方法,当一次调用未能推进任务时,模型能够回退并尝试另一条路径。秦禹嘉将这一过程概括为:理解指令、制定计划、调用工具、接收环境反馈、修正行动。这不仅要求模型能发出调用,更要求其在首次调用未果时仍具备后续处理能力。

图片来源:ToolLLM论文中的ToolBench构建与训练流程
UI-TARS:从API接口到图形界面
虽然API有明确的文档说明,但普通用户更多面对的是网页搜索框、表格单元格和文件夹等图形界面(GUI)。要让AI真正替人完成任务,必须让其看懂屏幕内容并执行点击、输入等操作。
秦禹嘉参与的UI-TARS研究将模型的行动空间从结构化API推进至图形界面。作为原生Agent,UI-TARS以屏幕截图为输入,不依赖预设页面结构,而是通过识别界面元素、判断下一步行动,利用鼠标和键盘完成任务。该模型在感知、定位及GUI任务执行等10多个基准上取得了领先表现。
随着能力提升,安全风险也随之增加。GUI Agent可能面临点错按钮、误读权限或在未授权区域行动的风险。秦禹嘉指出,GUI能力的后训练数据需与潜在滥用风险一起权衡,确保模型在用户授权范围内行动。

图片来源:UI-TARS论文中的GUI任务执行示例
创业实践:从“知识创作”到“行为创作”
2024年1月,秦禹嘉成立北京序智科技有限责任公司,旨在将专家的工作方法转化为可执行任务的Agent。以撰写行业研究报告为例,资深研究员具备确定问题、比较来源、剔除过时数据、追查证据不足处并最终成文的完整方法论。序智科技的目标是让专家将这些方法教给Agent,解决专业经验难传授、复杂任务需人反复拆解执行的痛点。
公司致力于实现专家创建的Agent和工作流的可分享、复用甚至交易,推动从“知识创作”向“行为创作”的转变。这一理念很快获得资本认可,序智科技完成千万级人民币天使轮融资,投资方包括英诺天使基金和水木清华校友种子基金。

入职字节Seed:执掌工作Agent业务
2024年7月,秦禹嘉加入字节Seed,研究方向聚焦于基于大语言模型和视觉语言模型的Agent。2026年8月,随着Seed组织架构调整,秦禹嘉担任新成立的Product Posttrain-Work团队负责人。
该团队主要服务B端应用,负责Agentic模型的整合与发布,针对办公场景优化模型能力,支持豆包及海外版Dola的任务模式。与面向C端对话的Chat团队不同,Work团队重点关注用户发出指令后,模型如何稳定地规划、执行并交付结果。
这一职责与此前Seed发布的模型方向高度契合。Seed2.1在项目规划、文档处理、工具使用和结果整合等方面,强调现实工作流中的交付质量,而非仅关注静态基准分数。对秦禹嘉而言,这是其过往几条研究线在产品层面的首次交汇:模型不仅要理解资料、使用工具、应对界面变化,更要在任务模糊、工具可能失败的真实环境中,完成让用户敢于直接使用的交付物。
相较于实验室中的benchmark评分,实际使用才是更有意义的评测。对Agent而言,真正的价值不在于完成一次漂亮的演示,而在于能在复杂的工作流程中交出用户可信、可用的结果。


