一名开发者每月向 AI 公司支付 200 美元,白天写代码,夜间运行 Agent 测试,其实际调用的模型服务价值可能高达上万美元;而另一名同价位用户仅偶尔整理会议纪要。两人贡献收入相同,消耗的计算资源却相差数十倍。
这一矛盾在 2026 年 9 月底随着 OpenAI 调整 ChatGPT 订阅体系而具体化:200 美元的 Pro 套餐 Token 额度削减近半,同时推出 500 美元新档位。表面是套餐调整,实质是模型公司对每美元背后计算资源补贴的重新定义。
研究机构 SemiAnalysis 将 OpenAI、Anthropic 及 MiniMax、Moonshot、智谱等国内外厂商的套餐置于同一账本下测算,试图厘清用户支付的月费究竟能换取多少计算资源。
200 美元订阅背后的算力账单与成本倒挂
传统 SaaS 软件边际成本低,研发成本可随规模摊薄;但大模型订阅不同,每次对话、代码生成及 Agent 执行均消耗推理资源。用户支付固定月费,厂商却承担随使用量增长的可变成本。
SemiAnalysis 估算显示,Anthropic 订阅业务仅贡献约 10% 的收入,却占用超过 40% 的推理算力。这不仅是营销预算,更是改变算力生意利润结构的关键支出。

图表|Opus 5.5 与 GPT-6.1 Sol 的订阅 API 等值比较

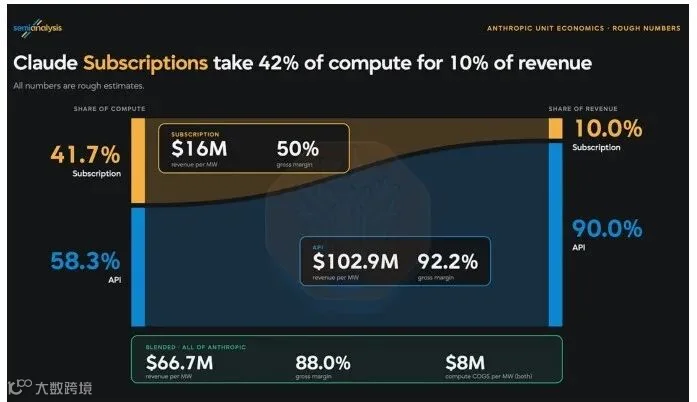
图表|Anthropic 订阅业务的收入与推理算力占比
从数据中心经济学视角看,核心稀缺资源是可持续交付的推理吞吐量。相同算力分配给高折扣订阅用户与按量付费 API 客户,产生的收入截然不同。SemiAnalysis 的 Tokenomics 模型推算,每兆瓦收入降幅可达约 3,600 万美元(注:此为模型推算结果,非官方披露的真实数据中心损失)。
订阅业务服务于三条转化路径:培养开发者习惯以转向 API 或企业采购;通过高频用户案例降低新用户门槛;利用真实数据识别有价值的 Agent 场景。长期收益需能抵消短期推理成本,否则补贴将从获客工具变为毛利侵蚀源。
OpenAI 削减额度,Anthropic 实行模型分层
OpenAI:取消重度用户额外折扣
测试数据显示,OpenAI 200 美元套餐调整后,GPT-6 Astra Token 容量下降约 49%,Sol 系列也大幅下调。由于 GPT-6.1 Sol 缓存读取 API 价格同步下降,其 API 等值订阅价值跌幅甚至超过 Token 数量跌幅。
新推出的 500 美元套餐在 Astra 用量上仅比旧版 200 美元套餐高约 21%,但其主打的 300 tokens/s Ultrafast 推理速度具有独立价值。调整后,100、200 和 500 美元套餐的单位 Token 价值基本趋同,OpenAI 正将订阅体系改造为更线性的算力定价机制。

图表|OpenAI 200 美元套餐调整前后对比
Anthropic:通过模型分层控制成本
Anthropic 在同一 200 美元 Claude 套餐中,对不同模型实行差异化额度限制。测试显示,Sonnet 5.5、Opus 5.5、Fable 5.1 的 API 等值额度分别约为 12,529、11,726 和 2,485 美元。Fable 还有独立的额度约束,不可简单累加。
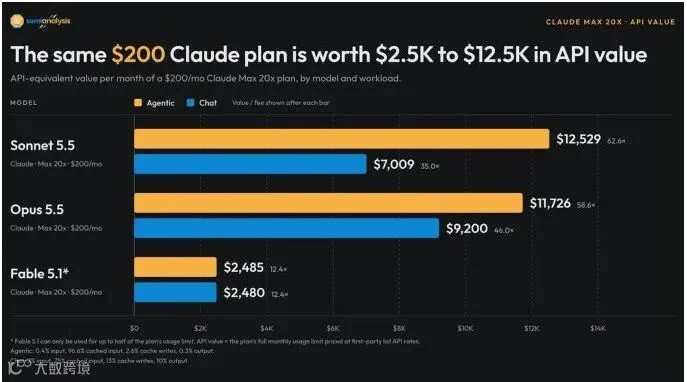
图表|同一 Claude 200 美元套餐,不同模型的等值额度差异
在日常主力模型层级,Claude Opus 5.5 的 API 等值额度(约 11,726 美元)约为 GPT-6.1 Sol(约 2,084 美元)的五倍。若直接比较 Token 数量,前者约 286 亿,后者约 102 亿,差距约 2.8 倍。但需注意,OpenAI Pro 套餐无类似 Claude 的五小时限额,高峰期集中执行任务的用户更容易充分利用月度额度。
隐蔽的定价权:藏在 Token 汇率里
API 服务公开输入、输出及缓存价格,而订阅服务通常仅展示消耗百分比。厂商拥有两层定价权:公开的美元月费,以及内部额度与 Token 之间的隐性汇率。
研究者通过大量模拟请求,剔除不完整计量区间,将估计误差收敛至 ±5%。测试发现,Token 分为四类:未缓存新输入、写入缓存输入、读取缓存历史上下文、模型生成输出。其中输出成本最高,缓存读取最便宜。对于 Agent 而言,长对话和多轮工具调用反复读取相同上下文,缓存命中率直接决定实际工作负载成本。
测量存在边界,例如缓存读取累积到一定量进度条未变化时,研究中暂视为免费。因此,脱离具体模型、任务结构和套餐谈统一“性价比”易产生误导。


5 倍价值差距不等于 5 倍亏损
API 等值额度并非真实推理成本。假设 API 毛利率为 92%,模拟显示:若用户耗尽全部额度,Opus 5.5 估算毛利率约为 -369%,Fable 5.1 约为 1%;若平均利用率仅为 20%,则分别约为 6% 和 80%。

图表|模型层级、额度利用率与估算订阅毛利率
这揭示了类似健身房会员的经济学:大量轻度用户平衡少数重度用户的资源消耗。但在 Agent 时代,后台持续运行可能导致订阅利用率从低频消费转向高频生产。
此外,模型推理效率改善未必自动让利给用户。例如 Fable 5.1 缓存读取价格下调 75%,但订阅 Token 限额未同步提高;GPT-6.1 Sol 缓存读取价格下调约 50% 后,OpenAI 也未按比例增加订阅 Token。单位成本下降可能诱发更多自动化任务尝试,导致总推理需求上升。
中国模型仍在补贴开发者,策略各有侧重

图表|中国模型订阅计划与国际厂商的对比
相比 OpenAI 收紧额度,中国厂商仍在通过不同方式补贴开发者:
- MiniMax:主打高额度。以 MiniMax-M3 计算,各套餐 API 等值约为月费的 19—24 倍,档位越高单位价值越高。
- 智谱:按模型分层。使用 GLM-5.3 时,API 等值约为月费的 7.7—11.6 倍;换成 GLM-5.3-Flash 后降至 1.3—2 倍。
- 月之暗面(Kimi):鼓励升级。以 Kimi K3 测算,API 等值约为月费的 2.5—7.5 倍,高档套餐单位价值提升明显。
国内厂商也开始通过电商渠道销售订阅产品,但渠道扩张无法改变每次调用均需付出计算成本的事实。需注意,上述比较基于偏向 Agent 的工作负载(缓存读取占比极高),不宜直接套用于普通聊天用户。

第三方应用的尴尬:模型公司收回应用层利润
直接购买 Anthropic 第一方订阅,在部分模型比较中可获得比 Cursor、Devin 等第三方产品高出 9 倍以上的 API 等值额度。拥有模型和基础设施的厂商,即使提供宽松额度,其订阅毛利率仍可能高于依赖外部 API 的第三方应用。

图表|Anthropic 第一方订阅与 Cursor、Devin 的额度比较
然而,Token 额度并非软件价值的全部。第三方应用若能以更少 Token、更高成功率完成任务,仍具独立经济价值。第三方工具需承担 IDE、索引、沙箱等产品成本,而模型厂商可按自身成本结构分配资源。Agent 产品的收费基础正从转售 Token 转向交付成果,企业愿为权限控制、合规及可靠性付费。

终局:重新定义软件定价
用户对理想 AI 订阅的期待是固定月费获得无限服务,而厂商追求收入与计算消耗匹配。Agent 普及放大了这一矛盾。未来市场可能分化为三个层次:普通消费者使用固定月费;专业用户购买高价套餐获取速度与并发优势;企业及复杂 Agent 工作流按 Token、任务或结果计费。
OpenAI 通过削减额度降低补贴,Anthropic 利用模型分层改善利润率,两者最终可能走向相似的经济结构。行业关注点将从 ARR、DAU 等指标,转向任务成功率、缓存复用率及单任务毛利。
一种可能的方向是“基础月费+超额计量”模式,结合传统 SaaS 与云计算计费优势。最终胜出的 AI 公司,未必是补贴力度最大的,而是能让每单位计算资源完成最多有价值工作的那一家。
资料与图表说明
资料来源:Andrew Megalaa、Max Kan、Dylan Patel,SemiAnalysis,《Anthropic Subscriptions Offer 5x+ More Value Than OpenAI》,2026 年 10 月 5 日。