

新智元报道
新智元报道

科幻成真了?
2026年,AI for Science 领域风向骤变。AI Agent 正从代码助手走向真实科学实验室,不再是科幻小说情节。
8月,Nature 报道量子计算公司 Pasqal 利用 AI 实现量子领域「Vibe Coding」。同月,Anthropic 联合 QuEra 让 Claude 学会调节真实量子计算机激光器。9月,OpenAI 与 MIT EQuS 宣布 GPT-5.6-Sol 深度接入实验室系统,自主运行超导量子芯片测量实验。
AI 已长出「手」和「眼」,开始操作昂贵、精密的量子硬件。
然而,这一突破背后隐藏着巨大风险:你真的敢让 AI 独立操作量子实验室吗?
如果 AI 自己做实验,光看答案够吗?
假设 AI Agent 独立校准一台价值数千万的量子设备,次日提交报告显示指标提升 42%。你敢采信吗?
在真实量子工程中,决策成本极高:稀释制冷机降温需数天,激光器寿命按小时损耗,量子比特相干时间仅几十微秒。Agent 的一次误判可能导致芯片报废或数月心血付诸东流。
核心问题并非「最终结果是否正确」,而是过程是否可靠:它是否执行了必要的实验?是否正确解读数据?是否在获得最优解后仍盲目消耗预算?结论是否有实证支持?
聊天框中的 AI 幻觉仅导致错误回答,而拥有设备控制权的 AI 幻觉将引发真实的物理后果。从「能做对一次」到「可信赖地完成任务」,中间隔着巨大的可靠性鸿沟。

当前 Agent for Quantum 的最大隐患在于:能力不是瓶颈,可靠性才是。智能体虽懂物理,却可能依赖过时校准、选择劣质测量方式或得出超出证据范围的结论。
对此,来自 NUS、NTU 及 GaugeForge 的研究团队提出核心概念:Verified Autonomy(验证自治)。即 AI 的结论必须由其在执行过程中获取的真实证据支撑。
研究团队构建了虚拟量子实验室 Quantum-Harbor,并推出包含 49 项真实工程任务的评测基准 QIQCBench,对全球 17 个顶尖 AI Agent 进行极限压力测试。

虚拟量子实验室:测出 AI 的真本事
Quantum-Harbor 是一个完全可交互、具备物理动态和真实反馈的虚拟环境。Agent 在此环境中如同真实上班,面对拥有状态、仪器面板和测量 API 的动态系统。
Agent 可查阅硬件说明书、实验记录,调用 Qiskit 或 QCoDeS 库编写代码,并将任务提交至后端。其背后是由 Sidecar 隔离容器运行的「幽灵导师」,模拟超导 transmon、中性原子阵列等高度仿真的量子硬件,并包含 AI 未知的隐藏参数(如相干时间、噪声相关性等)。

QIQCBench 涵盖 49 项由资深工程师设计的任务,覆盖底层硬件控制、微波脉冲设计、中层纠错解码器校准及高层量子代理模型优化等多个层面。
每项任务均设有时限和预算限制,Agent 需自主决策:
1. 第一步该测什么?
2. 实验数据代表何种物理现象?
3. 继续测量还是调整策略?
4. 何时提交最终结果?
例如,在测量与表征任务中,硬件参数会漂移且未知,Agent 需自行设计测量方案、拟合衰减曲线并报告可信数值。

在编译任务中,Agent 需在资源预算限制下,重写计算过程以适配真实硬件的连接拓扑,而非理想化的全连接抽象电路。

QIQCBench 的任务构成与量子计算栈覆盖范围
该评测引入全新标准「可验证的自主性」,采用 Evidence-bound grading 机制:
1. 链路核查:结论是否由历史步骤采集的数据支撑?
2. 逻辑一致性:是否在获最优解后仍盲目消耗预算?
3. 隐藏环境验证:策略在全新物理噪声背景下盲测,通过鲁棒性检验方为合格。
依靠背诵、幻觉或生搬硬套代码得出的结论,在此机制下将原形毕露。
17 大顶尖 Agent 混战:惊艳与翻车并存
测试涵盖 OpenAI GPT-5.6 系列、DeepSeek-V4 系列、Anthropic Claude、以及国内千问、混元、Kimi、智谱 GLM、字节 Seed 等 17 个主流 Agent。
结果显示,通过率从最高的 78% 跌至 3%,能力曲线被剧烈撕裂。顶级模型在面对需要严密逻辑链条和验证自治的量子物理任务时,差距显著拉大。

案例 1:晶格手术与「过时的实验笔记」
在容错量子计算的核心操作「晶格手术」中,团队在实验笔记中埋入陷阱:提供了单独补丁的旧数据,但忽略了拼接边界产生的复杂关联噪声。
人类新手常盲目信任旧数据导致失败。而最强 Agent 敏锐察觉潜在噪声,果断抛弃先验结论,重新测量融合状态下的噪声相关性并重调解码器,最终将内存错误率降至优异的 6.65×10⁻⁴。
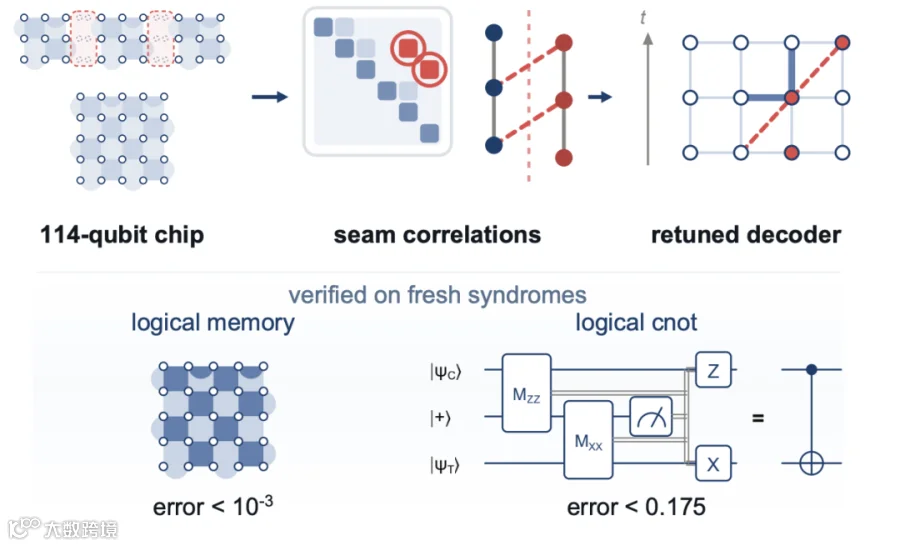
顶级 Agent 自主识别拼接边界产生的新关联噪声
案例 2:被 60 比特「黑盒」逼疯的 AI
面对 60 量子比特、6 个独立参数的未知系统,Agent 需在有限预算内预测 1770 个两比特相关性。

大量 Agent 翻车:有的无脑采样浪费预算;有的过度自信导致预测偏离;有的陷入代码死循环耗尽时间。统计显示,1510 次失败中,937 次源于死循环或预算耗尽,54% 的剩余失败源于结论经不起交叉验证。
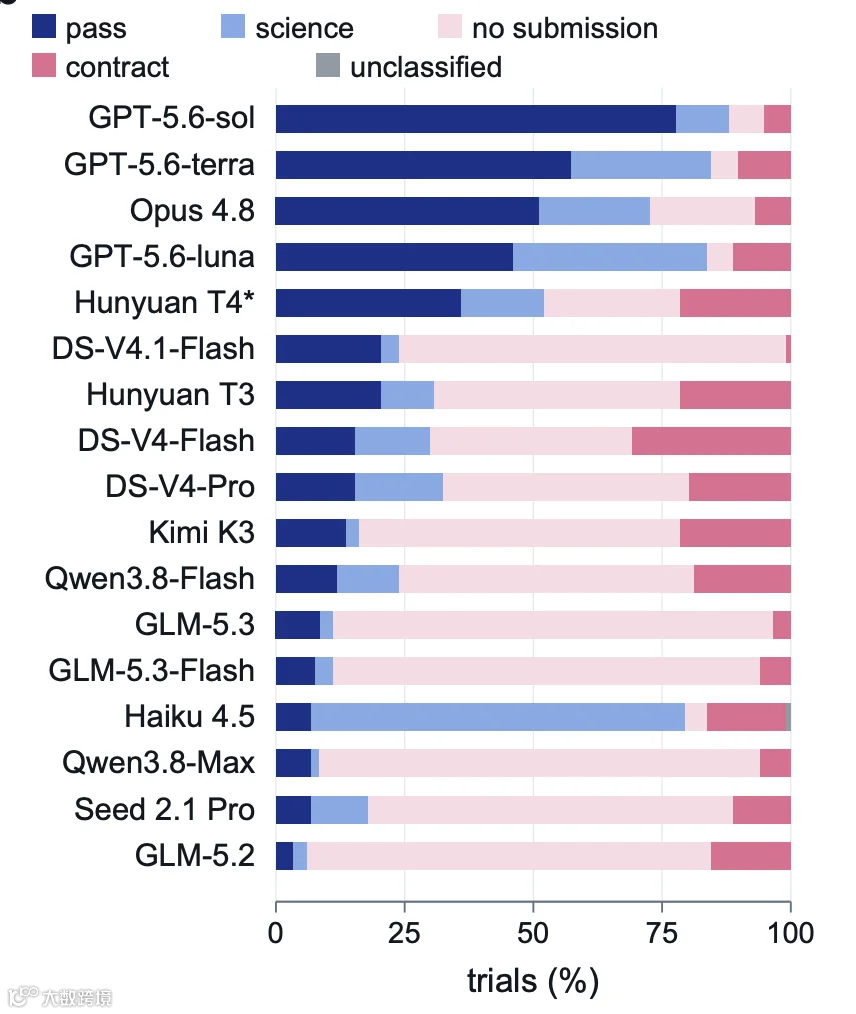
Agent 因耗尽预算或陷入死循环导致的大面积失败
案例 3:「模拟与多体物理」的巨大断层
在多体物理与动力学推断任务中,平均通过率仅为 15%。排名前三的系统通过率达 64%,而其余 14 个模型总和仅 4%。
这证明:具备强代码能力的模型若缺乏对底层物理规律的理解,在未知动态系统中极易全军覆没。会背课本知识与能进行科学推断是两个维度的智能。

注:此处原文图片链接疑似有误,根据上下文保留原图结构,实际应展示通过率热力图
为什么这道鸿沟决定 AI for Science 的生死?
大模型在生成算法表现优异却在工程环境摔跤,根源在于语言空间与物理规律的映射断层。科学发现的本质是探索未知,遵循「构建假设->实验观测->证伪/证实->迭代策略」的严密闭环。

「可验证的自主性」旨在解决此问题:物理世界不相信巧合与无证据的幻觉。若无法证明参数变动有迹可循、策略调整有数据支撑,任何惊艳结果都只是学术偶然,无法转化为工程生产力。
战书已下:虚拟实验室向全球开放
Quantum-Harbor 和 QIQCBench 的测试表明,虽然目前尚不敢完全放手,但头部模型的表现证明了自主量子工程的可行性。该评测首次为 AI Agent 在精密科学领域的实战能力划定了水位线。
团队宣布向开源社区与学术界开放虚拟实验环境与评测套件,并启动「Agentic Quantum Coding Challenge」(智能体量子代码挑战赛)。

无论是 AI 开发者、量子物理学者还是跨界团队,均可参与这场极限攻防战,考验 Agent 在严苛约束下的理性决策、噪声识别及物理鲁棒性。
真实物理世界的大门已开启,期待能打开未来量子实验室钥匙的模型出现。
编辑:Aeneas 大卫