

本文作者|范振璇
本文编辑|蒲诗瑶
EMNLP 2026 Oral:RoboSPA——VLA模型的能力体检报告
- 论文题目:RoboSPA: Can VLA Models Go Beyond Simple Scenes and Short-Horizon Tasks?
- 作者机构:浙江大学、电子科技大学、华南师范大学
- 论文链接:https://arxiv.org/abs/2609.05324
- 项目主页:https://fanzhenxuan.github.io/RoboSPA
导读:从“会做”到“真懂”的跨越
当指令从简单的“拿起红色方块”变为“拿起距离橙色方块第三远的那个”,或涉及跨视角空间转换及长程记忆时,机器人任务的本质便从单纯的视觉-动作映射升级为复杂的空间推理与程序规划。
现有评测往往只关注任务是否成功,却难以揭示模型失效的具体环节。为此,浙江大学等机构的研究团队提出了 RoboSPA(Robot Spatial-Procedural Assessment)。这是一个面向 Vision-Language-Action(VLA)模型的大规模诊断性评测基准,旨在通过细粒度指标定位模型在理解、规划或执行环节的真实短板。
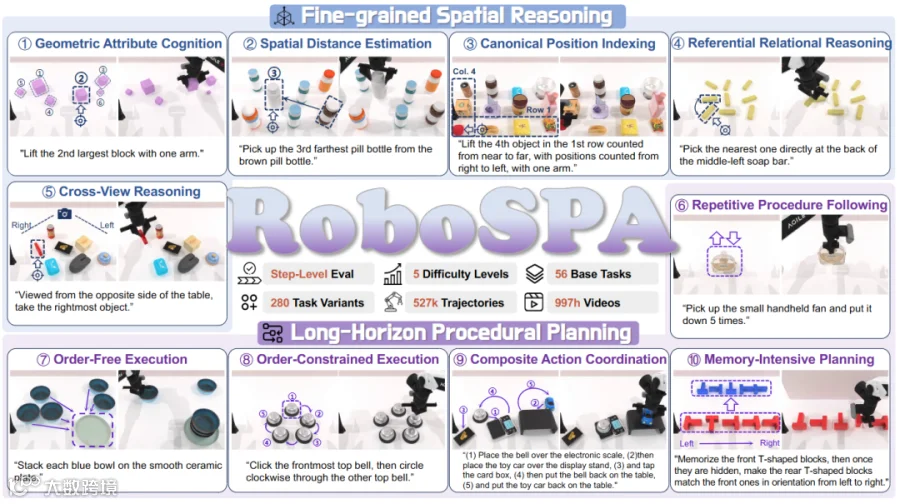
图1: RoboSPA 基准概览,涵盖细粒度空间推理与长程程序规划两大能力维度
核心维度:细粒度空间推理与长程程序规划
RoboSPA 将机器人操作能力拆解为两个核心维度,共包含10类任务,旨在构建系统化的“能力体检”体系。
1. 细粒度空间推理:超越颜色与类别的辨识
该维度考察模型在复杂空间约束下的目标定位能力,分为五类子任务:
| 能力类别 | 核心问题 | 代表性任务示例 |
|---|---|---|
| 几何属性认知(GAC) | 依据大小、形状区分同类物体 | 拿起高度排名第三的积木 |
| 空间距离估计(SDE) | 比较物体与参考物的相对距离 | 拿起距离橙色方块第三远的物体 |
| 规范位置索引(CPI) | 按指定行列方向和计数顺序定位 | 找到第一行中从右向左数第四个物体 |
| 指代关系推理(RRR) | 理解相对于参考物的方位 | 找到位于参考物“前左侧”的目标 |
| 跨视角推理(CVR) | 非自我中心视角的描述转换 | 从桌子左侧看,拿起最后方的物体 |
2. 长程程序规划:状态跟踪与步骤执行
该维度考察模型在多步任务中的进度维护、顺序遵守及记忆能力,同样分为五类:
| 能力类别 | 核心问题 | 代表性任务示例 |
|---|---|---|
| 重复程序执行(RPF) | 准确重复指定次数并停止 | 将手持风扇拿起并放下 5 次 |
| 自由顺序执行(OFE) | 任意顺序覆盖子目标,不遗漏 | 将多个指定物体依次放入容器 |
| 约束顺序执行(OCE) | 严格按给定顺序完成子任务 | 按指定先后顺序点击多个物体 |
| 复合动作协调(CAC) | 组合不同类型的操作技能 | 放置、点击、移动并恢复多个物体 |
| 记忆密集型规划(MIP) | 保留早期信息用于后续决策 | 记住积木方向,遮挡后对齐另一组 |
受控难度设计:观察能力退化曲线
RoboSPA 摒弃了简单的“难易”标签,为每个基础任务构建了 L1—L5 五个受控难度等级:
- 空间推理:通过增加候选物数量,提高目标消歧难度;
- 长程规划:通过增加动作步骤和中间子目标,延长程序长度。
此外,数据涵盖干净场景与域随机化场景(改变背景、光照、杂物等),以全面考察模型的鲁棒性。
数据集规模:527K 条轨迹支撑多本体评测
RoboSPA 基于 SAPIEN 仿真器和 RoboTwin 2.0 框架构建,支持 Aloha-AgileX、ARX-X5、Piper、Franka 和 UR5 五种机器人本体。
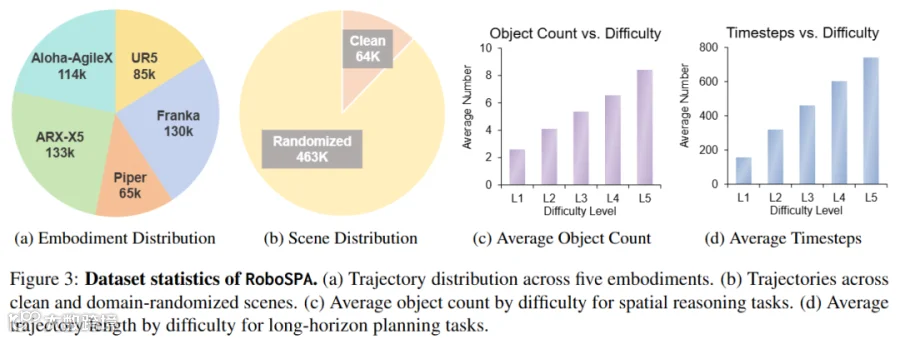
图3: RoboSPA 数据集统计
| 能力类别 | 10 类 |
| 基础任务 | 56 个 |
| 难度等级 | 5 级 |
| 操作轨迹 | 约 527K 条 |
| 视频时长 | 超过 997 小时 |
| 物体类别 | 120 类 / 581 个变体 |
诊断性指标:ONTA 与 Progress Score
为了深入分析失败原因,RoboSPA 引入了两类关键诊断指标,超越了传统的二元成功率。
1. ONTA:排除随机猜测干扰
Object-Normalized Target Accuracy (ONTA) 对候选物数量进行归一化,公式为:ONTA(n) = ((SR(n) - 1/n) / (1 - 1/n)) × 100。该指标能更公平地反映模型利用空间线索的真实能力,避免因候选物少而“碰巧选对”的高分假象。
2. Progress Score:量化长程任务进度
对于多步任务,Progress Score 记录已完成子任务的比例。它能区分“完全无法启动”与“中途失效”的模型,为改进方向提供依据。
评测结果:当前 VLA 模型的能力边界
研究团队评测了 RDT、GO-1、π0.5 和 X-VLA 四个代表性模型。结果显示,所有模型的性能均随难度增加而显著下降。
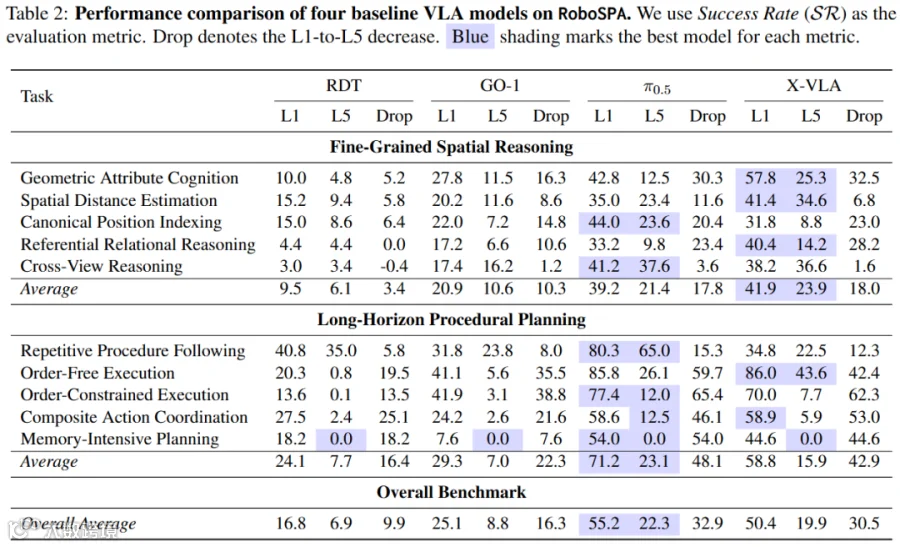
表1:四种代表性 VLA 模型在 RoboSPA 上的性能对比
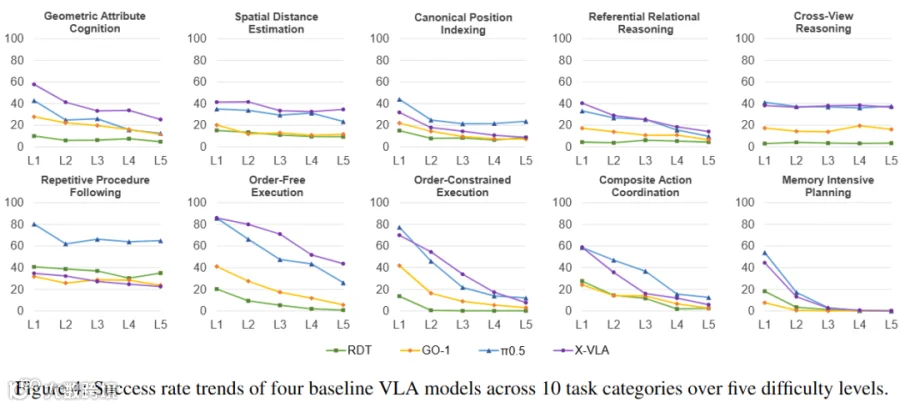
图4:四种 VLA 模型随难度等级变化的成功率趋势
即使在最高难度 L5 下表现最好的 π0.5,平均成功率也仅为 22.3%。更深层的诊断数据显示:
- 空间推理接近随机:RDT 和 GO-1 的平均 ONTA 低于 0;π0.5 和 X-VLA 在 L5 的 ONTA 也仅有个位数,表明模型在复杂空间关系中难以有效利用线索。
- 长程规划半途而废:虽然 π0.5 在 L5 的成功率为 23.1%,但其 Progress Score 为 45.4,说明模型能完成部分步骤,但常因状态丢失或顺序错误而中断。在记忆密集型任务中,所有模型成功率均为 0。

图5:四种 VLA 模型在 L1 与 L5 下的能力表现对比
失败模式分析:定位与记忆是主要瓶颈
通过对上千个评测视频的分析,研究团队揭示了主要的失败模式:
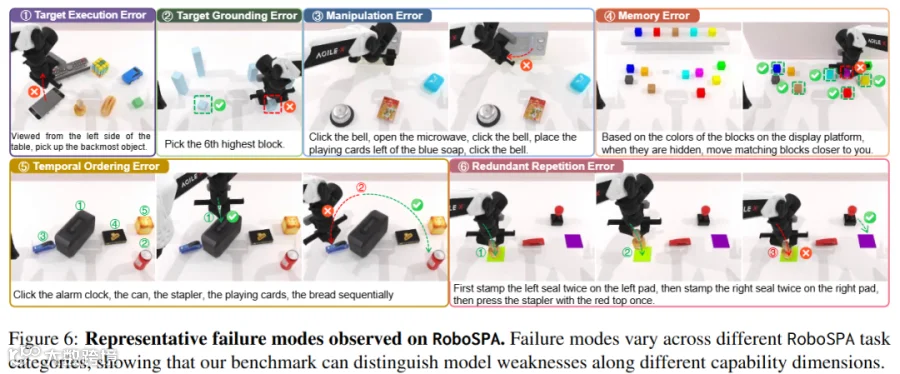
图6:RoboSPA 中六类典型失败模式
- 空间任务:超过 70% 的错误源于目标定位错误,而非抓取执行失误。这表明模型未能真正理解复杂的空间指代关系。
- 长程任务:错误主要分布在低层操作失败、顺序错误及记忆错误。特别是在需要维持内部状态的任务中,模型极易出现冗余重复或步骤遗漏。
结语:从“单点成功”走向“复杂可靠”
RoboSPA 的价值在于推动了 VLA 评测的三个转变:从任务清单走向能力体系,从单点成绩走向难度曲线,从最终成败走向失败诊断。
当前的 VLA 模型在简单条件下表现优异,但在面对歧义增多、步骤拉长、干扰复杂的真实场景时,其具身推理能力仍显脆弱。RoboSPA 提供的这把“新尺子”,有助于研究者更清晰地识别模型短板,从而针对性地增强空间表征、引入显式记忆或改进进度追踪机制,推动通用机器人向更复杂、更可靠的方向演进。
点击 阅读原文 查看原论文