


HBF技术旨在通过提升AI服务器的存储容量来容纳更多模型,但推理性能的真正瓶颈在于每个Token均需从内存读取的数据带宽。
随着推理模型规模扩大,GPU旁侧的存储容量首先面临压力。HBF(Host Buffer Flash)将Flash存储移至更靠近GPU的位置。根据OCP HBF v0.7草案,Grade 2封装可提供512GiB容量和1.536TB/s的最大用户带宽。其定位是在同等成本下,容量达到HBM的8至16倍。
然而,容量的增加并不直接等同于推理成本的降低。在Kimi K2的72-GPU机柜模拟中,全HBF架构虽将机柜内存从20.7TB提升至294.9TB,但聚合带宽却从1,584TB/s降至922TB/s。如何合理分配HBF与HBM的存储内容,是决定单Token成本盈亏的关键。
01 | HBF填补GPU旁侧的容量缺口
HBF利用NAND Flash构建贴近GPU的高容量层。其读取带宽高于传统SSD但低于HBM,写入操作遵循NAND的块页结构。HBF适用于存储“占用空间大、但无需每一步高速读取”的数据,如模型权重和长上下文产生的KV Cache,从而缓解单卡容量压力;而HBM则继续负责处理每一步都需要反复读取的热数据。
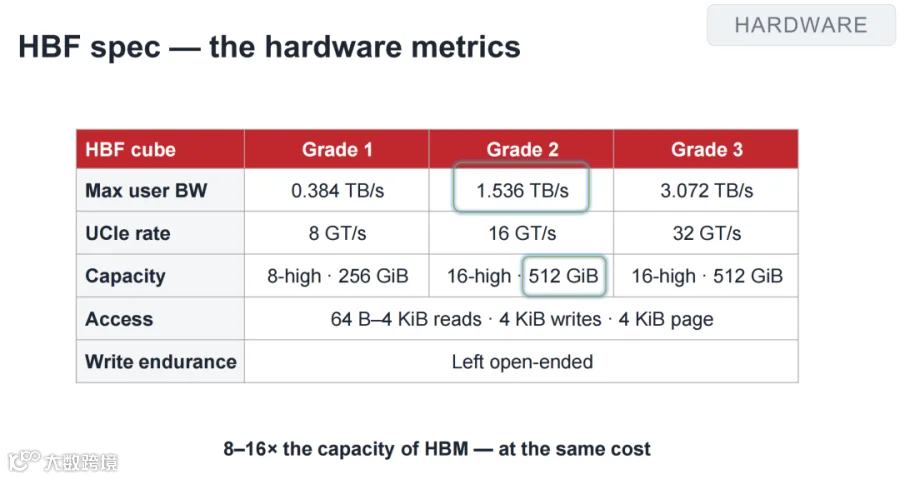
三档HBF规格显示,Grade 2以512GiB容量和1.536TB/s带宽为主,首要任务是补充容量,其带宽定位仍低于HBM。
系统在容量和带宽上均需投入成本。当容量成为主导因素时,HBF具备吸引力;而在高并发场景下,HBM的高带宽能有效降低单位Token成本。
02 | MoE专家池与稀疏KV:HBF的应用场景
以Kimi K3为例,其总权重约1.56TB,其中MoE专家权重约1.45TB(占比93%),注意力及其他常驻权重仅约110GB。由于每个请求仅激活部分专家,将庞大的专家池存入HBF,而将注意力、路由及常驻权重保留在HBM中,可实现容量与带宽的有效分工。

Kimi K3的主要负载在于MoE专家权重,注意力权重占比较小,适合分层存储。
在低批量请求时,触及的专家有限,HBF的读取速度足以应对;但随着批量增加且请求来源多样化,被调用的专家范围迅速扩大。尽管Kimi K2单个Token仅路由至少量专家,但在批量处理中,系统读取的专家覆盖率持续上升。此时,仅在低批量或相似请求批处理中,HBM热缓存才更具效率。
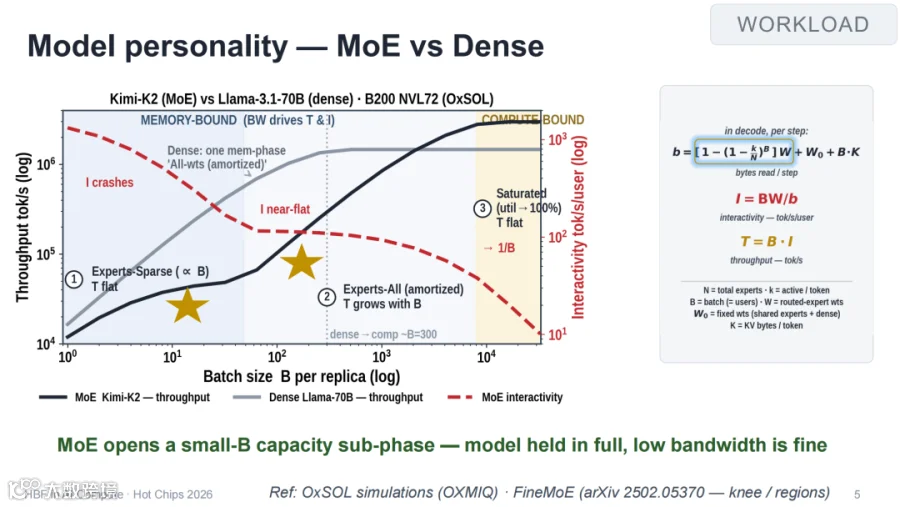
低批量MoE主要受容量限制,随着批量提高,更多专家参与处理,带宽需求随之攀升。
长上下文的KV Cache也面临类似情况。估算显示,Kimi K3一条100万Token序列的KV Cache约为30GB。稀疏注意力每步仅读取完整KV中的top-k部分(比例约为1%至2%),完整KV可留存于HBF,仅读取的小段数据走高带宽路径。相比之下,全注意力机制需每步扫描完整KV,HBF的容量优势很快会被带宽瓶颈抵消。

稀疏注意力保留完整KV但仅读取顶部少量行,全注意力则需每步读取全部KV。
03 | 14倍容量背后的机柜账单权衡
基于Kimi K2 1T模型、FP4精度及100万Token输入的72-GPU机柜模拟显示:全HBM方案拥有20.7TB内存和1,584TB/s聚合带宽;全HBF方案内存扩至294.9TB,但带宽降为922TB/s。模拟假设两者在三年摊销口径下的成本和功耗相同。

对比三种配置,全HBF容量约为全HBM的14倍,但聚合带宽仅为后者的0.6倍。
HBF的优势主要体现在单机容量上,允许单个GPU实例装载更大模型。但在相同资本开支下,HBM方案能生成更多Token,单位Token成本更低。
带宽决定了并发服务能力。当HBF将模型塞入单机后,若用户数或并发量继续增长,读取专家权重和KV Cache的速度将率先遭遇瓶颈。需注意,这些曲线源自架构模拟,非量产系统实测数据。

左图对比同机柜单位Token成本,HBM曲线更低;右图显示HBF可用更少GPU获得更大单实例容量。
04 | HBF落地取决于推理软件的数据管理能力
HBF无法像HBM那样被GPU缓存体系自然吸收。材料指出,需采用64KB读取、1MB写入的模式才能接近最大带宽,数据通过DMA搬运。在HBF与HBF并存时,需单独管理两层内存。此外,85摄氏度下约24小时的上电数据保持能力及写入耐久度,也成为主机侧需处理的限制因素。

读写粒度、DMA路径、数据保持和耐久度均构成软件约束,要求主机主动管理HBF的生命周期。
目前vLLM对HBF的支持仍处于方案阶段。规划中将HBF用于KV卸载池、前缀缓存和MoE专家池,并标注“HBF plug-in”为提案状态,MoE专家池尚未直接在vLLM中可用。若缺乏分配器、数据放置策略、异步预取和耐久度监控等组件,HBF的容量优势难以转化为实际的推理服务效能。

HBM保留常驻模型权重、激活值及正在使用的KV;HBF承担更大的KV与专家池,该方案尚未成为vLLM现成功能。
结语:容量应服务于非即时高频访问数据
HBF为AI服务器拓展了一层容量,但该层级具有明确的访问条件限制。低批量MoE专家池和稀疏注意力的长上下文KV,可将大量数据留在近端且无需每Token全量读取;而对于高批量、稠密模型及高交互速度场景,仍依赖HBM的高带宽支持。
系统应将“量大但不热”的数据部署于HBF。一旦数据转变为每Token高频访问的热路径,无论容量多大,都无法弥补带宽不足带来的成本劣势。