

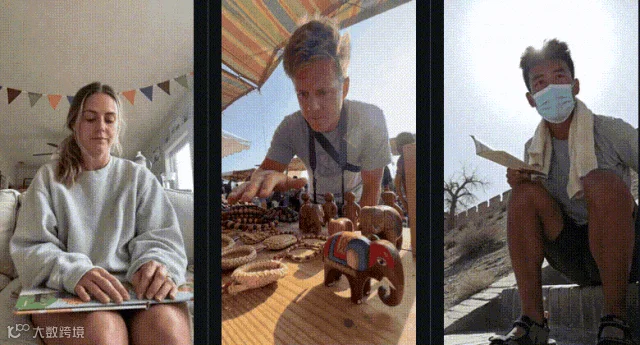
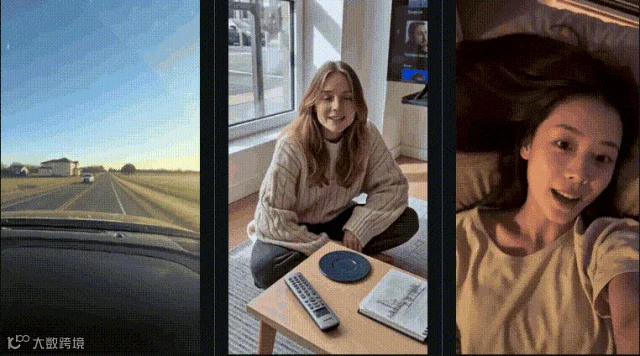
输入一段带语音的1080p视频,模型直接用文本回答——问题藏在语音和画面里,不另打字、不过ASR、不靠外部字幕。港中文联合阿里Token Hub(Qwen团队)等机构为此建了全套数据引擎、基准和强化学习配方,把Qwen3-Omni的真实对话得分从0.402抬到0.632。
现有的omni模型大多在「听得清、看得懂」上卷,但真把它放进一场面对面的对话,问题立刻暴露:用户指着东西问「这个适合五岁小孩吗」,模型认不出指的是哪只木象;用户话说一半停下思考,模型抢答;让模型把电路板放到架子上,它顺口答应——可它没有手。这些「对话状态、指代对齐、自我认知、抗幻觉、情绪识别」的能力,恰恰是现有评测很少覆盖的,一个核心原因是真实录制的音视频对话数据极其稀缺。
港中文、阿里Token Hub(Alibaba Group)、上海交大、上海创新研究院和浙江大学联合推出OmniVChat,用OmniVChat-Studio多智能体数据引擎合成对话,构建OmniVChat-Bench基准(2800段对话、17个子类、13475条分层评分标准),并设计OmniVChat-RL强化学习奖励。
在Qwen3-Omni-30B-A3B-Instruct的Thinker上,用LoRA(可训练参数325M)训练1000次迭代,合成基准Subcategory Mean从0.465涨到0.652,人类实录的360段对话上从0.402涨到0.632,同时回复长度从79词压到36词、风格得分从0.710提到0.992。在12个已发布系统的横向对比中,它的合成榜Mean(0.652)排在第二,实录榜Human(0.632)排第一。


相关链接
-
论文:https://arxiv.org/abs/2609.21465 -
代码:https://github.com/HarlandZZC/OmniVChat -
数据集:https://huggingface.co/datasets/Harland/OmniVChat(约28GB,1080p带立体声) -
项目主页:未公开(GitHub README即文档主页) -
模型权重:未公开(官方只放代码和数据,RL后的checkpoint没有放出) -
开源协议:数据集为CC BY-NC-ND 4.0(非商用、禁演绎);代码未单独标注协议
内容介绍
OmniVChat定义了一个新任务:omni模型同时接收用户的音频和视频,直接返回文本——用户的问题就在他说的话和他所处的画面里,没有独立的文字提问,没有外部caption,没有ASR转写。
与常规的「录数据集」做法不同,它的核心特点是:
-
对话全靠合成:用视频生成模型渲染1080p、44.1kHz立体声的对话片段,不依赖真实录制,数据规模和场景覆盖不受录制成本限制 -
评分靠分层rubric:每个实例带参考回复和分层评分标准,tier 0是硬门槛(比如用用户的语言回答),没过直接零分;高tier的得分以低tier全过为前提 -
训练和评测同源不同集:同一套合成管线产出训练集(5600段)和评测集(2800段,无视频重叠),另录360段真人对话验证迁移
适用场景:omni模型的对话能力评测、语音助手/陪伴类产品的RL训练参考、多模态数据合成的工程范式参考。 OmniVChat任务示意:模型直接接收带语音的音视频流并返回文本。
方法概述
一句话概括:一套引擎管造数据,一套rubric管打分,一套奖励管训练。
1. 多智能体数据引擎(OmniVChat-Studio)
解决的问题是「真实音视频对话录音几乎没有」。引擎分单轮和多轮两个子系统,由三类agent协作:Director负责剧本和评审(出故事线、写脚本、审视频、写参考回复),Renderer负责把通过的脚本渲染成同步的音视频片段,Reviewer负责给视频写caption和质量报告(覆盖剪辑、真实感、语速、肢体、伪影、字幕等七个方面),另有一个确定性的Validator按规则查脚本格式和时序。每一环都有评审回路:视频里该有的细节没渲染出来,Reviewer会发起定向Video Q-A确认,确认不影响主线才放行。多轮子系统额外做跨轮依赖——后面一轮可以引用前面片段里的线索(比如第7轮问的花瓶,画面只在更早轮次出现过)。产出的每个实例包含1080p片段、参考回复和分层rubric。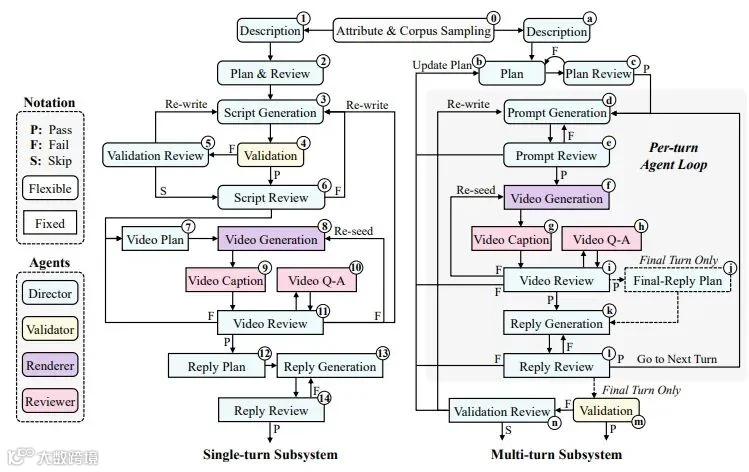 左为单轮子系统,右为多轮子系统,颜色区分Director/Validator/Renderer/Reviewer四类agent。
2. 分层评分标准与OmniVChat-Bench
解决的问题是「开放式回复怎么客观打分」。关键词匹配在开放式对话里不可靠,OmniVChat-Bench给2800段对话(2550单轮+250多轮)配了13475条分层标准,由qwen3.7-max做judge。评分函数r(y)的设计有一个关键点:tier 0查语言一致性,不得分,但失败即零分;tier n的得分要求之前所有tier全过,某一级没过全,后面的tier直接锁死。总分是得奖点数除以tier 0以外的全部点数——注意被锁死的点数也计入分母,所以答错不是不扣分而是真扣分。报告的Mean是子类均值:先在17个子类内部平均,再对17个子类取平均,大小子类权重相同。
五个能力维度:DSLP(对话状态与链路感知:连接确认、轮次边界、镜头方位)、MEA(多模态实体对齐:语音指到画面里正确的物体和说话人)、MSA(模型自我认知:身份、物理限制——没手就说没手)、AH(抗幻觉:没听到摇篮曲就直说没听到)、ER(情绪识别:回复要接住用户的表情和语气)。一个有意思的设计是MSA-PLA子类(200例)带两套独立rubric:默认假设模型没有身体,正确答案是声明做不到并给出替代方案;另一套假设模型可执行动作,正确答案是干脆地答应并认对目标物体。同一个回复在两套标准下通常一边高分一边低分——这正是设计意图。评哪个假设、报哪个分数,由部署方自己声明。
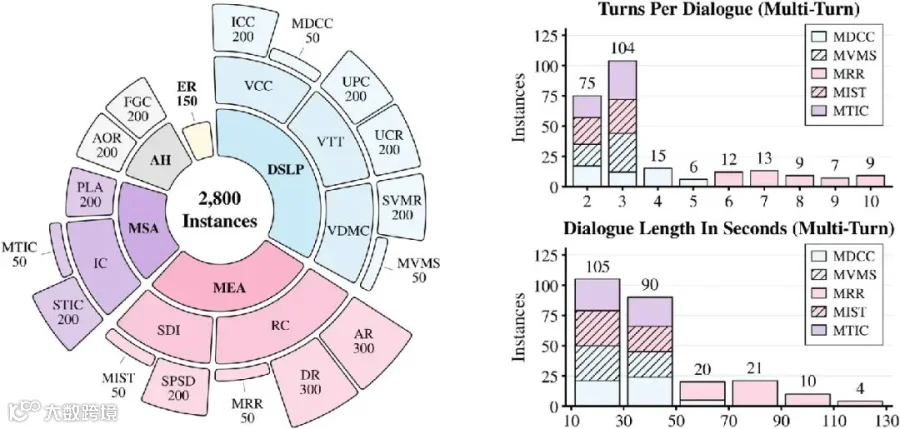 左:5个能力类别、17个子类的实例分布;右:250段多轮对话的轮次与时长分布。
3. 强化学习奖励设计(OmniVChat-RL)
解决的问题是「对话质量不能只看对不对」。总奖励R(y)=r(y)+λfmt·f(y)+λeff·e(y)+λsty·s(y),四项分别是正确性(直接复用基准的r(y))、格式、效率、风格,权重0.5/0.1/0.5,奖励范围[0,2.1]。效率项e(y)只在同一个rollout组内有定义:对同一个prompt采的N个回复,按「rubric得分除以词数」做组内min-max归一化——最省字的满分回复拿1,最啰嗦的拿0。风格项由qwen3.7-max按七条标准(自然口语、无markdown、无列表、无emoji、无注水等)打0/1。训练用GSPO(无KL惩罚),LoRA rank-64挂在attention和MoE投影上,视觉和音频塔冻结,视频按2fps采样、每段最多16帧,每迭代32个prompt、每个4个回复,共1000次迭代,按开发集(560段)选checkpoint,选中第940步。
实验结果
主对比:12个已发布系统+本方案
|
|
|
|
|
|
|---|---|---|---|---|
|
|
0.667 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
0.871 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| OmniVChat-RL(本文) |
|
0.632 | 18.38 | 0.992 |
三个榜单的第一名不是同一家:合成榜Mean是Gemini-3.5-Flash(0.667),实录榜Human是OmniVChat-RL(0.632),RE和Style也是OmniVChat-RL(18.38、0.992)。论文特别指出:合成榜排名不决定实录榜排名——比如Gemini-3.7-Flash在合成榜0.640排第二,实录榜0.575排第二,但豆包Seed 2.0 Lite合成榜0.494,实录榜直接掉到0.274。
相对基座的提升:Qwen3-Omni-Instruct的Mean从0.465到0.652,实录从0.402到0.632——注意训练数据全是合成的,360段实录对话一次都没训过。分类目看,抗幻觉AH从0.186涨到0.667(基座在这项上几乎是随机水平),MSA从0.388到0.734;多轮均值从0.508到0.638,与单轮的差距从Gemini-3.7-Flash的-0.114收窄到-0.026。
消融:官方自己给的「不是全胜」
-
去掉效率项(λeff=0):Mean反而涨到0.697,实录涨到0.691——都比完整版高。代价是回复从36词涨回99词,RE从18.38跌到7.12。也就是说,完整奖励是拿1.5分左右的rubric分换来的简洁,这是一个明确的取舍,不是免费午餐 -
去掉风格项(λsty=0):Mean 0.661、实录0.632基本不变,但Style从0.992跌到0.788 -
多轮均值上,豆包Seed 2.0 Lite的0.671高于OmniVChat-RL的0.638
训练过程
1000次迭代里,训练中的rubric奖励从0.308升到0.629,风格从0.750到0.992;原始效率(每千词rubric得分)从3.37升到17.18;回复长度从91.5词降到36.6词。格式项全程1.000、不提供学习信号(论文对此有明确解释:格式只该是硬约束)。关键的一点是右下角面板:实录榜成绩曲线和中文合成子集的曲线几乎重合地一起上升(0.402对0.437起步,0.632对0.634收尾)——这是「合成数据训出的能力能迁移到真实对话」这一主张的直接证据。
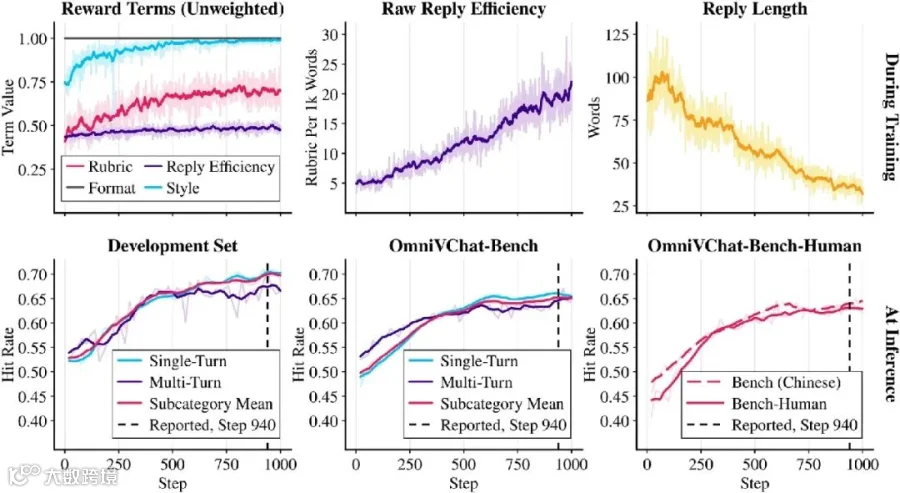
上排:奖励项、原始效率与回复长度;下排:开发集、合成基准与实录基准的held-out曲线,虚线为选中的第940步。
局限与未来方向
首先,分数依赖judge。全篇的rubric判定和风格判定都由qwen3.7-max完成,论文自己也做了6个judge的交叉验证(pooled分0.643到0.678),但换更强的judge或更弱的judge,具体数字会漂移——复现时报告judge型号是必要动作。
其次,实录探针覆盖有限。OmniVChat-Bench-Human只有360段、全部为中文、全部单轮,不测实时打断,多轮迁移没有实录验证。
此外,数据合成环节的videoRenderer底座模型论文没有披露,多轮对话的评测协议要求所有模型使用相同的参考回复做历史(仓库里没有放出历史轮次的模型回复,复现要自己补),且合成对话里人的肖像版权按协议保留在权利人手中。
最后,RL后的模型权重未放出,第三方想复现训练要从28GB数据集加LoRA训练全流程跑起,成本不低。
结论
OmniVChat验证了一件事:音视频对话的「会聊天」能力,可以靠合成数据+分层rubric+组内相对效率奖励这条管线系统性地练出来,且合成基准上的提升能迁移到实录对话。
对于做语音助手、陪伴类产品的团队,这套「合成数据训、实录数据验」的范式和开源的奖励代码(eval/score.py与reward/reward.py共用同一份rubric实现)值得直接拿去试,尤其是效率项和风格项的组内归一化设计;对于一般开发者,2800段bench配上打分脚本可以直接测手头的omni模型,不用下载全部28GB媒体也能读文档理解协议。
风险提示要说清楚三点:数据集是CC BY-NC-ND,学术评测之外的商业使用被明确禁止;RL后的模型权重未公开,别把它当成「开源了一个更强的Qwen3-Omni」;合成榜Mean 0.652仍低于Gemini-3.5-Flash的0.667,「实录榜第一」的成立范围是这次对比的12个系统。
对话能力的下一步,可能不再是把模型喂得更聪明,而是把「一场对话什么才算好」定义得更清楚——这篇论文给了一个可复用的答案。
感谢你看到这里,添加小助手 AIGC_Tech 加入官方 AIGC读者交流群,下方扫码加入 AIGC Studio 星球,获取前沿AI应用、AIGC实践教程、大厂面试经验、AI学习路线以及IT类入门到精通学习资料等,欢迎一起交流学习💗~
