


咱们这个公众号的读者对 Ontology(本体)这个词应该不陌生了。我们写过多篇文章拆解 Palantir 的本体范式:把客户、交易、用户、工单这些散落在各个系统里的业务实体,连成一张可以查询、可以推理、可以行动的图谱。这是 Foundry 的立身之本,也是它客单价以百万美元计的理由之一。
10 月 7 日,图数据库公司 HelixDB 开源了一个新项目 Helix Foundry,名字就直接对标 Palantir Foundry。上线 3 天,GitHub 上已经有 600 多个 stars,它的自我描述只有一句话:你公司的数据,连成一个本体,在你自己的电脑上。
这篇文章带你看看它到底做了什么,与真正的 Foundry 差在哪,以及怎么在自己机器上跑起来。
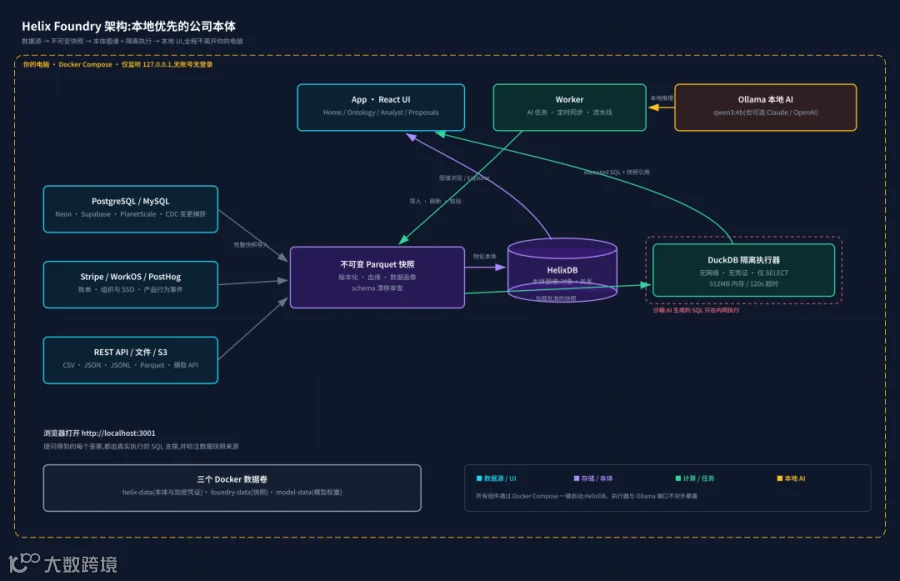
Helix Foundry 是一个跑在本机的数据工作台。没有账号,没有登录,没有任何东西需要托管,应用只监听 127.0.0.1,谁能在浏览器里打开它,谁就拥有全部权限。AI 默认也是本地的:通过 Ollama 跑 qwen3-4b,不联网、不花钱。当然你也可以在设置里换成 Claude 或 OpenAI,密钥在浏览器里输入,用 AES-256-GCM 加密存储。
整个技术栈是三个开源组件的组合,每个组件对应 Foundry 的一块能力:
-
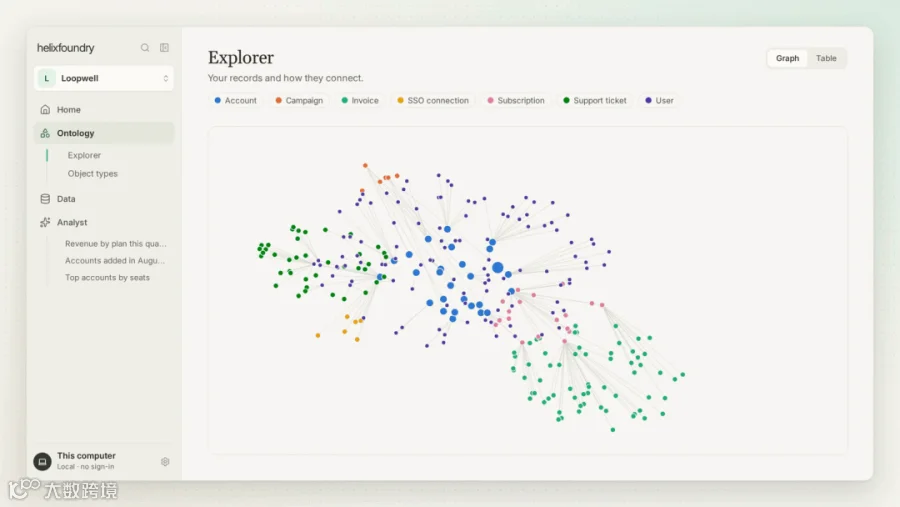
• HelixDB 存本体。客户、订单、订阅、工单这些对象和它们之间的关系,以图的形式落库,可以在 Explorer 里以图谱或表格的方式浏览。 -
• 不可变的 Parquet 快照 存数据。每次导入都是一个完整、带版本、带血缘的快照,支持 schema 漂移审查和历史回溯。 -
• DuckDB 做转换和分析。所有 AI 生成的 SQL 都在一个隔离的执行器里跑,这个执行器没有网络、没有任何连接器凭证、只允许 SELECT,还有 512MB 内存和 120 秒超时的硬限制。
对标 Foundry:它复刻了哪些核心机制
连接器。 PostgreSQL、MySQL(含 Neon、Supabase、PlanetScale 的托管登录)、Stripe、WorkOS、PostHog、REST API、S3 兼容存储,以及 CSV/JSON/Parquet 文件上传。数据库源会自动尝试 PostgreSQL 逻辑复制或 MySQL binlog 做变更捕获,不行就退回定时快照刷新。Stripe 的导入做得很细:客户、订阅、发票、退款、争议各自成表,ID 统一改名对齐,Unix 时间戳转 ISO,就是为了让跨对象的关系自然连上。
自动建议本体。 连上数据后,它会跨源匹配同一批客户和记录(比如 Stripe 里的 customer 和数据库里的 account),确定性地算出一份建议本体:哪些实体、哪些关系。AI 只负责改写摘要、描述和关系命名,结构性的事情交给代码,人来确认。这个分工很清醒:幻觉不会让你丢数据,最多让一段描述写得不好。
可溯源的 AI 问答。 Home 是关键指标看板,Analyst 是问答界面。你问"这个季度各套餐的收入是多少",得到的不是一段编出来的文字,而是真实执行过的 SQL 和它的结果,并且标注引用了哪个版本的数据快照。这一点直接命中了企业用 AI 查数据最大的不信任来源。
评审与发布。 AI 提议的任何变更(新的映射、新的流水线、新的指标)都先进 Proposals 等待评审,通过校验后按"代际"原子切换发布,支持回滚。如果你了解 Foundry 的治理思路,会发现这套"提议、验证、评审、发布、可回滚"的回路,正是企业级本体平台和玩具 demo 之间的分水岭。
和真正的 Foundry 差在哪
先说清楚,这不是一个企业级替代品,至少现在不是。
它是单人单机的设计:没有多租户,没有权限体系,没有协作功能,官方明确警告不要用反向代理把它暴露到网络上。它不支持 Windows(脚本需要 bash,官方只在 macOS 和 Linux CI 上验证,Windows 用户得走 WSL)。写回源系统、行级增量、分布式计算,都还在"尚未支持"的清单上。真正的 Foundry 背后那套安全模型、血缘审计和上万人的组织协同,更不是三天星标的项目能覆盖的。
它的合理定位是:个人开发者、小团队,或者想在引入重型平台之前先做概念验证的人,用最低的成本摸到本体这套范式的手感。当你的数据散落在三五个 SaaS 和一个数据库里,想把它们连成一张图问问问题,以前只有两条路:自己攒一套管道,或者去谈一份企业合同。现在多了第三条。
上手:三条命令,或者一句话
前置条件只有 Docker(带 Compose v2)。首次运行会下载几个 GB(应用镜像、HelixDB、Ollama 和模型),需要一点耐心:
   git clone https://github.com/helixdb/helix-foundry.git
cd helix-foundry
./scripts/setup.sh --compose
健康检查通过后打开 http://localhost:3001,引导设置只有三步:选 AI(本地 / Claude / OpenAI),连数据(或用自带的示例数据),确认建议本体。
更有意思的是官方推荐的另一种装法:仓库里有一份写给 coding agent 的 AGENTS.md runbook,你可以直接把官方那段提示词贴给 Claude Code、Codex 或 Cursor,让 agent 自己 clone、装依赖、起服务、做健康检查,遇到问题会逐项征求你的同意。数据平台复杂到需要 agent 来装,这大概是 2026 年特有的风景。
不想连真实数据的话,示例数据是一家虚构的 B2B SaaS 公司 Loopwell:PlanetScale 的账户和用户、WorkOS 的组织和 SSO、PostHog 的事件、Stripe 的订阅和发票,加上 S3 里的支持工单和营销活动,共 11 个数据集。数据是本机生成的,并且故意留了真实世界里的坑:账单邮箱和登录邮箱对不上、没有账户的工单、打错的营销代码,正好用来观察本体怎么把脏数据 reconcile 成一张图。
结语
过去几年,本体一直是企业软件里最贵的叙事之一。Helix Foundry 的意义不在于它今天能替代 Foundry,而在于它证明了这套范式的核心回路(连接、快照、本体、问答、评审)已经可以用三个开源组件拼出来,塞进一条 git clone 里,跑在一台 16GB 内存的笔记本上。
当搭建一个公司本体的边际成本降到接近零,本体就不再是大厂的专属武器,而会变成每个数据团队的日常工具。这个方向,值得持续跟踪。
项目地址:https://github.com/HelixDB/helix-foundry
提醒:请朋友们将“智见AI视界”加“星标”,觉得写得好就点击右下角“拇指”和“收藏”哦,不然会慢慢收不到文章推送~
关联阅读