

哈喽,大家好~
最近,有同学提到:数据里有空值,直接填个平均数不就行了吗?
能填,但填完之后,模型学到的规律还靠谱吗?
缺失值看起来只是几个空格,实际上会改变特征分布、变量关系,甚至让模型产生错误判断~
今天,我们就从原理到完整案例,把机器学习中的缺失值处理讲清楚~
01缺失值到底从哪来?
假设我们分析用户消费数据,有些用户没有填写年龄。这里先别急着填,需要判断“为什么没填”。
缺失通常分为三类:
-
MCAR,完全随机缺失:系统偶发故障,与任何变量无关。 -
MAR,随机缺失:是否缺失与其他已知变量有关。例如年轻用户更不愿填写收入。 -
MNAR,非随机缺失:缺失与字段本身有关。例如高收入用户更倾向隐藏收入。
也就是,处理缺失值不是找个数字补进去,而是尽量保留数据原来的关系。
02常见处理方法
缺失很少,并且接近完全随机时,可以删除对应样本。但缺失比例较高时,直接删除会浪费信息。
最简单的是均值填补:
其中, 表示第 个样本的第 个特征已观测, 是该特征的有效样本数。
它速度快,但会把数据往中心拉,削弱方差和特征之间的关系。存在异常值时,中位数通常更稳。
KNN填补会寻找相似样本,再根据邻居估计缺失值;迭代填补则把每个缺失特征当成预测目标:
表示除第 列之外的其他特征。你可以这样理解:它在反复训练小模型,用已知字段推测未知字段。
03完整案例
我们构造一组非线性回归数据,并让缺失概率受到 和 影响,模拟MAR场景。
下游模型使用随机森林。我们同时观察两个指标:
-
填充值与真实值之间的RMSE,越低越好。 -
随机森林在测试集上的 ,越高越好。
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.experimental import enable_iterative_imputer
from sklearn.impute import SimpleImputer, KNNImputer, IterativeImputer
from sklearn.ensemble import RandomForestRegressor
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_squared_error, r2_score

np.random.seed(42)

# 1. 构造完整数据
X = np.random.normal(size=(1500, 5))
y = 3*X[:, 0]**2 + 2*np.sin(X[:, 1]) - 2*X[:, 2]*X[:, 3] \
    + X[:, 4] + np.random.normal(0, .6, 1500)

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=.3, random_state=42
)

# 缺失风险受x1、x3共同影响
def add_missing(data, rate):
    risk = 1/(1 + np.exp(-(0.9*data[:, 0] - 0.7*data[:, 2])))
    p = np.clip(rate * (0.4 + 1.2*risk), 0, 0.9)
    mask = np.random.rand(*data.shape) < p[:, None]
    result = data.copy()
    result[mask] = np.nan
    return result, mask

# 2. 图一:展示缺失机制
X_demo, mask_demo = add_missing(X_train, .35)
fig, ax = plt.subplots(figsize=(8, 6))
gx, gy = np.meshgrid(np.linspace(-3, 3, 100),
                     np.linspace(-3, 3, 100))
risk = 1/(1 + np.exp(-(0.9*gx - 0.7*gy)))
ax.contourf(gx, gy, risk, levels=15, cmap="turbo", alpha=.65)
sc = ax.scatter(X_train[:, 0], X_train[:, 2],
                c=mask_demo.sum(axis=1), cmap="plasma",
                s=24, edgecolor="white", linewidth=.2)
fig.colorbar(sc, ax=ax, label="每行缺失字段数")
ax.set(xlabel="x1", ylabel="x3", title="缺失风险区域与实际缺失数量")
plt.tight_layout()
plt.show()

# 3. 比较三种填补方法
methods = {
    "均值填补": SimpleImputer(),
    "KNN填补": KNNImputer(n_neighbors=5),
    "迭代填补": IterativeImputer(max_iter=10, random_state=42)
}

records = []
for rate in [.1, .2, .35, .5]:
    A, train_mask = add_missing(X_train, rate)
    B, _ = add_missing(X_test, rate)

    for name, imputer in methods.items():
        A_fill = imputer.fit_transform(A)
        B_fill = imputer.transform(B)

        rmse = mean_squared_error(
            X_train[train_mask], A_fill[train_mask]
        ) ** .5

        model = RandomForestRegressor(
            n_estimators=150, min_samples_leaf=3,
            random_state=42, n_jobs=-1
        )
        model.fit(A_fill, y_train)
        r2 = r2_score(y_test, model.predict(B_fill))
        records.append([rate, name, rmse, r2])

df = pd.DataFrame(records, columns=["缺失率", "方法", "RMSE", "R2"])

# 4. 图二:填补误差与模型效果联动分析
colors = {"均值填补": "#ff2d55",
          "KNN填补": "#00b8d9",
          "迭代填补": "#7c4dff"}

fig, axes = plt.subplots(1, 2, figsize=(12, 4.5))
for name, group in df.groupby("方法"):
    axes[0].plot(group["缺失率"], group["RMSE"], "o-",
                 lw=3, ms=7, color=colors[name], label=name)
    axes[1].plot(group["缺失率"], group["R2"], "s-",
                 lw=3, ms=7, color=colors[name], label=name)

axes[0].set(title="缺失率与填补误差", xlabel="缺失率", ylabel="RMSE")
axes[1].set(title="缺失率与模型效果", xlabel="缺失率", ylabel="$R^2$")
for ax in axes:
    ax.grid(alpha=.25)
    ax.legend()
plt.tight_layout()
plt.show()

print(df.round(3))
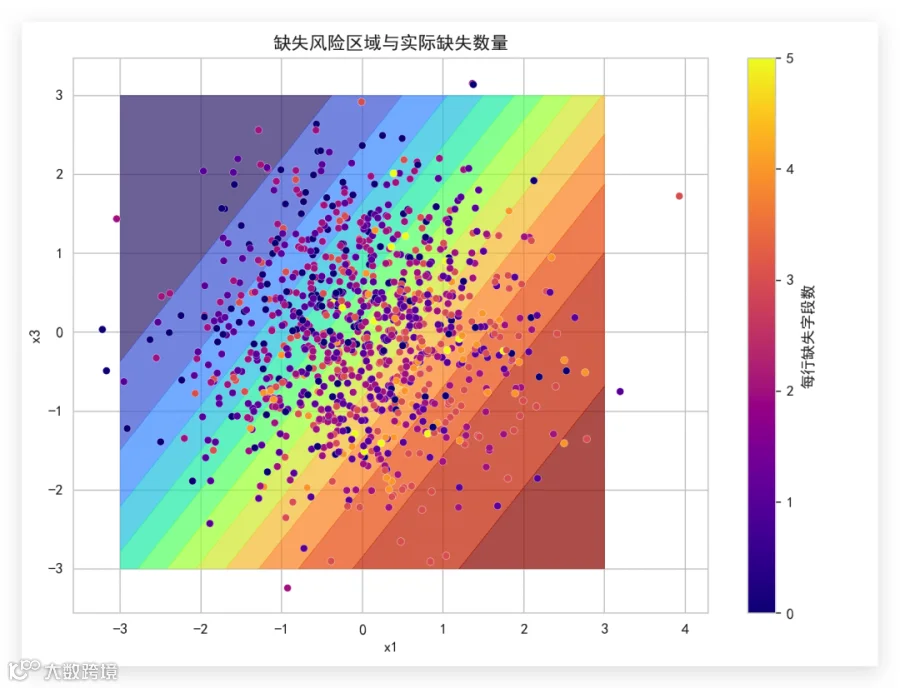
第一张图把缺失风险背景和实际缺失数量叠在一起。如果右上或左下区域颜色明显不同,说明缺失并非完全随机,而是受到 、 影响。此时直接删除样本,会让保留下来的数据产生偏差。
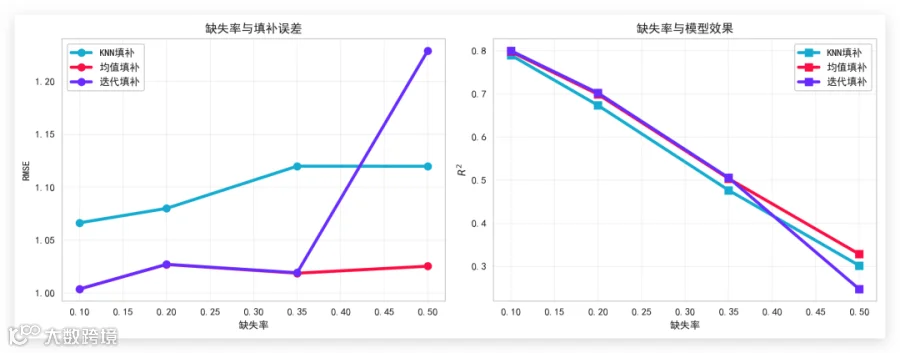
第二张图需要左右结合着看。左侧RMSE低,说明填补结果更接近真实值;右侧 高,说明处理后的数据更有利于下游模型。
这里要注意,填补误差最低,不代表模型效果一定最好。我们最终要根据业务目标选择方案,而不是只盯着填补值本身。
实际项目中,还要把填补器放进训练流程,只在训练集上执行fit,再对验证集和测试集执行transform,否则会发生数据泄漏。
最后
处理缺失值的关键,是先判断缺失机制,再比较不同方法对数据关系和模型效果的影响。均值填补适合快速基线,KNN适合局部结构明显的数据,迭代填补更擅长利用特征之间的关联。
接下来大家可以继续尝试增加缺失指示变量,告诉模型“这个位置原本为空”;也可以使用交叉验证联合调整邻居数量、迭代次数和下游模型参数。
总之就是说,填补只是手段,保证模型稳定泛化才是最终目标。