

编辑 | 余晓庆
审核 | 熊展坤

今天给大家介绍的是昌平实验室团队于2026年9月17日发布于arXiv的一篇工作,名为TorchCraft: Unified binder design by inverting an all-atom structure predictor,即TorchCraft:通过全原子结构预测器反向优化实现统一结合剂设计。
TorchCraft沿着BindCraft、Germinal等工作的预测器反向设计路线,利用TorchFold的PyTorch实现加载预训练AlphaFold3(AF3)权重,在冻结预测器的条件下优化结合剂序列。通过改变可编辑位点、分子约束和优化目标,同一框架可用于小型蛋白结合剂、纳米抗体(VHH)、环肽及小分子结合蛋白设计。
1.引言
蛋白质结合剂(binder)能够识别特定分子靶标,是研究分子相互作用、开发诊断工具和治疗性分子的重要载体。计算设计需要同时满足两个要求:设计序列能够形成稳定结构,并在目标表面建立合适的结合界面。对于抗体而言,还要兼顾框架稳定性和抗体序列自身的规律。
近年来,深度学习推动了多种结合剂设计方法的发展。其中,一类代表性路线是以RFdiffusion为代表的生成式设计:根据靶标结构和热点条件生成蛋白骨架,再用ProteinMPNN等逆折叠模型设计序列,最后借助alphafold2模型进行结构预测与筛选确定候选。这类流程通过不同模型分别完成结构生成、序列设计和评价。
另一类路线是预测器反向设计(predictor inversion)。BindCraft、Germinal等方法固定预训练结构预测器,将预测结果转化为设计目标,再通过梯度优化输入序列。结构预测器由此参与设计迭代,而不只是设计后的评价。其中,Germinal结合抗体语言模型IgLM,为抗体CDR优化加入序列先验。
AF3则将预测对象扩展到包含蛋白质、核酸、小分子、离子和修饰残基的全原子复合物,为更广泛的设计任务提供了统一分子表示。不过,预测能力并不自动等于设计能力:不同任务需要不同的可编辑区域、分子约束和序列控制,预测置信度也不能直接替代实验结合活性。
TorchCraft围绕这一问题展开:能否在同一个冻结全原子预测器上,建立可配置的序列优化流程,并在不同类型的结合剂中得到实验上能够结合的序列? 预测器梯度反向设计并非本文首创,BoltzDesign等工作也已探索全原子预测器反向设计。TorchCraft的重点是共享优化流程、任务专属约束,以及小型蛋白结合剂和VHH两类任务中的实验验证。
2.方法
2.1 TorchFold与TorchCraft:预测底座和设计流程
TorchCraft属于TorchX工具体系。理解这套方法,需要先区分 TorchFold、TorchScore和TorchCraft的作用。
TorchFold提供AF3兼容的PyTorch结构预测实现。 给定分子输入,模型先编码单体与成对表征,再建立链内和链间关系,随后由扩散模块生成全原子坐标,置信度模块则提供pLDDT、pTM、ipTM等指标。这些指标分别反映局部结构、整体结构及不同分子相对排布的预测可信程度。
TorchFold的独立论文还研究了抗体–抗原专项训练:从头训练的起始模型预测没有实验结构的序列对,以高置信预测结构作为额外监督,与实验结构一起微调;随后用第一阶段模型重新预测原先中等置信的候选,将新增高置信结构用于第二阶段训练。训练同时加入界面坐标监督,并调整扩散噪声日程。如图1、图2所示。
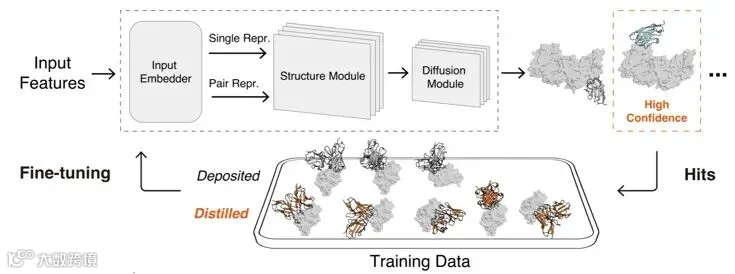
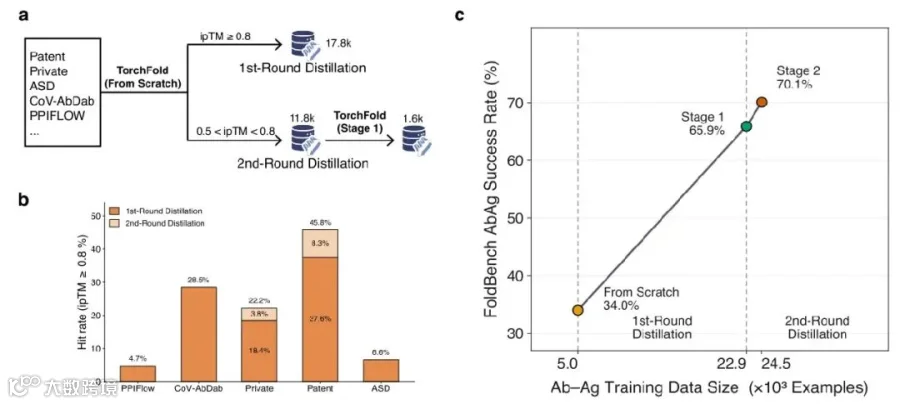
需要强调,TorchCraft本文所有设计使用的是官方预训练AF3权重,没有使用TorchFold抗体专项蒸馏后的新权重。 前者借助TorchFold的实现进行设计,后者是TorchFold独立训练研究的结果,两者不能混为一谈。
TorchScore则用于给已有坐标评分。它跳过扩散结构生成,通过置信度路径评价输入结构,并不重新折叠序列,也没有单独训练一个评分网络。本文的TorchScore同样加载预训练 AF3 权重。
2.2 总体框架:冻结预测器,迭代优化序列
TorchCraft将可设计序列表示为一张可训练的氨基酸logit矩阵:每个可编辑位置对应20种标准氨基酸的连续分数。靶标结构、固定序列区域和配体等构成设计上下文。如图3展示模型架构图。

每次迭代,模型将 logits 转换为当前序列表示,与靶标上下文一起输入冻结的预测器。预测器计算分子表征、距离分布、结构与置信度,设计流程据此计算加权损失,再将梯度传回序列 logits。序列先验损失也作用于这些可编辑变量。优化过程中,AF3 的网络权重保持不变,更新的是设计序列的连续表示。
各类目标承担不同作用。例如,界面置信度目标鼓励可信的分子相对排布;接触目标鼓励结合剂与靶标或热点形成接触;二级结构及紧凑性目标控制构象倾向;语言模型和氨基酸组成目标约束序列特征。具体任务只启用相应目标,并赋予不同权重。文中的多项几何目标通过预测距离分布构造,并不等同于对全部原子相互作用进行直接物理能量优化。
以VHH为例,一条设计轨迹采用80轮温度退火和5轮直通离散优化。前期输入是连续的氨基酸概率,温度逐渐下降后,概率更集中于少数氨基酸。最后5轮在前向计算时输入明确的离散序列,在反向计算时仍利用连续概率的近似梯度调整logits。这是在离散输入条件下继续优化,而非额外随机采样五条独立候选。最终按最高logit解码得到序列及对应的预测复合物。
2.3 VHH设计:固定框架,加入CDR专属IgLM引导
VHH只有一条抗体可变域链,三个CDR是主要的识别区域。TorchCraft固定预定义框架序列,将可编辑位置限制在CDR1、CDR2和CDR3,并通过paratope目标鼓励CDR–靶标接触,抑制框架主导的结合。
仅优化结构目标可能得到预测分数较高、但偏离抗体序列规律的CDR。因此,作者加入针对每个CDR的IgLM局部条件目标,如图4所示。

这一路径可以理解为“用当前抗体上下文,询问某个CDR应该是什么序列”。评价CDR1时,模型保留固定框架以及当前CDR2、CDR3的序列,将CDR1作为待填充区域交给冻结的IgLM,获得该区域的条件氨基酸分布。评价CDR2和CDR3时采用对应的上下文。三个CDR的目标在一次设计更新中加权汇总,而不是完整设计完一个CDR后再设计下一个。
图中的双路径解决了离散序列与梯度优化之间的衔接。上路对当前logits取最大值,构造IgLM所需的离散上下文;下路对原始logits做softmax,保留连续概率。IgLM给出的条件分布作为目标,通过交叉熵引导当前CDR概率。梯度通过下路回到序列logits,不穿过上路的argmax,也不更新IgLM权重。
这些局部序列损失再与结构和界面损失加权合并,共同调整同一组CDR logits。相比本文评测的Germinal全序列引导实现,这一设计将序列约束集中在可编辑CDR,并使用其余CDR作为条件上下文。但使用IgLM、冻结预测器并优化序列logits 的基本思想,在Germinal中已经存在。
3.实验
VHH部分可以沿着三个问题理解:序列引导是否改变了生成序列、生成序列是否真的能够结合,以及跨靶标表现如何。
3.1 CDR专属引导改善序列先验一致性
作者比较了有无IgLM引导的生成序列,并以天然VHH参考集及Germinal生成序列作为对照。结果显示,加入CDR专属引导后,CDR1和CDR2的IgLM对数似然提高,位点氨基酸偏好也更接近SAbDab参考分布;CDR3的变化相对有限。相关结果如图5所示。

原论文还报告了TNP成药性相关特征和OASis人源性评分的变化。加入IgLM后,OASis评分整体提高,说明更多局部序列片段符合人类抗体参考标准。总体上,这些分析支持局部序列先验改善了部分生成特征。
不过,IgLM似然的提高部分反映了优化目标自身的作用。人源性和成药性预测也是代理指标,不能直接证明免疫原性降低或表达一定改善。它们提供的是序列层面的支持,功能价值仍需实验检验。
3.2 四个靶标获得实验结合的VHH
作者分别针对BHRF1、EFNA5、PDGFRβ和S100A4生成12,500 个VHH候选,共50,000个。这些是计算生成数量,不是进入实验的序列数量。
候选先通过三项过滤:CDR interface rate > 0.6、CDR3 hotspot coverage rate > 0,以及TorchCraft ipTM > 0.7。前两项约束结合由CDR参与并覆盖指定热点,后一项要求较高的预测界面置信度。通过过滤后,作者使用Rosetta Interface Analyzer评价界面,并按以下综合分排序:
综合分 = 100 × ipTM − Rosetta 界面评分。
这个分数同时偏好较高的界面置信度和较有利的Rosetta界面评分,用于候选排序,并不是亲和力预测公式。排名靠前的候选进入表达、纯化和结合实验。湿实验结果如图6所示。

四个靶标均获得BLI检测到的结合物。图中代表性VHH针对BHRF1、EFNA5、PDGFRβ和S100A4的表观 KD分别为24.3、122、268和354 nM。KD 是解离常数,在相同测量条件与模型下,通常越小表示结合越紧。
这些进入实验的序列没有经过事后MPNN重设计,说明直接梯度优化可以产生具有结合活性的VHH。不过,代表性候选的KD不能替代整体实验命中率,也不能单独证明预测界面的准确性。
3.3 跨靶标计算基准:多数靶标通过率较高
作者进一步在15 个靶标、5种VHH框架上比较TorchCraft、Germinal、RFantibody和BoltzGen。每种方法在每个“靶标–框架”组合生成100个候选,因此每个靶标跨五种框架合计500个设计。
计算通过需要同时满足TorchScore ipTM > 0.7和ESM2-150M困惑度 < 6.31。前者衡量界面置信度,后者作为序列与表达相关的代理指标。该困惑度阈值来自论文的回顾性表达分析,不能直接推广为所有VHH的通用表达标准。计算实验结果如图7所示。

TorchCraft在多数靶标上获得较高的计算通过率,AbMPNN后处理在若干设置中进一步改善结果。但优势存在靶标依赖性,并非所有靶标都领先。这也说明,湿实验候选无需事后重设计,不代表重设计在其他应用中没有价值。
这组比较还有一个重要边界:TorchScore与TorchCraft设计阶段使用相同的AF3权重,因此评价并非独立于设计预测器。各方法后处理设置也存在差异。结果支持其在所选计算标准下的竞争力,但不能直接推出湿实验成功率或全面优于Germinal的结论。
3.4 从VHH扩展到其他结合剂类型
小型蛋白结合剂提供了另一组湿实验验证。作者针对IFNAR2、IL-7Rα、PDGFRβ和PD-L1,每个靶标生成3,000 个候选。经过紧凑性、结构置信度和界面置信度过滤及Rosetta 综合排序,四个靶标均获得BLI检测到的结合物。图中代表性候选的表观 KD 分别为60.2、8.55、2.04和23.3nM,实验序列同样未经事后MPNN 重设计。实验结果如图8所示。

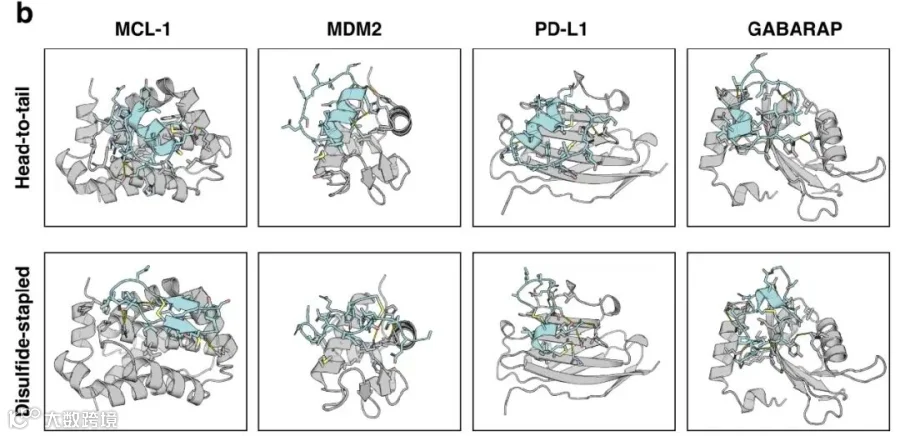
环肽任务展示了分子约束的适配。头尾环化设计通过循环相对位置编码表示首尾相邻;二硫键连接设计则固定参与连接的半胱氨酸位置。作者在八个靶标体系中比较计算通过率,并检查预期成环与主链完整性。结果随靶标和环化方式变化,支持框架的计算适用性,但目前没有环肽结合的湿实验验证。结果如图9所示。
小分子结合蛋白任务进一步改变了靶标化学环境。作者先进行不含配体的蛋白优化,再加入配体并逐步提高界面目标权重。针对十种小分子,每种生成500个长度为160个残基的蛋白,不提供天然蛋白骨架,并结合AutoDock Vina和Boltz-2进行计算评价。ATP、SAM、FAD等案例展示了形成配体相关口袋的可能性,但这些结果也仍需湿实验确认。如图10所示。

4.总结与讨论
TorchCraft将冻结的预训练AF3作为序列优化底座,通过可编辑位点、分子上下文、任务约束和设计损失,在共享流程中适配多类结合剂。对VHH,它固定框架、优化CDR,并用局部条件IgLM目标补充结构反馈;对环肽和小分子结合蛋白,则增加相应的环化约束或配体相关目标。
本文较有说服力的证据,是小型蛋白结合剂和VHH两类任务、各四个靶标中获得的实验结合物,而且展示的实验候选没有经过事后MPNN重设计。这说明直接优化序列的全原子设计流程具有实际可行性。跨靶标计算基准和其他任务案例,则为适用范围提供了进一步支持。
同时,工作的边界也很明确。环肽和小分子任务尚缺湿实验;部分计算评价与设计共享AF3权重;序列正则化对表达与结合的收益仍需要匹配条件的实验对照。论文也没有用同靶标、同框架和同预算的湿实验,证明TorchCraft在抗体设计上全面优于Germinal。BLI结合测量本身亦不能确认预测的结合位姿。
因此,这篇工作的价值应理解为在已有预测器反向设计思想上,以预训练AF3的全原子表示构建可配置的设计流程,并在两类蛋白结合剂中验证直接生成序列的结合能力。
下一步值得关注的问题包括独立预测器和实验评价能否保留计算优势;TorchFold抗体专项权重是否能改善设计结果;更直接的原子接触与化学几何目标能否带来实际收益。对于抗体设计研究,这项工作也提示,序列先验和结构目标需要相互补充,而评估必须进一步落到表达、结合及其他功能指标,避免只优化预测分数。
参考资料
论文:https://arxiv.org/abs/2609.19770v1
项目代码:TorchX(包含TorchCraft、TorchFold和TorchScore) :https://github.com/Mingchenchen/TorchX

扫描二维码获取
更多精彩
AI in Graph
本公众号主要介绍应用于图、知识图谱的人工智能算法和研究进展,及其在生物信息、医学健康领域的应用。欢迎关注本公众号获取领域最新文献解读。

点个在看+赞支持一下