

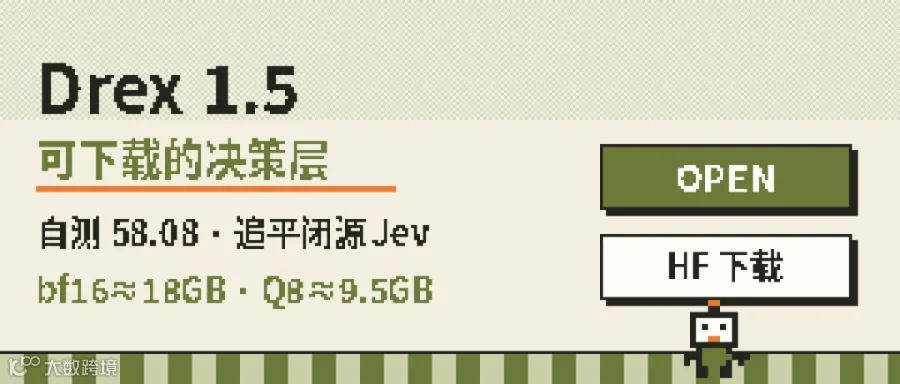
昨天写微软 Decision-1 的时候,我卡在一句话上:这东西有意思,但权重你拿不到。同一波「决策模型」里,Nace.AI 把 Drex 1.5 放到了 Hugging Face。大约 9B 参数,不写长文,只给固定选项打概率。模型卡自报:公开 Decision Index 0.3.1 上 58.08,和闭源的 Jev 1.13.0(57.96)落在同一档。
做应用的人其实不缺又一个聊天模型,缺的是能塞进流水线、输出稳定、还能自己托管的判断件。Drex 刚好撞在这个缺口上。
有点兴奋,也有点警惕。兴奋是因为「拍板」这件事终于可以被单独下载;警惕是因为自报分数再好看,接到你自己的工单上,照样可能翻车。今天想把可下载决策层拆开:能干嘛、怎么下、显存大概多少、一个能跑的例子,以及上线前怎么判定值不值得接。
01
PART
它到底干什么
WHAT IT DOES

普通大模型回答问题,是一个字一个字往外吐。你问「这条工单该交给谁」,它可能先客套两句,再给结论,程序还得从自然语言里把答案抠出来。选项一换顺序,结论偶尔还会跟着飘——做过分流系统的人都知道有多烦。
Drex 1.5 的做法反过来:你先定好状态(一段文本或一段 JSON)和问题类型,它一次前向计算就给每个选项一个概率。支持三种题型:choice(多选一)、noul(是非题)、score(有序量表)。它不采样 token,temperature、top_p 基本用不上。你给什么选项,它就只能在这些选项里选——这既是限制,也是可控性。
底座是 XiaomiMiMo 的 MiMo-V2.6-Distill-Qwen-9B(蒸馏自 Qwen3.5-9B 一脉),再加一个 pointer head(head.pt)。对外统一走 POST /v1/systemone,和 TypeSafe Jev 的请求格式兼容。很多现成客户端改几个环境变量就能试。
我喜欢的分工是这样的:大模型继续负责想和写,小模型负责快速拍板。客服分流、内容是否违规、这一步 Agent 要不要重试、要不要升级人工——这些检查点,终于有了一个专门的座位。
8.95B
参数约数
58.08
自报公开指数
9.5GB
Q8 约大小
02
PART
下载、显存、可跑例子
RUN IT
数字来自 Hugging Face 模型卡和 MarkTechPost;涉及成绩的一律按「官方自报」理解。
下载 bf16(约 18 GB):`hf download nace-ai/drex-v1.5 --local-dir drex-v1.5`,建虚拟环境后 `pip install -r requirements.txt`,再跑 `python inference.py`。换成自己的请求:`python inference.py --request examples/request.json`。
起本地服务:`python serve.py --port 8000`,然后对 `http://127.0.0.1:8000/v1/systemone` 发 POST。默认绑本机,健康检查是 `GET /health`。默认上下文 16,384 token,最长可调到 131,072(`KEV_CONTEXT`)。模型卡提醒:别把未加鉴权的服务直接暴露到公网。
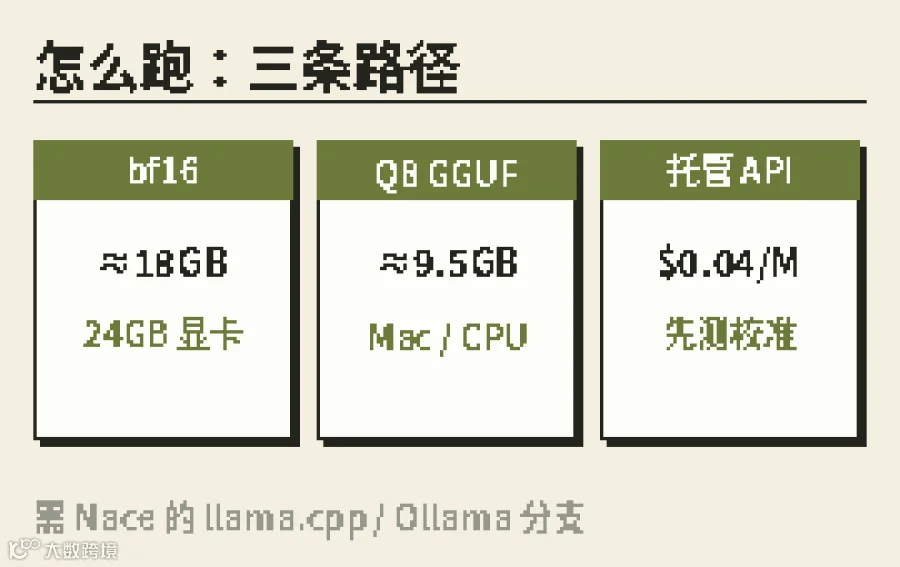
显存路径:bf16 磁盘约 18 GB,Nace 在 24 GB A10G 上测过;Q8_0 GGUF 约 9.5 GB,可走他们维护的 llama.cpp / Ollama 分支,在 Apple silicon 或 CPU 上跑。主线 llama.cpp 不够用——接口是 `/v1/systemone`,不是普通 chat。
模型卡例子大致是:state 写「订单 A-104 被扣了两次费」,questions 问该交给哪个团队,以及客户是否在要退款。想接编码 Agent,他们也提供了 skill(Claude Code、Cursor、Codex 等)。不想本地装,OpenRouter 托管约 每百万输入 0.04 美元、输出 0 美元(经 DeepInfra)。
许可是 Nace.AI Open RAIL-M,不是 Apache。商用前把 LICENSE 读完。
03
PART
成绩单与冷水
BENCHMARKS

公开 Decision Index 0.3.1 上,模型卡写:Drex 58.08、Jev 57.96、Nimble 57.19,落在榜方 0.9 分平局带。Drex 自报 37 项里 20 项高于 Jev。Tools 75.0 较强,Knowledge & Reasoning 44.6 偏弱。JevBench 上 Drex 86.2%、Jev 87.0%。
长文档卖点:8k–32k 准确率 89.5%、中位延迟 0.65 秒;32k–128k 准确率 93.4%、中位 2.0 秒。同一批截断到 8k,准确率掉到 76%–78% 一带——说明它确实在吃长上下文。
冷水也要泼透:这些是自报;知识题偏弱(MarkTechPost 转述 GPQA Diamond 约 45.4%,Jev 约 78.6%);它不会解释,只出概率;训练见过 Index 训练集,换到你的业务域必须重测。读者如果只记住一个数字,请记住 58.08 是自报公开指数,不是你业务集上的 F1。
我的态度:这是目前「能下载、API 兼容、硬件门槛还算正常人」的决策层里,值得优先试的一个。但它不是银弹。
04
PART
如何判定值不值得上线
DECIDE

评价词先立在这:可下载决策层。判定不是看新闻稿,是看你能不能用下面五步把它打穿。
第一步:划清边界。只把「选项可穷举」的判断交给它——路由、是否重试、是否升级人工、标签是否命中。需要写代码、写回复、写方案的,继续用大模型。
第二步:用真实样本建表。抽 200–500 条历史工单或 Agent 轨迹,人工标金标准。没有金标准,后面全是玄学。
第三步:先托管后本地。用 OpenRouter 或 Nace API 打完同一批样本,算准率、校准曲线、延迟 P50/P95。不满意就停,别急着下 18 GB。
第四步:再上本地。有 24 GB 显卡走 bf16;笔记本优先 Q8。对比本地与托管答案是否一致。数据不能出域的团队,这一步才是真正的「可下载」价值。
第五步:定策略,不要裸用 argmax。例如最高概率 ≥0.85 自动执行;0.6–0.85 换大模型复核;低于 0.6 交给人。阈值按业务损失调,别抄我的数字。
还有个容易忽略的细节:同一请求里可以塞多个 questions。state 只编码一次,每个问题各自走一遍 pointer head。客服场景里「该交给谁」和「要不要退款」常常一起出现,这种打包方式比连着调两次大模型干净得多。
对做应用的人:Agent 检查点可以变便宜;内网部署有路径;但许可证和弱项知识题会卡商用与某些垂直域。兴奋点在「终于能自己跑」;失望点在「跑起来之后,校准和策略设计一点没少」。
05
PART
文末清单
CHECKLIST
CHECKLIST · 照着做
☐ 读完 LICENSE(Open RAIL-M),确认用途是否允许
☐ hf download nace-ai/drex-v1.5,跑通 inference.py
☐ 用自己的 20 条样本改 examples/request.json
☐ 准备至少 200 条带金标准的评测集
☐ 托管 API 先测准率与校准,再决定是否本地化
☐ 写清自动执行 / 复核 / 人工的概率阈值
☐ Mac/CPU:准备 Nace llama.cpp 分支和 Q8 GGUF
☐ 不要用它写长文、写代码、当百科
如果你昨天看过 Decision-1 那篇,可以把两篇对着读:闭源产品看生态与延迟故事,开源这边看下载与校准故事。两条线其实在回答同一个问题——Agent 里那些小判断,还要不要每次都去烦大模型。
我挺期待「决策层」这条线继续开源。不过能下载只是入场券;能校准、能定策略、能扛住你自己的坏例子,才叫上线。
往期 · 接着看
微软发了个只做选择题的模型,自测比GPT-6 Sol快35倍
Step 5:600B 只激活 27B
出处:Hugging Face nace-ai/drex-v1.5 模型卡;MarkTechPost 2026-10-09;OpenRouter/DeepInfra 公开标价;本号 10-10 Decision-1 相关背景。
觉得有用的话,点个赞或在看,我们下篇见
THANKS FOR READING