


当我们最初使用大模型时
会遇到下面这种情况


其实大模型本身没有
短期存储记忆
它不会“记住”上一轮
聊过什么内容
每一次生成回答
都是一次全新的独立计算
但我们之所以感觉
与大模型对话很顺畅
是因为系统会把历史记录
全部塞到新一轮输入里
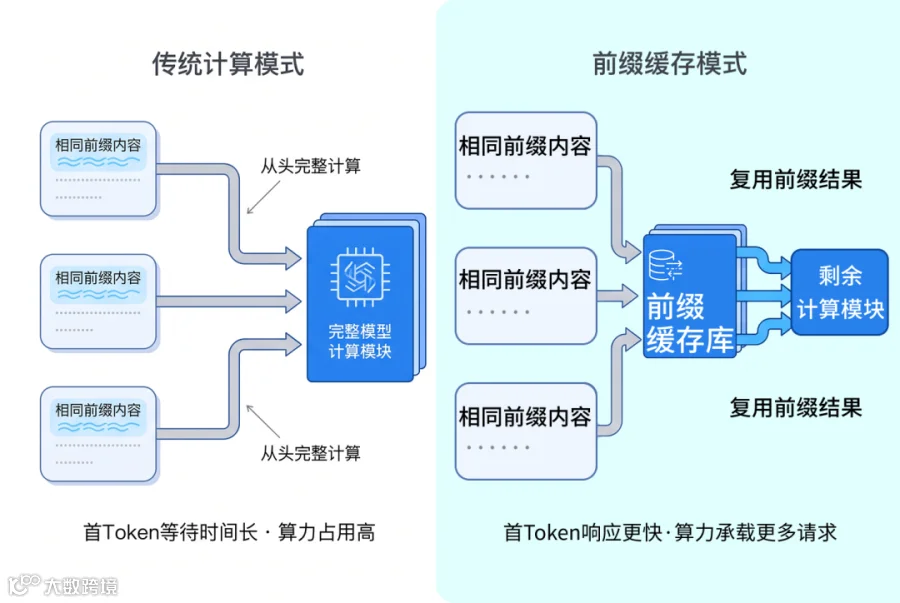
随着多轮对话、知识库问答、智能体调用工具等大模型应用形式越来越丰富,同一段上下文会被反复使用。对话轮数越多,每次重复的文本就越长。每请求一次,GPU 就要把一大段相同的内容重新计算一遍,不仅浪费算力资源,还会出现响应慢、并发低等问题。
因此,一项新的能力被设计出来,就是“前缀缓存”。系统会把已经处理过的结果保存下来,后续请求如果拥有相同“前缀”,就可直接复用,不必从头计算。这样既能缩短用户等待第一个 token 的时间,也能让同样的算力服务更多请求。
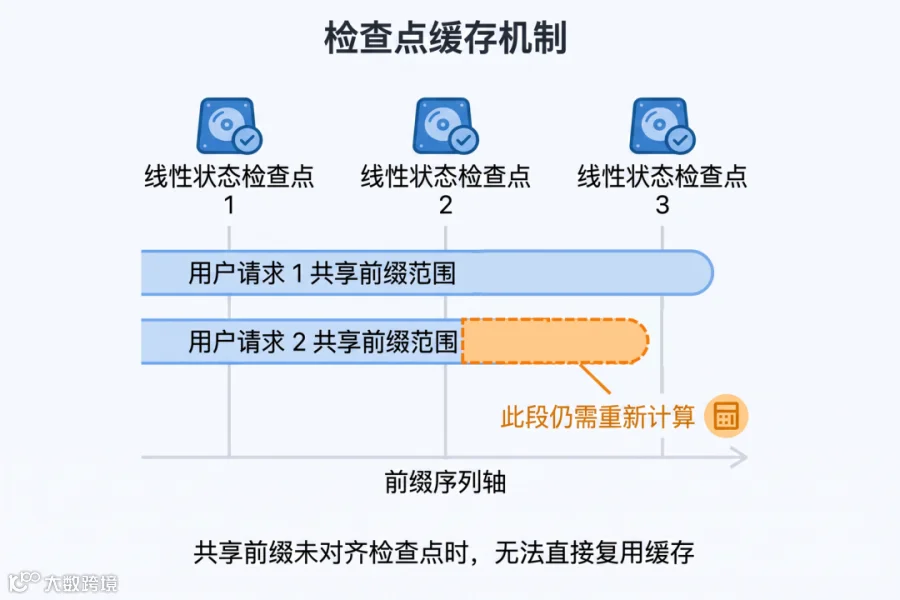
但随着混合注意力大模型的广泛应用,前缀缓存又遇到新的挑战。这类模型包含一个“线性注意力层”,它不保存每一条原始记录,只维护一份不断被改写更新的“内容摘要”。每来一段新文字,就直接修改这份摘要,旧版本会直接被覆盖掉,不会留存历史快照。
摘要一旦更新,就无法直接退回到之前状态。因此,现有系统通常会每隔一段距离保存一次线性状态检查点。这就像游戏里的存档点,请求只能从存档点继续运行。如果两个请求共享的前缀恰好结束在两个检查点之间,中间那部分仍然需要重新计算。
那么问题来了,把存档点设置得密集一些行不行?
现实很残酷:一份线性状态检查点体积十分庞大。如果存档点过密,显存占用就会爆炸。比如想要做到每 64token 都可以恢复上下文,传统方案仅存档点就需要 80GB 显存,几乎耗尽一张高端显卡全部显存资源。

为了解决这一难题,中国电信集团 CTO、首席科学家、中国电信人工智能研究院(TeleAI)院长李学龙教授带领科研团队从“以计算换存储”的理念出发,提出面向混合注意力模型的全新缓存方法 SuffixReplay,以少量计算开销就能换取巨大的存储资源节省,让智传网(AI Flow)在“视频”及“长文本”都可实现“算-存-传”的转换与统一。
TeleAI 团队在研究中发现:线性注意力自带衰减遗忘机制,久远历史内容对当前模型状态的影响已经微乎其微。因此,恢复某一位置状态,不需要回放全部上下文,只需要重放该位置前一小段最近内容,就可以还原出足够高质量的状态。
传统方案存储的是完整的模型状态,而 SuffixReplay 只存储少量用于重放的输入隐藏状态(锚点)。当缓存命中之后,读取附近锚点,重放有限长度的后缀内容,现场重建线性状态。额外计算量只取决于重放片段长短,不会跟随上下文总长度膨胀。
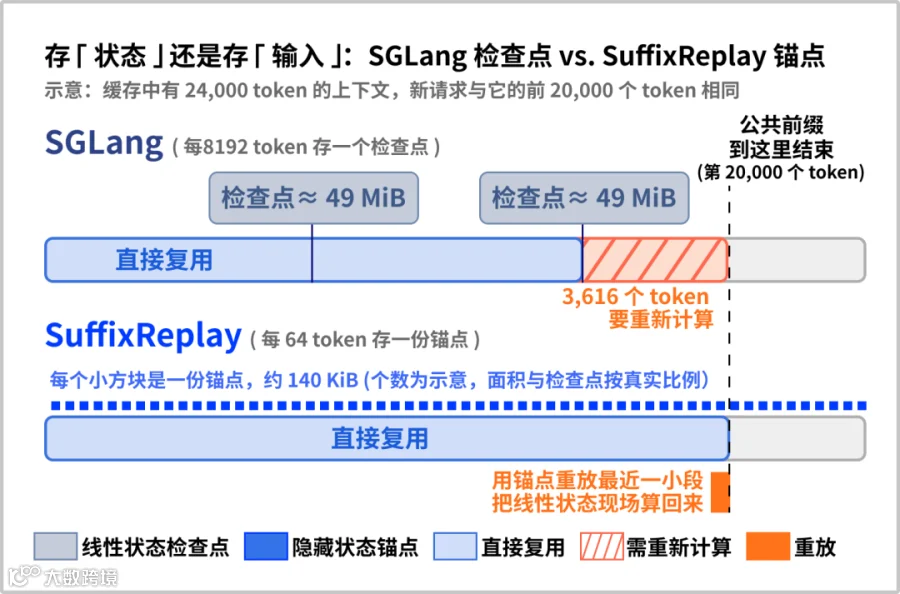
总结来说,SuffixReplay 给出的核心解法是“以计算换存储”,不再存储完整庞大的线性状态,转而保存轻量化“锚点”,需要恢复状态时,现场重放一小段近期输入,近似还原线性注意力状态。
在同样复用粒度,SuffixReplay 额外存储仅为传统方案的 1/250-1/360,节省 99.6% 以上状态存储空间!
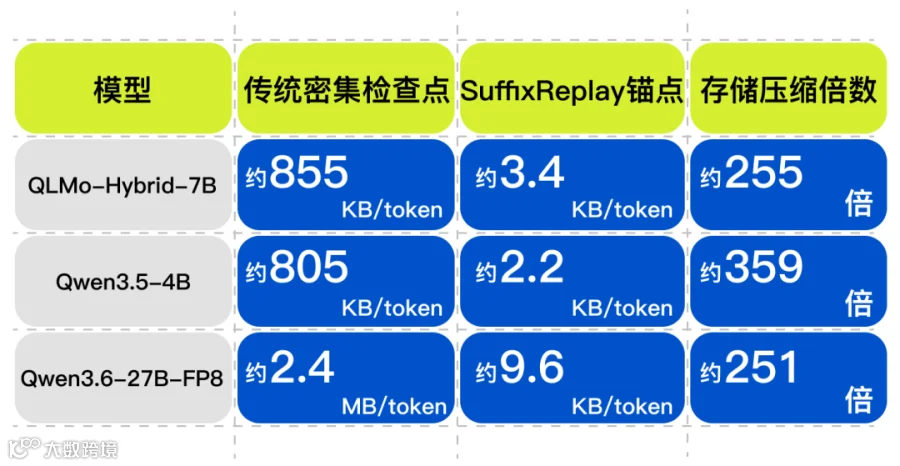
直观对比:缓存 10 万 token 长上下文,Qwen3.6-27B-FP8 传统密集检查点方案需要 240GB 存储,差不多要 3 张 80GB 显卡显存;SuffixReplay 仅仅只需要 0.96GB 锚点存储。
即便对比 SGLang 默认稀疏存档配置,SuffixReplay 把缓存复用粒度提升 128 倍,额外存储开销却只有原来的 0.36-0.51 倍。

“计算换存储”不能盲目牺牲生成质量,TeleAI 团队做了多层工程设计,把重放误差、计算开销牢牢控制住。
将连续的线性注意力层划分成若干计算组,每组入口处保存锚点。重放仅在组内执行,全注意力层直接复用 KV 缓存跳过计算。重建误差被限制在单个组内部,不会沿着模型层层叠加放大,保障输出质量稳定。
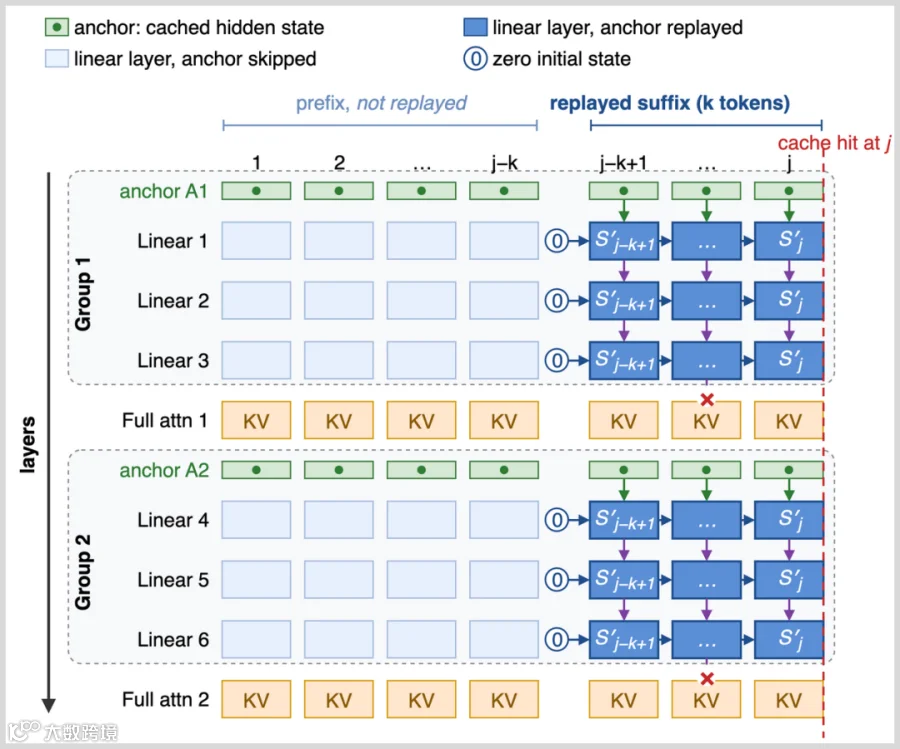
推理引擎是以 64-token 的 Page 单元管理 KV 缓存。SuffixReplay 锚点和 Page 边界对齐,只在缓存真正能复用的位置保存锚点。实验验证锚点放在每个 Page 末尾,重建效果优于均匀分散布局,采用 dense anchor 布局策略,最大化重放效果。
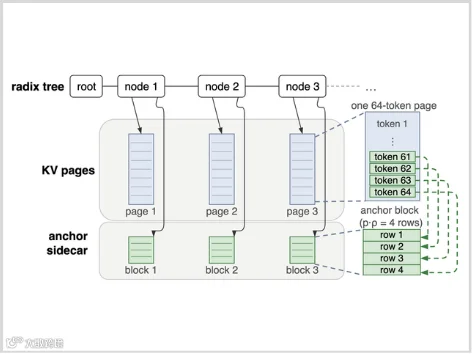
锚点和 KV 缓存生命周期绑定,但物理存储、数据搬运相互独立。锚点只有状态重建时刻读取,生成阶段不再访问。缓存命中后,锚点读取、KV 搬运、状态重放、token 生成流水线并行重叠执行。对于连续多轮请求,线性状态仍然有效时,可以直接跳过重放逻辑,几乎零额外开销。
TeleAI 团队将 SuffixReplay 在 OLMoHybrid-7B、Qwen3.5-4B、Qwen3.6-27B-FP8 三款混合注意力大模型进行完成完整评测。
结果显示:答复速度提升,长文本效果几乎无损。
输出质量基本无损
在 LongBench、RULER 长文本评测集上,效果可以达到完整预填充的 91.4%-100%,两款 Qwen 系列模型得分均超过 99%。只重放很短片段,输出质量几乎和完整重算保持一致。

服务性能显著提升
(集成 SGLang)
