


题目:Seek in the Dark: Reasoning via Test-Time Instance-Level Policy Gradient in Latent Space(LatentSeek)
论文地址:https://arxiv.org/abs/2505.13308
代码地址:https://github.com/bigai-nlco/LatentSeek
创新点
•首次提出在大模型隐空间做实例级测试时自适应框架 LatentSeek,区别于过往测试时优化大多在 token 文本空间开展的思路,全程不需要更新模型权重参数,仅在推理阶段针对单个问题实例优化隐表征。
•采用策略梯度方法迭代优化隐向量,使用模型自身生成的奖励信号作为优化目标,优化完成后的隐表征再解码得到文本输出,开辟了隐空间维度的测试时缩放新方向。
方法
本文提出 LatentSeek 框架,在不改动大模型原有权重的前提下,针对每一个输入实例,于模型隐空间中利用策略梯度对隐表征向量进行测试时迭代优化,以模型自身生成的奖励信号作为优化目标,不断调整隐向量,优化完成后的隐表征送入模型解码器生成最终文本答案,整个流程只在推理阶段执行,无需训练或者微调模型参数,该框架可以搭载在不同的大模型主干之上,针对数学推理任务完成验证,在推理过程中只需要少量迭代步骤就能够完成隐向量的寻优。
强化微调、提示工程与 LatentSeek 框架对比
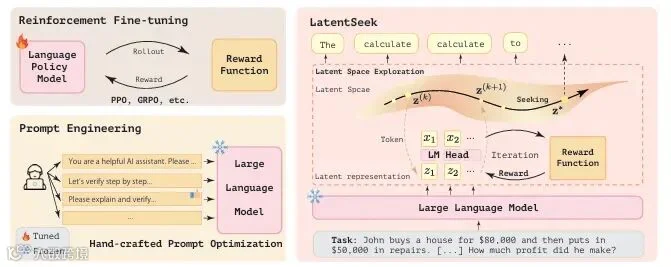
本图对比三种大模型增强推理的方案,左上角强化微调需要更新语言策略模型权重,通过 Rollout 和奖励函数借助 PPO、GRPO 等算法完成模型训练,左下角提示工程在冻结模型权重的前提下依靠人工设计提示词来引导模型输出,右侧 LatentSeek 则保持大模型参数完全固定,针对单个任务实例在隐空间迭代搜索最优隐表征 z,利用 LM Head 解码 token 并经由奖励函数反馈,不断迭代寻优得到最优隐向量 z*,最终生成答案,不需要修改模型权重或反复设计提示词。
不同参数量 Qwen2.5 模型下,LatentSeek 迭代次数与准确率变化曲线
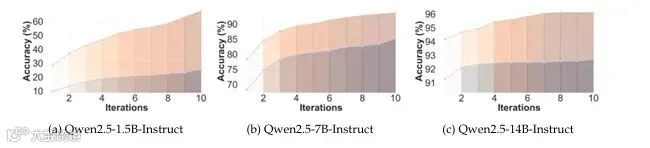
本图包含三组子图,分别对应 Qwen2.5-1.5B-Instruct、Qwen2.5-7B-Instruct、Qwen2.5-14B-Instruct 模型,横轴代表隐空间优化迭代次数,纵轴为任务准确率,蓝色基线是模型原始推理效果,橙色曲线为 LatentSeek 方法的效果,可以看到随着迭代次数增加,所有模型的准确率均持续提升,且 LatentSeek 始终高于原始模型基线,同时小参数量模型获得的相对增益幅度更大,证明该隐空间迭代优化方案对不同规模大模型都有效。
隐空间寻优过程的三维可视化
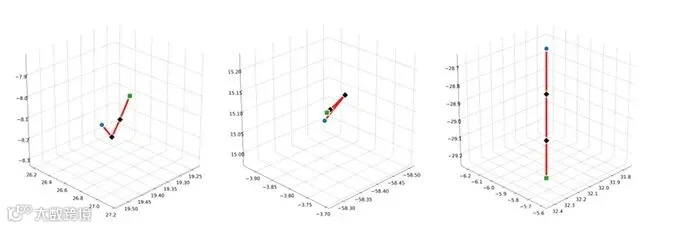
本图包含三组三维子图,展示 LatentSeek 在隐空间中搜索最优表征向量的轨迹,图中不同颜色标记代表迭代过程中不同时刻的隐向量点,线条呈现从初始隐表征逐步迭代移动、向最优表征位置靠近的路径,直观展现了 LatentSeek 在隐空间里逐步探索寻优的过程,体现该方法不是随机搜索,而是沿着特定方向迭代更新隐表征,最终抵达具备更高奖励值的隐向量位置。
实验
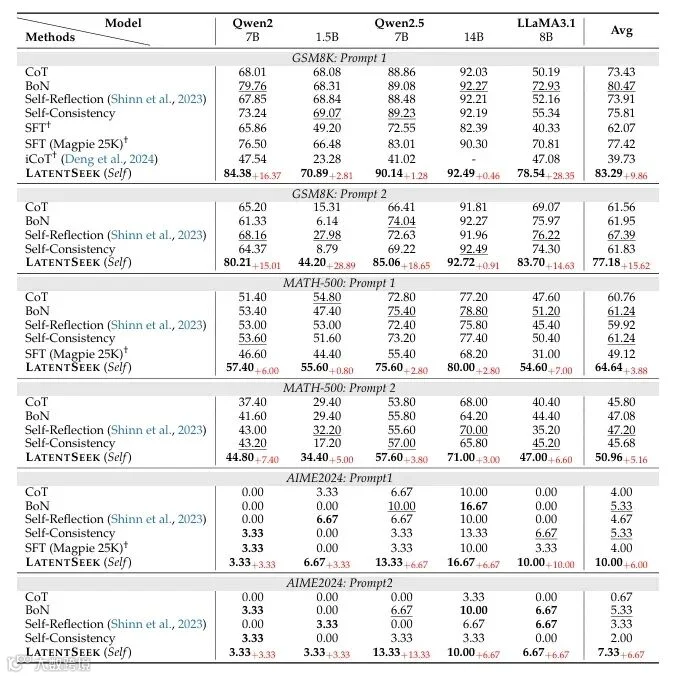
该表格在 GSM8K、MATH-500、AIME2024 多个数学推理数据集搭配不同提示词下,使用 Qwen2、Qwen2.5、LLaMA3.1 多款模型,对比 CoT、BoN、Self-Reflection、Self-Consistency、SFT、iCoT 等主流基线方法与 LatentSeek 的推理准确率,同时列出各方法在全部模型上的平均结果,数据显示 LatentSeek 在绝大多数实验设置下均取得更高准确率,证明该隐空间测试时优化方法能够稳定提升大模型数学推理能力。