



编者摘要:本书系统讲解大语言模型的基础理论,把 LLM 发展划分为预训练‑提示‑微调‑对齐‑推理‑增强推理完整链路。
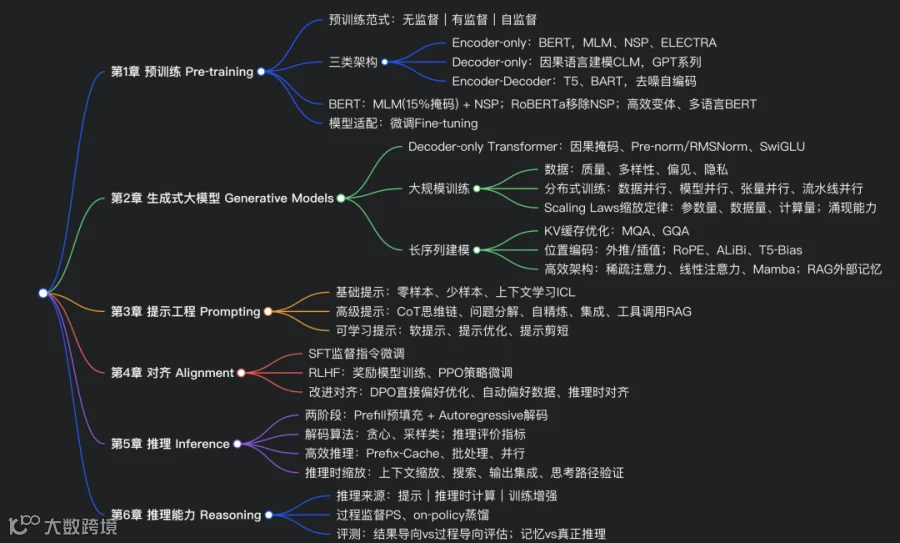
第 1 章介绍 NLP 预训练范式,自监督预训练成为主流,分为编码器、解码器、编解码器三类架构。BERT 采用掩码语言建模 MLM,依靠双向上下文做理解任务;RoBERTa 证明增大数据规模可提升效果,NSP 任务并非必需。预训练后主要通过微调适配下游任务,实现文本分类、序列标注、阅读理解。
第 2 章聚焦解码器仅架构的生成式大模型,核心是因果语言建模,依据上文预测下一个 token。大规模训练面临数据质量、训练不稳定、算力瓶颈,依靠多种分布式并行策略完成训练;缩放定律揭示模型性能随参数量、训练 token、算力呈幂律提升,并带来涌现能力。长上下文是现实刚需,通过 MQA/GQA 压缩 KV 缓存、改进位置编码(RoPE、ALiBi)、稀疏注意力、RAG 检索增强等方式突破原生 Transformer 长度限制。
第 3 章阐述提示技术。上下文学习无需更新参数,仅依靠输入样例完成任务;CoT 思维链通过分步思考显著提升复杂问题表现;同时还有软提示等可学习提示方案,将提示作为可训练参数。
第 4 章讲解对齐技术。先做指令监督微调 SFT 激活模型的指令遵循能力;RLHF 利用人类偏好训练奖励模型,再强化学习优化策略;DPO 等新算法简化流程,直接使用偏好对训练,省去独立奖励模型。
第 5 章讲解推理阶段技术,推理分为预填充 Prefill 和解码两个阶段。Prefix 缓存、批处理等工程手段大幅提升吞吐;推理时缩放,增加搜索、多次采样,不用改模型权重就可以提升效果。
第 6 章专门讨论 LLM 推理能力。推理能力可以来自提示、推理时额外计算,也可以依靠训练数据、过程监督。评测分为看最终答案的结果评测和检验中间步骤的过程评测。同时探讨关键议题:模型究竟是记忆还是真正完成逻辑推理。
全书贯穿范式变革:从任务上单独训练模型,到预训练基座模型,再通过提示、微调、对齐适配任务。

《Foundations of Large Language Models》版本差异
文献编号:arXiv:2501.09223,作者肖桐、朱靖波(东北大学 NLP 实验室、NiuTrans)arXiv 版本时间线:
- v1:2025‑01‑16
初版,5 个章节 - v2:2025‑06‑15
第一次修订 - v3:中间迭代版本(arxiv 未公开摘要变更记录)
- v4:2026‑10‑08(你当前阅读的版本,最新版)
,全书扩展为6 章arXiv
一、核心结构性变化(v1/v2 → v4)
- 新增完整第 6 章《Reasoning(推理能力)》【最大改动】
-
v1/v2 原版只有 5 章:预训练、生成模型、提示、对齐、推理(inference,工程推理,不是思维推理)arXiv。 -
v4 把“模型推理能力(思考、逻辑、数学推理)” 独立成第 6 章,和第 5 章推理工程(Inference,解码、加速)做明确切割。 -
第 6 章内容:推理的定义;提示实现推理;推理时计算缩放;训练侧增强推理(过程监督 PS、on‑policy 蒸馏);推理评测(结果 vs 过程评价);开放议题:记忆 vs 真正推理、内部 / 外部推理。 - 第 2 章 生成式模型(Generative Models)大规模扩充长序列建模
-
硬件并行优化(序列并行) -
高效架构:稀疏注意力、线性注意力、Mamba(状态空间模型) -
KV 缓存体系:固定大小缓存、压缩记忆 Compressive Transformer、外部记忆、RAG、k‑NN‑LM -
KV 缓存优化:MQA、GQA、跨层 KV 共享 -
位置编码完整对比:外推 / 插值;T5‑bias、ALiBi、RoPE 旋转位置嵌入;大量公式 + 示意图。 -
v2 长序列内容比较薄;v4 大幅扩充长上下文 LLM: -
更新最新开源大模型参数表格:Llama3/3.1、Gemma2、Qwen2.5、DeepSeek‑V3、Falcon、Mistral 等模型参数量、层数、头配置对照表。 -
更新预训练 token 规模表格,加入万亿级 token 数据统计。 - 第 4 章 Alignment 对齐章节扩充
-
v2 只重点讲 RLHF;v4 强化DPO 直接偏好优化整套内容,增加自动偏好数据生成、分步对齐、推理时对齐;补充奖励模型 pair‑wise 损失公式。 - 第 5 章 Inference(工程推理 / 解码)扩展推理时缩放(Inference‑time Scaling)
-
完善 Prefill‑Decode 两阶段;Prefix Caching;批处理并行;推理时缩放:上下文缩放、搜索缩放、输出集成、思考路径验证。 - 第 3 章 Prompting 提示工程更新
-
增加自精炼 Self‑refinement;集成 Ensembling;RAG 与工具使用;软提示、提示长度裁剪等细节。 - 第 1 章预训练小幅优化
-
完善 BERT、RoBERTa、ELECTRA、mBERT/XLM;补充编码器‑解码器预训练各类去噪任务对比表格。
二、次要修订(v4 对比旧版)
- 参考文献大规模更新(截止 2026 年),引用 Llama3、Qwen、DeepSeek、Mamba、GQA、RoPE、DPO、过程监督等近年论文。
- 大量新增示意图
自注意力掩码对比图、KV 缓存、位置编码外推插值、MQA/GQA 图解、RLHF 流程框图。 - 勘误修正
修正 v1/v2 公式笔误、符号错误、文字歧义;符号表 Notation 完善。 - 前言更新
说明本书来自 NiuTrans NLPBook 开源仓库;版权更新至 2026。 -
章节小结、课后思考(隐性)、部分段落重新组织,可读性提升。
三、各版本目录对比简表
|
|
|
|---|---|
|
|
|
| v4(当前) |
|
四、阅读建议
-
如果你手上是 v1/v2 旧版:强烈建议读 v4 版本,第 6 章推理是现在 LLM 最核心的主题,旧版完全缺失。长上下文、DPO、GQA/MQA、RoPE 内容旧版篇幅极少。 -
v4 依旧坚持原书定位:偏重基础原理,不是追全部最前沿花哨技术,适合课程学习、入门,不堆砌小众 SOTA。 -
原始素材来源:https://github.com/NiuTrans/NLPBook,讲义会持续迭代。
补充区分两个易混淆概念:
-
Ch5 Inference:工程推理,模型解码、GPU 加速、KV 缓存; -
Ch6 Reasoning:智能推理能力,思维链、数学逻辑、过程监督,v4 新增独立一章。
20 个关键问题问答
- 三种预训练方式分别是什么?
无监督预训练、有监督预训练、自监督预训练;当前 LLM 主要用自监督预训练。 - Encoder‑only、Decoder‑only、Encoder‑Decoder 架构核心区别?
Encoder‑only 双向上下文,侧重理解;Decoder‑only 因果掩码只能看上文,侧重生成;Encoder‑Decoder 同时处理源输入与目标输出,适合 seq‑to‑seq。 - BERT 的两个预训练任务?
掩码语言建模 MLM、下一句预测 NSP。 - RoBERTa 主要改进是什么?
使用更多训练数据与计算资源;移除 NSP 损失依然效果很好。 - 什么是因果语言建模 CLM?
解码器仅模型,利用历史上文,自回归预测下一个 token。 - 分布式训练 4 种并行方式?
数据并行、模型并行、张量并行、流水线并行。 - 缩放定律 Scaling Laws 核心含义?
在一定范围内,模型损失随参数量、训练 token、计算量呈幂律下降,带来涌现能力。 - KV 缓存作用是什么?
保存历史的 key、value,避免重复计算,加速自回归生成。 - MQA、GQA 作用?
多头共享 KV,降低 KV 缓存显存开销,加速推理。 - RoPE、ALiBi 解决什么问题?
位置编码,提升模型对长序列的外推能力。 - 什么是上下文学习 ICL?
不给模型更新梯度,仅在输入提示中加入示例,让模型完成任务。 - CoT 思维链的核心思想?
在提示中加入分步推理过程,引导模型输出中间步骤,提升复杂推理效果。 - SFT 指令微调目的?
用指令‑回答样本微调基座,激活模型遵循指令的能力。 - RLHF 包含哪几个主要步骤?
预训练 + SFT;收集人类偏好排序数据;训练奖励模型;PPO 强化学习微调策略。 - DPO 相比 RLHF 优势?
直接利用偏好对做损失,不需要单独训练奖励模型、不需要 PPO,流程更简单稳定。 - LLM 推理 Prefill 与 Decode 两阶段含义?
Prefill:一次性处理全部输入上下文;Decode:逐 token 自回归生成输出。 - Prefix‑Cache 作用?
复用重复上下文的 KV 缓存,减少重复计算,提升吞吐。 - 什么叫推理时缩放?
不改变模型权重,推理阶段增加计算资源(多次采样、搜索)提升模型效果。 - 过程监督 PS 和结果监督区别?
结果监督只评判最终答案;过程监督评判每一步中间推理步骤,提升推理质量。 - 本书提出 LLM 领域的开放问题?
有限数据高效学习;真正推理能力;区分记忆与推理;长上下文泛化等
附录:《Foundations of Large Language Models》(肖桐、朱靖波 v4) 与国内、国外同类讲义对比 + 下一版本增补个人建议(AI参考建议)
对比对象:复旦《大规模语言模型:从理论到实践》、浙大 AI 通识系列、清华大模型工程实践教材、斯坦福 CS336 / Jurafsky SLP3Stanford C...
一、各教材定位与特色对比
表格
|
|
|
|
|
|---|---|---|---|
| 东北大学(NiuTrans)Foundations of LLMs v4 | 学术理论向讲义
|
Inference(工程解码加速)与Reasoning(模型推理思考能力);2)完整对比 Encoder‑only / Decoder‑only / Encoder‑Decoder;3)长序列技术(RoPE、ALiBi、MQA/GQA、Mamba、RAG、KV 缓存)理论推导充分;4)对齐部分 RLHF、DPO 损失公式完整;5)自监督预训练任务对比表格详实;6)符号体系统一严谨
|
缺少工程实战、缺少多模态、缺少 MoE 混合专家、缺少大模型评测完整体系、几乎没有习题 / 实验指导、智能体 Agent 内容很少、中文大模型实践内容少 |
| 复旦:大规模语言模型:从理论到实践 |
|
|
|
| 浙大 AI 通识系列教材 |
|
|
|
| 清华大模型工程类书籍 |
|
|
|
| 斯坦福 CS336 / Jurafsky SLP3(SLP 第三版草稿) |
|
|
|
东大讲义的独特优势:理论严谨,公式完整,区分工程 Inference 与思维 Reasoning,对各类预训练任务、位置编码、KV 缓存优化做细致数学分析,适合 NLP 方向研究生打理论基础。 主要短板:工程实操、MoE、PEFT 参数高效微调、评测体系、多模态、Agent 智能体、课后习题、中文大模型案例是明显薄弱点。
二、下一版本(v5)建议新增 / 扩充内容
📌 模块 1:第 2 章《Generative Models 生成模型》扩充
- MoE 混合专家架构
现状:v4 只在表格列举 MoE 模型,没有原理讲解;清华教材这部分内容丰富。
-
MoE 基本原理:稀疏激活、门控网络;Switch‑Transformer;DeepSeek‑MoE; -
MoE 训练难点:负载均衡、专家 dropout;MoE 推理特点; - 参数高效微调 PEFT(新增小节)
v4 第 3 章讲软提示,但没有系统介绍 LoRA 系列,国内教材高频考点。
-
LoRA、QLoRA、AdaLoRA;冻结模型 + 低秩矩阵;量化微调; -
对比全量微调 vs LoRA vs prefix‑tuning vs soft‑prompt(衔接第三章软提示); - 模型蒸馏
大模型→小模型蒸馏;知识蒸馏、on‑policy 蒸馏已有提及,补充离线蒸馏、自蒸馏。 - 预训练数据工程扩充
参考复旦教材,补充网页语料清洗、去重、过滤、质量打分、数据混合策略、数据污染问题。v4 仅简略提到数据质量,缺少工程流程。
📌模块 2:第 4 章《Alignment 对齐》扩充
- GRPO 广义相对偏好优化
当前 v4 重点讲 RLHF、DPO;GRPO 是最新主流算法,适合推理增强,和第 6 章推理能力联动。 - 对齐的失败模式
拒绝过度对齐(over‑refusal)、位置偏见、幻觉与对齐之间的权衡;斯坦福 SLP 对此讨论较多。 - 模型编辑(Model Editing)
修改模型内部知识,修正错误事实;补充一小节。
📌模块 3:第 5、6 章 推理工程 & 推理能力 Reasoning
- 大模型完整评测体系(新增独立小节)
-
分类:能力评测(MMLU、GSM8K、HumanEval);安全性评测;中文评测基准(C‑Eval 等); -
区分自动指标、人工评测;评测中的污染问题;复旦教材优势。 - 幻觉(Hallucination)专题
幻觉成因、分类、缓解手段;斯坦福讲义重点内容,v4 几乎没有。 - 搜索增强、工具调用、智能体 Agent(扩充 3 章或 6 章)
现在工业界和科研热点,原版内容偏少。
-
当前 v4 简单提到 RAG;补充LLM Agent 循环:规划‑工具调用‑观测‑反思;ReAct、Tool‑use;
📌模块 4:新增独立小节:多模态大模型(建议放在第 2 章末尾或新增简短第 7 章)
-
多模态对齐:文本‑图像预训练;LLaVA 类架构; -
多模态提示、多模态对齐;
现有全书完全没有多模态,而国内外教材普遍覆盖该主题。
📌模块 5:教学配套内容(全书附加部分)
- 每章末尾:思考与习题
分为概念简答题、推导题、小型编程实践题;对标斯坦福 CS336 作业;当前版本没有任何习题,不利于高校开课使用。 - 案例补充:中文大模型生态
Qwen、DeepSeek、Llama 中文版本;中文预训练、中文评测;原版案例以海外模型为主。 - 可解释性(Interpretability)简介
激活、注意力可视化,因果追踪;简要介绍,参考 SLP3。
📌模块 6:现有章节内容优化(不新增大章节,做增强)
- 第 1 章预训练
增加各类预训练任务的中文研究工作引用; - 第 5 章 Inference 推理工程
补充量化(INT8 / FP8)原理,当前仅简单提到低精度,缺少原理; - 第 6 章 Reasoning 推理能力
扩充测试时计算缩放(Test‑Time Compute Scaling),包含 Best‑of‑N、自我一致性 Self‑Consistency、MCTS 蒙特卡洛树搜索推理; - 勘误与更新参考文献
更新至 2026 下半年文献。
三、两种版本迭代方案建议
方案 A(小版本迭代,v5,尽量保持原 6 章结构,不新增完整大章)
适合 arxiv 持续更新,保持讲义轻量化。
-
在现有 6 个章节内部插入新小节,不新增第七章; -
新增附录 A:PEFT、MoE、幻觉、评测、多模态简要综述; -
新增附录 B:每章习题与思考题。
方案 B(大版本迭代,v6,扩充为 7 章)
适合后续正式出书,适合高校课程教学。 1‑6 章保持现有结构; 新增第 7 章:大模型扩展主题:MoE、多模态、Agent 智能体、幻觉、评测、可解释性; 全书末尾统一附录:习题、数据集列表、常用模型清单。
四、取舍提醒(保留本书原有定位,不要过度工程化)
本书的核心特色:偏重理论原理、数学、算法推导,不是工程 cookbook。 增补的时候要把握边界:
✅ 优先补充原理层面(MoE 原理、LoRA 数学形式、幻觉成因、评测指标数学定义); ⚠️ 不要大量堆砌具体 python 代码实现(这部分交给清华、复旦工程向教材); 工程实操、代码案例放在习题 / 附录,不破坏正文理论主线。