



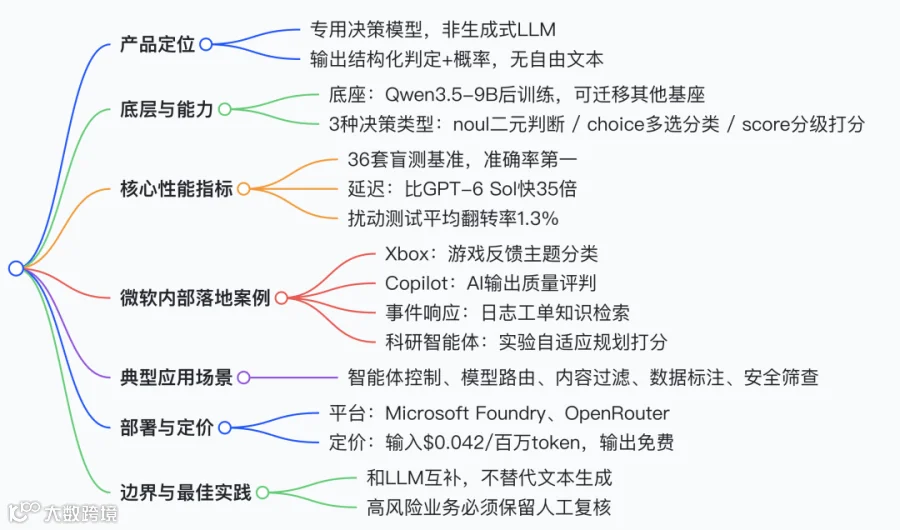
10 个关键问题 Q&A
-
Q:Microsoft-Decision-1 和普通生成式 LLM 最大区别是什么? A:LLM 生成自由文本;Decision-1 只输出结构化决策与概率,专为自动化判定、路由、打分设计,不输出推理文本。 -
Q:它支持哪几种决策任务类型? A:三类:noul 二元真假判断、choice 固定选项多选分类、score 有序量表分级打分。同一次 API 请求可合并多个决策。 -
Q:Microsoft-Decision-1 基础模型是什么? A:基于 Qwen3.5-9B 做后训练,微软后续计划迁移至 MAI、OpenAI 等其他基座。 -
Q:它的延迟性能水平如何? A:P50 延迟比 GPT-6 Sol 快 35 倍,比第二名 Quyet-1.0-Large 快 4.5 倍,适合串行多步骤智能体工作流。 -
Q:模型稳健性表现怎么样? A:对请求做 8 种扰动测试,平均决策翻转率仅 1.3%;改写选项描述、打乱选项顺序时,不会翻转判定结果。 -
Q:微软内部有哪些落地案例? A:Xbox 游戏反馈分类、Copilot 回答质量评估、运维事件检索、科研智能体实验评估与自适应规划。 -
Q:主要适用业务场景有哪些? A:智能体动作控制、模型路由、工单 / 内容分类、AI 结果评判、安全筛查、数据标注、搜索相关性打分等。 -
Q:在哪里可以调用该模型?价格如何? A:Microsoft Foundry 和 OpenRouter;输入 token 每百万 0.042 美元,输出 token 免费。 -
Q:可以完全替代 LLM 做所有 AI 任务吗? A:不能。它只做结构化判定;文本生成、摘要、创作等任务仍需要生成式 LLM,二者常搭配使用。 -
Q:使用时的风险约束是什么? A:存在偏见风险,高利害决策(人事、信贷、医疗)不能仅依靠模型,必须保留人工复核。
隆重推出 Microsoft-Decision-1:我们面向快速决策的模型
我们的全新决策评分模型在结构化决策任务上实现了延迟与质量的双重领先,性能超越主流 LLM 及其他决策模型。
作者:微软首席技术官办公室软件工程副总裁 Achint Srivastava(2026.10.09)
决策模型正在迅速崛起为 AI 领域一个重要的新品类。与旨在生成文本或推理复杂问题的 LLM 不同,决策模型是专门为产出软件可直接执行的结构化输出而设计的。而一旦你理解了这一能力 —— 以极低成本、高性能地做决策和分类 —— 就会解锁各种各样有用的任务。
今天,我们正式推出 Microsoft-Decision-1,这是我们全新的快速决策评分模型,现已在 ai.azure.com/catalog/models/Microsoft-Decision-1 以及 openrouter.ai/microsoft/microsoft-decision-1 上线。该模型专为路由、分类、优先级排序、核验与工作流控制而设计,让你能够在安全可信的环境中,把决策智能更轻松地融入现有应用、智能体和各类工作流。Microsoft-Decision-1 在结构化决策任务上实现了延迟与质量的双重领先,性能超越主流 LLM 及其他决策模型。
在覆盖近 15 万个问题的 36 项基准对比中(这些基准在训练时保持盲测),Microsoft-Decision-1 取得了最高准确率。同时在我们自己的基准测试中,它也是测速最快的:比排名第二的 Quyet-1.0-Large 快 4.5 倍,比 GPT-6 Sol 快 35 倍。
Microsoft-Decision-1 的工作原理
为了构建 Microsoft-Decision-1,我们对经过训练的 Qwen3.5-9B 进行了后训练,以实现快速、单次的决策评分,并且很快将把它重新构建到其他基础模型之上,包括微软 AI(MAI)与 OpenAI 的模型。当给定一组固定的答案选项时,Microsoft-Decision-1 会为每个选项提供校准后的概率评分。该模型支持是 / 否、多项选择和评分选项,也支持对 AI 响应和智能体行为进行基于量规(rubric)的评分,所有这些都通过一个简单的结构化 API 调用完成。
要构建一个可靠的决策模型,我们必须攻克若干挑战:
1. 速度每个决策都会增加延迟,尤其当一个步骤依赖于另一个步骤时。例如,在一连 20 个串行决策中,每个只增加 100 毫秒,就会给整个工作流额外带来 2 秒的耗时。 Microsoft-Decision-1 的 P50 延迟约为 GPT-6 Sol 的 1/35(即快约 35 倍)。
2. 能泛化的质量让模型对单个基准或单一决策任务过拟合是很容易的。我们需要知道,这种质量能否迁移到各种模型未曾见过的任务上。正因如此,我们让 Microsoft-Decision-1 在数十个保持训练盲测的基准上接受评估,覆盖路由、排序、长上下文、多语言与分布外任务、推理以及安全等方面。我们还选取了 benchmarkheaven.com/jev-models 上几款顶级公开模型,在另外 36 项公开与私有基准上进行了测试。Microsoft-Decision-1 在这些更广泛的基准集合上表现最佳,展现出了强大的泛化能力。
3. 稳健性等价的输入应产生等价的决策。在生产环境中,状态和指令会被改写、选项描述会变化、选项顺序会被重排、键会变化,还会出现无害的格式噪音。这些改变都不应显著改变决策结果。 我们对同一请求做 8 种方式的扰动,并测量决策发生翻转的频率。Microsoft-Decision-1 在平均 1.3%的扰动下会改变决策,且在改写选项描述、或反转 / 打乱选项顺序时,决策翻转率为零。
4. 概率与置信度校准概率本身就是 API 的一部分,而不仅仅是一个排序分数。应用会用置信度来决定何时执行、何时推迟、或何时请求人工复核,因此一个 90% 的预测,在代表性样本上就应该约 10 次中有 9 次正确。
5. 安全一个决策模型应当能够识别有害请求,同时避免无谓地拦截无害请求。我们在覆盖有害内容、越狱尝试与提示注入的 11 项基准、5,250 个请求上对 Microsoft-Decision-1 进行了测试,发现它能够成功拒绝有害行为,同时保持很高的可用性。
演示示例
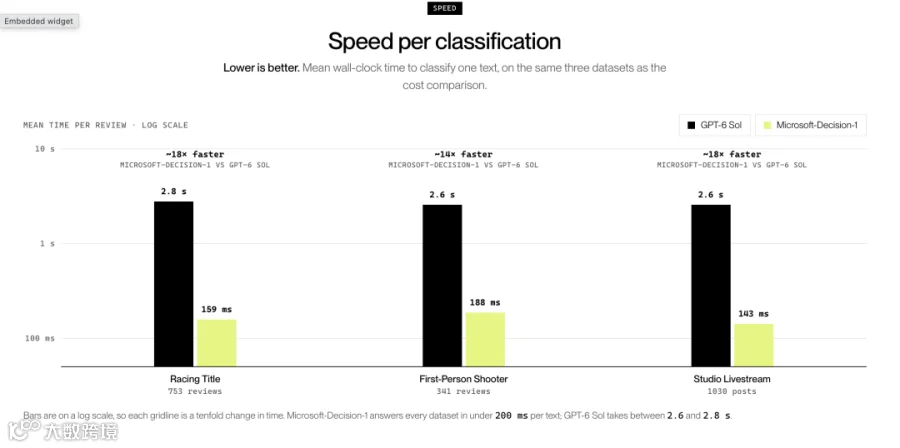
分类是决策模型的关键应用场景之一。看看 Microsoft-Decision-1 与 GPT-6 Sol 相比,能以多高的准确率和多快的速度对各类查询进行分类:
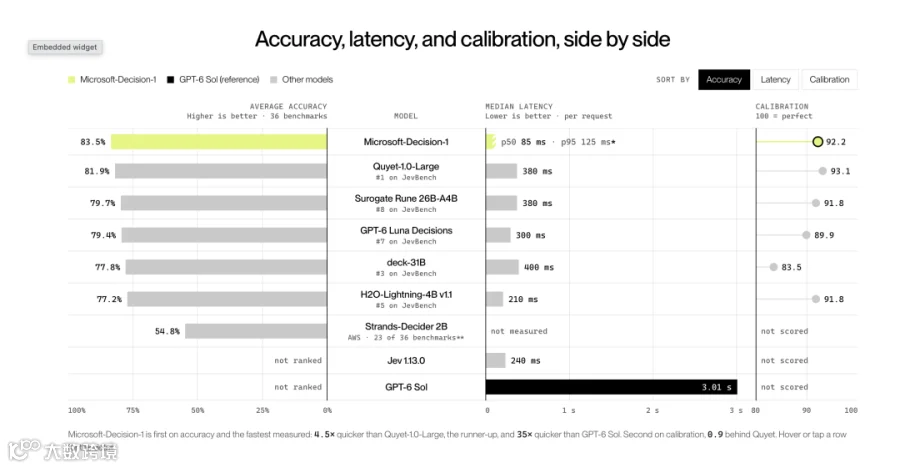
(图:分类对比演示)
决策模型在计算机使用场景中同样高效。这段演示展示了与 GPT-6 Sol 相比,Microsoft-Decision-1 完成 "购买背包" 这一任务有多快:

(图:购包任务演示)
微软内部是如何测试它的
以下是我们内部测试 Microsoft-Decision-1 的一些方式,未来还会有更多。
数据标注XBOX Research 使用 Microsoft-Decision-1 处理了来自调查问卷、STEAM 和 Twitter/X 的一万多条开放式反馈与评论,并按研究人员设定的固定主题体系将其归类,以了解人们如何看待不同的游戏、发布、直播等内容。他们发现,Microsoft-Decision-1 在质量上与 GPT-6 Sol 不相上下,而运行速度却快 14 倍以上、成本低 200 倍。
质量控制Copilot 团队会评估聊天与智能体式响应的质量。他们的测试发现,Microsoft-Decision-1 与 GPT5.6 Luna 质量相当,而速度快 100 倍。
事件响应我们的值班工程师使用 AI 从日志、工单系统、电话、消息及其他数据源中检索相关知识,以响应实时事件。在知识检索方面,Microsoft-Decision-1 比 LLM 表现得更好也更快。
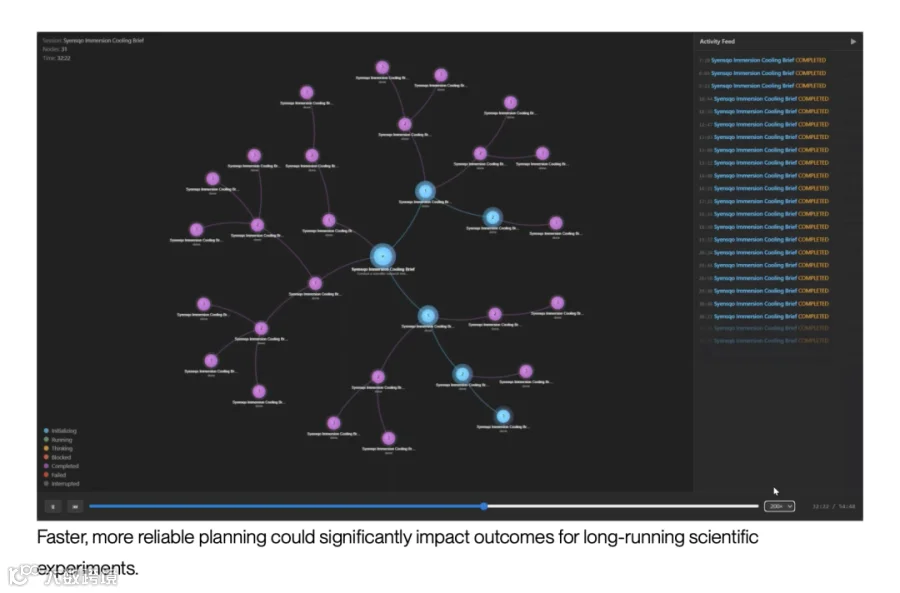
科学发现Microsoft Discovery 实现了一项自适应重新规划功能:智能体会评估上一次实验、根据量规评分修正方案,并反复迭代直至达成目标。在评分一致性上,Microsoft-Decision-1 比基于 LLM 的评分高出 46 倍,速度快 3 倍,并使自适应重新规划的速度提升近 4 倍。更快、更可靠的规划,可能对长期科学实验的成果产生重大影响。
这些只是一小部分例子。Microsoft-Decision-1 的潜在应用场景还有很多,不妨考虑以下方向:
- 智能体控制
评估智能体提出的下一步动作,决定是继续、停止、重试,还是移交给某个模型、工具或人工。 - 模型路由
评估进入的请求,并根据质量、成本与延迟要求,为该任务选择最合适的模型。 - 基于技能的决策
应用某个智能体技能中的规则来选择适当的下一步动作,而无需反复处理一长串指令。 - 数据标注
为社交媒体帖子、客户反馈等数据分配一致的标签,用于分析或训练。 - AI 评判
依据既定质量标准评估 AI 生成的响应,并决定是接受、修订还是拒绝。 - 意图分析
识别用户想要达成的目标,并将其请求匹配到支持的意图上。 - 事件响应路由
按类型与紧急程度对事件进行分类,再路由到相应的团队或工作流。 - 数据校验
检查输入是否满足既定要求,决定是接受、拒绝还是标记为待复核。 - 推荐
从一组候选项中选出最相关的条目、优惠或下一步动作。 - 搜索相关性
评估搜索结果与查询的匹配程度,并赋予相关性标签或优先级。 - 内容分类与过滤
按主题或策略对内容进行分类,决定是展示、过滤还是送审。 - 代码扫描
按既定标准评估代码,标记潜在缺陷或策略违规以进行复核。 - 安全与防护筛查
按风险对请求、输出或拟议动作进行分类,决定是允许、阻断还是升级处理。 - 计算机与界面使用
根据当前屏幕和任务,从一组选项中选出下一个界面动作。 - 机器人
根据观测、任务目标与运行约束,从预定义的机器人动作中进行选择。 - 科学发现
按既定标准筛选候选假设、化合物或实验,并确定优先级供进一步评估。



快速上手
开发者现在就可以在微软 Foundry 中使用 Microsoft-Decision-1:ai.azure.com/catalog/models/Microsoft-Decision-1。也可以通过 OpenRouter 上手:openrouter.ai/microsoft/microsoft-decision-1。
定价
输入 token 价格为每百万 token 0.042 美元,输出 token 免费。
展望
如今智能体式 AI 已成为现实,我们看到成本在人们决定如何使用 AI 时扮演着重要角色。为合适的任务选择合适的模型,也变得越来越重要。随着智能体在现实世界中采取行动、产生实际影响,决策模型有望帮助人们在复杂环境中引导和控制这些智能体。
我们期待看到开发者用 Microsoft-Decision-1 构建出的成果,也期待听到大家的反馈。我们将持续发布模型更新,包括纳入更多评估与数据,进一步优化质量、置信度与成本。
附录二:参与基准对比的模型
-
Quyet-1.0-Large — huggingface.co/chinhnc/Quyet-1.0-Large -
Surogate Rune 26B-A4B — huggingface.co/surogate/rune-26b-a4b-GGUF -
GPT-6 Luna Decisions — [developers.openai.com/api/docs/guides/decisions](https://developers.openai.com/api/docs/guides/decisions) -
deck-31B — github.com/krishna-gogineni-765/deck31b -
H2O-Lightning-4B — huggingface.co/h2oai/h2o-lightning-4b -
Strands-Decider 2B — github.com/strands-labs/strands-decider
Microsoft-Decision-1 可在 Microsoft Foundry 中用于分类、路由、排序、评分以及二元决策。你可以用它来分拣支持工单、对事件进行优先级排序、过滤内容、评估模型输出,或为请求选择合适的模型、工具或智能体。
与生成式大语言模型(LLM)不同,Microsoft-Decision-1 不会生成自由格式的响应或书面推理。它会对文本或 JSON 做出聚焦的判断,并返回类型化的数值决策。当你的应用需要可预测的响应形态、以及可用于设置阈值或排序的概率时,这种方法是很有用的。
在本文中,你将在 Microsoft Foundry 中部署 Microsoft-Decision-1、调用决策 API,并构建一个支持工单分类器。
前置条件
-
一个具有有效付款方式的 Azure 订阅。如果没有 Azure 订阅,请创建一个。 -
能够访问 Microsoft Foundry。 -
一个(Foundry)项目。 -
创建和管理模型部署的权限。Cognitive Services Contributor角色允许你部署模型。更多信息见相应文档。 -
一种身份验证方式:Microsoft Entra ID(推荐)或 API 密钥。 -
运行快速入门需要 Python 3.10 或更高版本。 -
Azure Identity 库: pip install azure-identity
选择问题类型
Microsoft-Decision-1 接受一个 state(状态)值以及一个或多个有类型的问题。state可以是文本或 JSON。请根据你的应用所需的决策来选择问题类型。其请求模式与 system-one API 类似:你的应用提供状态和有界的问题,模型返回的是决策而不是生成的叙述性文本。
|
|
|
|
|---|---|---|
|
|
noul |
|
|
|
choice |
|
|
|
score |
|
响应中的 answers对象使用你请求中的问题名称。响应中还会包含已部署的模型名称和 token 用量。
使用 Noul 做门控与过滤
对于 "是 / 否" 类条件,使用 noul问题,例如:某次工具调用是否触及生产数据、某文档是否包含提示注入、或某条支持回复是否承诺退款。
{
  "state": "I refunded your $200. You don't need to contact billing.",
  "questions": {
    "promises_refund": {
      "type": "noul",
      "instructions": "Does this reply promise the customer a refund?",
      "criteria": {
        "true": "Commits to returning money",
        "false": "Makes no commitment about money"
      }
    }
  }
}
criteria(判定标准)字段是可选的。定义 true 和 false 的条件,可以让边界模糊的问题更精确。请根据你的工作负载选择一个概率阈值,并在自动化门控之前,用带标签的样本对它进行验证。
使用 Choice 做分类与路由
使用 choice问题,从固定集合中精确选择一个标签。常见用途包括:路由工单、对意图或文档类型进行分类、选择模型或工具,以及按原因对告警进行分拣。
{
  "state": "The API returns 500 on every call.",
  "questions": {
    "team": {
      "type": "choice",
      "instructions": "Which team should handle this ticket?",
      "criteria": {
        "billing": "Charges, invoices, and refunds",
        "engineering": "Bugs, errors, and outages",
        "support": "How-to and account questions"
      }
    }
  }
}
请清晰描述每个选项。响应中包含被选中的选项,以及每个选项的概率。将较低的顶级(top)概率视为把决策升级给人工或另一个模型的信号。
使用 Score 做排序与评分
使用 score问题,将某个条目放置到有序量表上。常见用途包括:对队列进行优先级排序、为模型输出打分,以及度量严重性、有用性或挫败感等属性。
{
  "state": "Checkout is down for all EU customers since 09:00.",
  "questions": {
    "severity": {
      "type": "score",
      "instructions": "How severe is this incident?",
      "criteria": [
        "Cosmetic",
        "Minor",
        "Major",
        "Critical"
      ]
    }
  }
}
请按从低到高的顺序列出各个层级。返回的分数是层级索引的概率加权平均值。例如,一个四级量表取值从 0 到 3,结果可能落在两个层级之间。请在你自己的带标签样本上验证分数。更建议将分数用于相对排序和阈值设定,而不是作为绝对、经过校准的评级。
Microsoft-Decision-1 一览
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
为尽量降低应用与 Foundry 之间的网络延迟,请在靠近你的应用和用户所在的区域创建 Foundry 资源,并调用该资源的端点。对于对局部性敏感的工作负载,当可用的 DataZoneStandard 部署类型位于离你的应用最近的数据区时,可优先使用它。这种部署类型会将推理处理保持在数据区内部,从而减少远距离路由。请对你的工作负载进行基准测试,因为某种部署类型并不能保证更低的延迟。
同时支持 GlobalStandard,它可提供对全球算力的访问。由于推理可能在任何一个受支持的 Azure 区域进行处理,因此延迟可能更高或更不稳定。更多信息见相应文档。
部署 Microsoft-Decision-1
在 Foundry 模型目录中部署该模型。
-
打开 ai.azure.com,并进入你的项目。 -
选择 Model catalog(模型目录)。 -
搜索并选择 Microsoft-Decision-1。 -
选择 Deploy(部署),配置部署,然后选择 Deploy。 -
在部署详情页上,复制资源端点、部署名称和 API 密钥。
关于门户工作流的更多信息,见相应文档。
或者,也可以使用 Azure CLI 部署模型。请将 <ACCOUNT_NAME>、<RESOURCE_GROUP>和 <DEPLOYMENT_NAME>替换为你的实际值。
az cognitiveservices account deployment create \
  --name <ACCOUNT_NAME> \
  --resource-group <RESOURCE_GROUP> \
  --deployment-name <DEPLOYMENT_NAME> \
  --model-name "Microsoft-Decision-1" \
  --model-format Microsoft \
  --model-version "1" \
  --sku-name GlobalStandard \
  --sku-capacity 1
该示例使用 GlobalStandard。如果 DataZoneStandard部署类型在你的区域可用,且你希望将推理处理保持在离你的应用最近的数据区内,可把 --sku-name改为 DataZoneStandard。
列出你的资源上所有可用的部署:
az cognitiveservices account deployment list \
  --resource-group <RESOURCE_GROUP> \
  --name <ACCOUNT_NAME> \
  --output table
调用决策 API
向你的 Foundry 资源上 Microsoft provider 的决策端点发送请求:
<your-foundry-resource-endpoint>/providers/microsoft/v1/systemone
请求中的 model值是你的部署名称,而不是底层模型名称。例如,一个名为 pi-decision-1的部署应使用 "model": "pi-decision-1"。响应中的 model字段标识的是底层模型,因此它可能包含不同的值,例如 microsoft-decision-1。
设置你从部署详情页复制的值:
export AZURE_ENDPOINT="<your-foundry-resource-endpoint>"
export DEPLOYMENT_NAME="<your-deployment-name>"
若要使用 Microsoft Entra ID 身份验证,请先使用 Azure CLI 登录并获取访问令牌:
az login
export AZURE_ENTRA_TOKEN=$(az account get-access-token \
  --resource https://cognitiveservices.azure.com \
  --query accessToken \
  --output tsv)
使用 Microsoft Entra ID 调用端点:
curl "$AZURE_ENDPOINT/providers/microsoft/v1/systemone" \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $AZURE_ENTRA_TOKEN" \
  -d '{
    "model": "'"$DEPLOYMENT_NAME"'",
    "state": "The API returns 500 on every call.",
    "questions": {
      "team": {
        "type": "choice",
        "instructions": "Which team should handle this ticket?",
        "criteria": {
          "billing": "Charges, invoices, and refunds",
          "engineering": "Bugs, errors, and outages",
          "support": "How-to and account questions"
        }
      }
    }
  }'
若要改用 API 密钥,请把 Authorization请求头替换为:
export AZURE_API_KEY="<your-api-key>"
-H "api-key: $AZURE_API_KEY"
关于身份验证的更多信息,见相应文档。
对支持工单进行分类
本快速入门使用 choice问题,将客户支持请求路由到账单、技术支持或账户团队。它还会在一小组带标签的样本上测量准确率和请求中位延迟。
-
创建一个名为 support_ticket_classifier.py的文件。 -
添加以下代码:
import json
import os
import urllib.error
import urllib.request
from collections.abc import Mapping
from statistics import median
from time import perf_counter
from typing import Any

from azure.identity import DefaultAzureCredential


OPTIONS = {
    "billing": "Charges, invoices, refunds, or subscription payments",
    "technical": "Software errors, bugs, or integration failures",
    "account": "Sign-in, password, or account-access problems",
}

EXAMPLES = [
    ("I was charged twice.", "billing"),
    ("The integration crashes during checkout.", "technical"),
    ("I cannot sign in after resetting my password.", "account"),
]

AZURE_ENDPOINT = os.environ["AZURE_ENDPOINT"].rstrip("/")
DEPLOYMENT_NAME = os.environ["DEPLOYMENT_NAME"]
TIMEOUT_SECONDS = 60
TOKEN_SCOPE = "https://cognitiveservices.azure.com/.default"
CREDENTIAL = DefaultAzureCredential()


class DecisionAPIError(RuntimeError):
    """Raised when the API can't return a valid classification."""


def read_choice(
    payload: Any,
    options: Mapping[str, str],
) -> str:
    if not isinstance(payload, dict):
        raise DecisionAPIError("The API returned an invalid response.")

    answers = payload.get("answers")
    if not isinstance(answers, dict):
        raise DecisionAPIError("The API returned no answers object.")

    answer = answers.get("team")
    if not isinstance(answer, dict) or answer.get("type") != "choice":
        raise DecisionAPIError("The API returned an invalid answer.")

    choice = answer.get("choice")
    if not isinstance(choice, str) or choice not in options:
        raise DecisionAPIError(
            f"The API selected an unsupported team: {choice!r}."
        )
    return choice


def predict(
    text: str,
    options: Mapping[str, str],
) -> str:
    if not text.strip():
        raise ValueError("text must not be empty.")
    if len(options) < 2:
        raise ValueError("options must contain at least two choices.")

    body = json.dumps(
        {
            "model": DEPLOYMENT_NAME,
            "state": text,
            "questions": {
                "team": {
                    "type": "choice",
                    "instructions": (
                        "Which team should handle this customer support "
                        "request? Select exactly one team based on the "
                        "primary problem."
                    ),
                    "criteria": dict(options),
                }
            },
        }
    ).encode("utf-8")

    access_token = CREDENTIAL.get_token(TOKEN_SCOPE).token

    request = urllib.request.Request(
        f"{AZURE_ENDPOINT}/providers/microsoft/v1/systemone",
        data=body,
        headers={
            "Authorization": f"Bearer {access_token}",
            "Content-Type": "application/json",
            "Accept": "application/json",
        },
        method="POST",
    )

    try:
        with urllib.request.urlopen(
            request,
            timeout=TIMEOUT_SECONDS,
        ) as response:
            response_body = response.read()
    except urllib.error.HTTPError as exc:
        raise DecisionAPIError(
            f"The API returned HTTP {exc.code}."
        ) from exc
    except urllib.error.URLError as exc:
        raise DecisionAPIError(
            f"Couldn't reach the API: {exc.reason}."
        ) from exc

    try:
        payload = json.loads(response_body)
    except (json.JSONDecodeError, UnicodeDecodeError) as exc:
        raise DecisionAPIError(
            "The API returned invalid JSON."
        ) from exc

    return read_choice(payload, options)


def main() -> None:
    correct = 0
    latencies_ms = []

    for text, expected in EXAMPLES:
        start = perf_counter()
        predicted = predict(text, OPTIONS)
        elapsed_ms = (perf_counter() - start) * 1000

        correct += int(predicted == expected)
        latencies_ms.append(elapsed_ms)
        print(
            f"Expected={expected}, predicted={predicted}, "
            f"latency={elapsed_ms:.1f} ms"
        )

    accuracy = correct / len(EXAMPLES)
    print(f"Accuracy: {accuracy:.1%}")
    print(
        "Median request latency: "
        f"{median(latencies_ms):.1f} ms"
    )


if __name__ == "__main__":
    main()
-
按照 "调用决策 API" 一节设置环境变量。 -
运行示例:
该脚本会打印每个请求的预期团队和预测团队,然后打印样本集的准确率和中位延迟。在你使用这些测量结果来做出部署决策之前,请将python support_ticket_classifier.pyEXAMPLES替换为你工作负载中具有代表性的、带标签的样本。
在一次请求中组合多个决策
使用相同 state的问题可以共享一次请求。例如,用 choice路由工单、用 score评定其严重性,并用 noul检查它是否是重复联系。
{
  "model": "<deployment-name>",
  "state": {
    "message": "Checkout is down again. This is my third request.",
    "customer_contact_count": 3
  },
  "questions": {
    "team": {
      "type": "choice",
      "instructions": "Which team should handle this request?",
      "criteria": {
        "billing": "Charges, invoices, and refunds",
        "engineering": "Bugs, errors, and outages",
        "support": "How-to and account questions"
      }
    },
    "severity": {
      "type": "score",
      "instructions": "How severe is this issue?",
      "criteria": ["Cosmetic", "Minor", "Major", "Critical"]
    },
    "repeat_contact": {
      "type": "noul",
      "instructions": "Has the customer contacted support before?"
    }
  }
}
组合相关问题可以减少请求数量,并保持决策上下文的一致性。
解读决策
Microsoft-Decision-1 返回数值决策,而不附带书面推理。请利用这些概率来决定:你的应用是自动执行、请求另一次评估,还是将该条目发送给人工处理。
何时使用 Microsoft-Decision-1
当你的应用需要对同一输入做一项或多项有界、有类型的决策时,使用 Microsoft-Decision-1。它非常适合高吞吐量的工作流 —— 在这些场景中,你的应用需要基于某个概率、选中的选项或有序分数来采取行动,而不是展示生成的文本。
常见用例包括:
- 门控与过滤
在工作流继续之前,检查内容是否满足某个条件。 - 分类与路由
将工单、告警、文档或请求发送到已知集合中的某一个选项。 - 排序与优先级排序
按应用定义的量表,对事件、线索、搜索结果或审阅队列进行排序。 - 评估与评分
依据有序的量规为模型输出打分。 - 模型、工具或智能体选择
选择应由哪个组件来处理某个请求。
当应用需要创建、总结、改写或解释内容时,请改用生成式 LLM。你也可以将两者结合使用:用 Microsoft-Decision-1 来路由或门控请求,再把获准的请求发送给生成式模型。
已知局限与风险
- 公平性
模型可能反映其基础模型和训练数据中存在的偏见。不要将其分数作为对个人做出决策的唯一依据。 - 措辞敏感性
分数可能会因你如何表述问题、以及问题的顺序和选项的顺序而改变。措辞不佳的问题仍会返回分数。 - 可靠性
校准在模型熟悉的任务类型上最强。模型不提供解释,可能依赖过时的知识。 - 有害内容
当你把模型用作安全过滤器时,它可能漏掉微妙的有害内容,或把良性内容误判为有害。
最佳实践
-
在把 Microsoft-Decision-1 用于应用之前,先在你要用的场景上对模型进行评估。 -
在与你的用例具有代表性的数据上验证模型。 -
为每种原语(primitive)调优 state、instructions和选项。你可以通过结构化的、带代码增强的状态以及参数化选项来改进任务定义。使用编码智能体生成候选配置,在带标签的样本上评估它们,并比较结果。在将智能体生成的改动用于生产之前,请先进行审查。 -
根据误报和漏报的成本来设置置信度阈值。当模型不应被迫做出选择时,应加入一个弃权选项,例如 cannot tell(无法判断)。 -
为问题和选项使用清晰、中性的措辞。考虑对选项顺序做随机化,并测试改变顺序是否会影响结果。 -
对于涉及个人的重大决策,例如涉及信贷、就业、住房、医疗或法律事务的决策,请将模型用于决策支持,并辅以有意义的人工复核。不要把它当作唯一的决策者。 -
避免使用与用例无关的敏感属性。持续监控结果,看是否存在错误和不公平的差异。 -
当 AI 参与某项决策时,告知受影响的用户。
故障排查
|
|
|
|
|---|---|---|
|
|
|
state、questions、type和 criteria。
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
model值和每个问题定义。
|
|
|
|
|
相关内容
-
在 Foundry 中部署模型 -
配置 Entra ID -
由 Azure 直接销售的模型及其区域可用性