


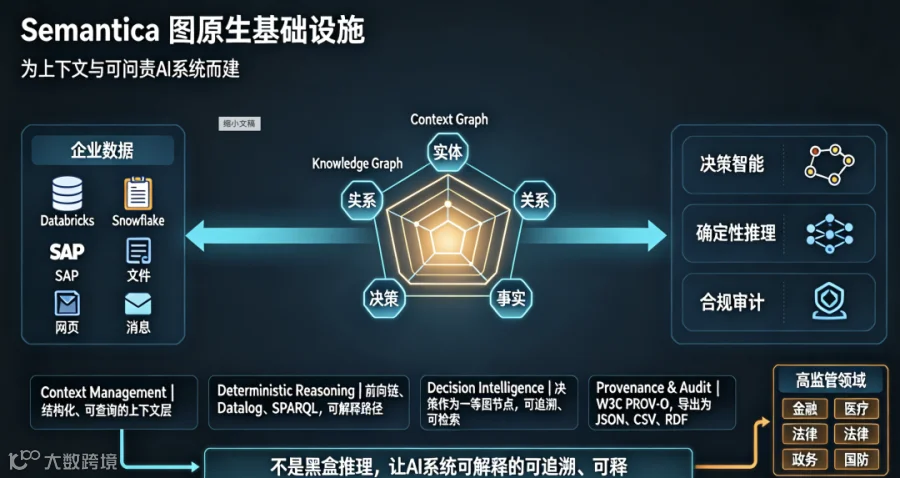
编者摘要:Semantica 是一款 MIT 开源、图原生 AI 上下文基础设施,面向高监管企业场景,作为 LLM 与 Agent 下层语义层,弥补传统 RAG 仅依靠向量相似度检索的短板。它不替换现有大模型、向量库与 Agent 框架,而是构建Context Graph 上下文图,将多源企业文档、数仓数据抽取为实体、关系、事实与 AI 决策节点。内置本体管理(OWL/SHACL)、Rete/Datalog 确定性推理、W3C PROV-O 全链路溯源,支持冲突检测、实体消重、双时态图快照,实现决策因果链追踪与监管级审计导出。
平台支持多存储异构适配,兼容 Neo4j、RDF 三元库与各类向量数据库,无厂商锁定;原生对接 Databricks、Snowflake、SAP 企业数据源,集成 LangChain、CrewAI、Agno 与 MCP 协议,提供 CLI、REST API、交互式知识可视化工作台。核心定位是系统级可解释:不解析 LLM 内部逻辑,完整留存输入上下文、证据来源、决策链路。适合金融、医疗、政务等高风险 AI 决策场景,帮助 AI 平台、数据与合规团队构建可审计、可追溯的智能 Agent 系统。

10 个关键问题 Q&A
项目定位:面向可问责 AI 的图原生基础设施,开源、MIT 协议,替代昂贵企业级知识图谱平台;作为 LLM/Agent 框架下层的语义与上下文层,主打确定性推理、决策溯源、合规审计。 GitHub:https://github.com/semantica-agi/semantica | PyPI:pip install semantica
一、痛点(它解决什么问题)
传统 RAG/Agent 几乎依赖 Embedding 向量检索:
-
只有相似度打分,没有实体关系、业务语义结构 -
AI 决策是瞬时日志,无法回答「AI 为什么做出这个判断」,缺少审计链路 -
多源数据冲突会静默覆盖,没有冲突检测 -
向量库只做相似召回,无法做因果推理、规则校验、历史回溯
Semantica 不替换你的 LLM、向量库、Agent 框架(LangChain/CrewAI/Agno),而是在上面叠加一层结构化上下文图(Context Graph)+ 知识图谱 KG,把碎片化企业数据变成带溯源、规则、因果链路的可查询图。
重要边界说明:系统级可解释,不是大模型内部可解释它不去解析 LLM 内部黑盒;而是记录输入给大模型的上下文、证据来源、决策结果、执行链路、业务规则。审计人员看到的是外部完整证据链,不是模型内部神经元逻辑。
二、主要概念
1. Context Graph(上下文图)
区别传统知识图谱 KG:KG 侧重静态实体;Context Graph 把【实体、关系、事实、AI 决策、证据】全部作为一等公民节点。
-
实体关联原始文档来源 -
决策节点和证据、上下游因果链路绑定 -
支持双时态(bi-temporal)快照:任意时间点回溯图状态(Time Travel) -
冲突检测:多源矛盾事实标记,不会静默覆盖
2. Decision Intelligence 决策智能(项目王牌能力)
AI 决策不再是一行日志,而是图上可持久化、可查询、可审计的节点:
record_decision()记录每一次 AI 决策,保存场景、推理文本、结果、置信度、元数据 add_causal_relationship()建立因果关系: CAUSED / INFLUENCED / PRECEDENT_FORtrace_decision_chain()追溯完整因果祖先链,找到根因 find_similar_decisions()检索历史同类先例 analyze_decision_impact()分析该决策下游影响范围 check_decision_rules()SHACL 规则校验,做合规拦截 -
导出标准 W3C PROV-O 溯源规范,满足监管报送(金融、医疗、政务、法律等高管制领域)
3. 本体 Ontology 与确定性推理
-
支持 OWL、SHACL、SKOS,可视化本体编辑器,定义业务词汇、实体定义、约束规则 -
推理引擎:Rete 正向链、Datalog、SPARQL,确定性推理,不依赖 LLM 做推理 / 建图 / 溯源(LLM 可选,仅用于抽取等辅助环节) -
冲突检测、实体消重、语义合并,处理多源脏数据
三、整体架构(端到端流水线)
数据源 → 摄入 → 解析 → 归一化 → 分块 → 抽取 → 冲突检测 → 实体去重 → 知识图谱 →【本体 · 推理 · 溯源 · 决策层】→ 增强KG → 多模图存储+向量库 → 导出/可视化 / REST / MCP / CLI
- Ingest 多源数据摄入
文件、网页、数据库、Databricks/Snowflake/SAP、Kafka 流、Git、邮件、MCP - Split 图原生分块
实体感知、关系感知的 GraphRAG 分块,不是简单固定长度切片 - Semantic Extract
:NER、关系抽取、事件抽取、三元组提取 - KG 构建
GraphBuilder,图分析(中心性、社区发现、链接预测)、双时态事实 - 智能层
本体管理、确定性推理、W3C PROV 溯源、决策记录 - Polyglot 多存储(可插拔,代码无需改动)
-
LPG 属性图:Neo4j、FalkorDB、Apache AGE、AWS Neptune -
RDF 三元库:内置 Oxigraph、Blazegraph、Jena、RDF4J -
向量库:FAISS、PgVector、Qdrant、Weaviate、Milvus、Pinecone 等 -
对外接口:REST API、MCP Server、CLI、交互式可视化工作台 Knowledge Explorer
四、模块清单
表格
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
五、与传统向量 RAG / LLM 记忆对比
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
六、适用用户人群
-
AI 平台团队:开发高风险决策 Agent,需要结构化上下文而非单纯向量索引 -
企业数据团队(Databricks/Snowflake/SAP):直接把数仓表转为带血缘 KG,不用导出到第三方 SaaS -
合规风控审计团队:监管可接受格式的 AI 决策理由与审计轨迹 -
强监管行业:金融、医疗、法律、政务、国防(不希望数据托管给外部 SaaS) -
平台 / 基础设施工程师:自托管 KG、推理、溯源栈,无厂商锁定 -
知识工程师:多源脏数据构建 KG,冲突检测与实体合并
七、集成生态
Agent 框架
LangChain、CrewAI、Agno;原生 MCP 服务器(支持 Claude Desktop、Windsurf、Cline、VS Code MCP 客户端)
LLM
统一抽象层semantica.llms,兼容 OpenAI、Anthropic、Gemini、Ollama、DeepSeek、Azure OpenAI、Bedrock 等,底层封装 LiteLLM
IDE 插件
Claude Code、Cursor、Windsurf、Cline、Continue、VSCode 插件
导出格式
RDF、OWL、Parquet、Cypher、JSON-LD、CSV
八、快速上手极简代码示例
# pip install semantica
from semantica.context import ContextGraph

graph = ContextGraph(advanced_analytics=True)

# 记录AI决策,生成可审计节点
decision_id = graph.record_decision(
    category="vendor_selection",
    scenario="Choose cloud provider for HIPAA workload",
    reasoning="AWS offers BAA, mature HIPAA tooling, and existing team expertise",
    outcome="selected_aws",
    confidence=0.93,
)

# 追溯完整因果链
chain = graph.trace_decision_chain(decision_id)
# 检索相似历史决策
similar = graph.find_similar_decisions("cloud vendor", max_results=5)
# 规则合规校验
compliant = graph.check_decision_rules({"category": "vendor_selection"})
九、版本与部署要点
-
当前版本 v0.6.8:支持 SLSA+Sigstore 签名构建,安全加固,新增向量库迁移能力、ErasureCoordinator 数据擦除能力 -
安装方式:轻量核心包 / 可选 extras 分模块安装(文档、本地 Embedding、Neo4j、Databricks 等), semantica[all]完整包 -
生产推荐 Docker/K8s 部署;官方提供 AWS/GCP/Azure/K8s/Helm 部署模板;GitHub Action CI 模板开箱即用 -
可视化工作台: semantica[explorer],浏览器交互式图、本体、时间线、决策因果链查看
十、优势与局限
✅ 优势
- 无厂商锁定,polyglot 多存储
图数据库 / 三元库 / 向量库可随意替换,业务代码不变 -
完全自托管,数据不出本地,适合强监管行业 -
推理、KG 构建、溯源不需要 LLM,LLM 仅作为可选抽取增强组件,确定性高 -
决策作为一等图节点,天然支持审计、先例检索、因果影响分析 -
原生对接企业湖仓(Databricks、Snowflake),不用导出数据做 KG -
MCP、REST、CLI 多入口,可嵌入 Agent、IDE、业务系统
⚠️ 局限
-
知识图谱构建、本体建模有工程门槛,相比开箱即用 RAG 复杂度更高 -
大规模图(百万级以上节点)需要调优存储与硬件资源 -
本体、SHACL 规则编写需要具备知识工程能力 -
项目相对年轻,生态和生产案例还在积累
十一、总结
Semantica 是开源图原生企业知识基础设施,在现有 LLM+Agent 栈之下搭建带完整溯源与确定性规则推理的 Context Graph,专门解决企业 AI 的可解释、审计、合规、多源冲突问题,适合高风险决策类 Agent 场景,替代商业 KG SaaS 平台。