

智猩猩AI整理
编辑:林夕
扩散模型的生成质量还在提升,但如何让模型更快学会生成高质量图像,依然是一个值得研究的问题。
近日,清华大学唐杰等人提出了一种名为 CARE 的新方法,试图从模型内部的特征表示入手,同时改善生成质量与训练效率。
论文《CARE: Condition-Aware Representation Regularization for Diffusion Models》于9月23日发布在 arXiv 上。
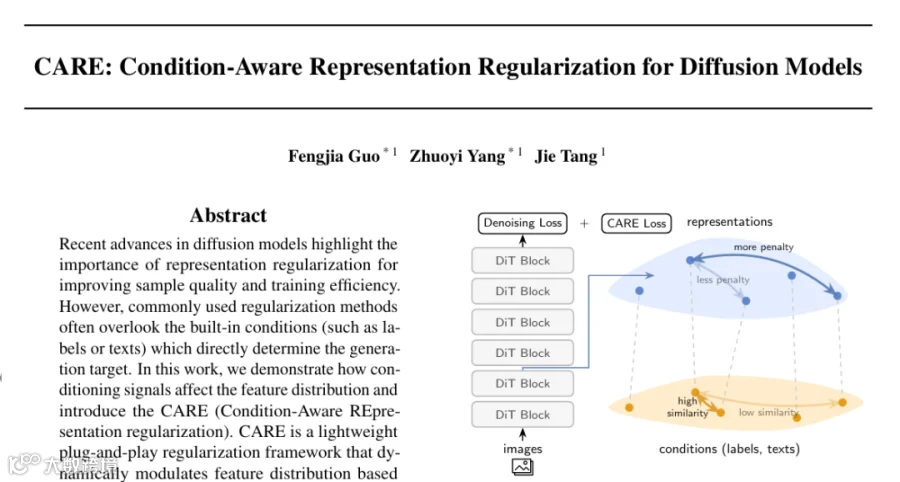
研究团队提出了一种面向条件信息的表示正则化方法,能够利用图像生成任务中已有的类别标签或文本提示词,调整模型内部特征的组织方式。
在 ImageNet 图像生成实验中,CARE 将模型的 FID 指标降低了19.08%,并报告了3.5倍的训练加速效果。
在文本生成图像任务中,该方法也将 FID 降低了16.61%,同时改善了生成图像与文本提示之间的语义对应关系。
01
扩散模型的特征学习,
还能利用条件信息
近年来,扩散模型与流匹配模型不断提升图像生成能力,研究者也开始关注模型内部的特征表示,希望通过改善特征学习过程,让模型更快收敛,并生成质量更好的图像。
此前,REPA 等方法已经证明,对扩散模型的中间层特征进行正则化,可以帮助提升训练效率与生成质量。
REPA 通过对齐扩散模型与预训练视觉编码器的特征,引导模型学习更有效的视觉表示;Dispersive Loss 则从特征分散的角度出发,改善特征空间的分布。
CARE 关注的是另一个问题:现有方法通常没有充分利用生成任务自身携带的条件信息。
对于类别条件生成,模型需要根据“猫”“汽车”等类别标签生成对应图像。
对于文本生成图像,模型则需要理解提示词中的对象、属性与语义关系。
这些条件直接决定了模型的生成目标,也反映了不同样本之间的语义联系。
如果模型只考虑特征本身的分布,却忽略条件之间的差异,那么学到的特征结构就可能与生成任务的语义结构不够一致。
CARE 希望将这部分信息纳入特征正则化过程,让模型在学习如何生成图像的同时,也更好地组织内部特征。

02
CARE 如何利用条件信息调整特征?
CARE 是一种可插拔的辅助训练目标,不需要额外引入预训练视觉编码器,也不需要改变原有的扩散生成过程。
它的基本思路是:先衡量生成条件之间的相似程度,再据此调整特征正则化的强度。
在类别条件生成中,条件是离散的类别标签。
如果两个样本属于同一类别,CARE 就减弱它们之间的排斥正则化;如果类别不同,则保留相对更强的排斥作用。
在文本生成图像任务中,条件通常由文本编码器转换为连续的特征向量。
研究团队尝试了两种相似度计算方式:一种是将余弦相似度线性缩放到0至1之间,另一种是使用 Softmax 对批次内的相似度进行归一化。
在此基础上,CARE 使用高斯核衡量模型中间特征之间的关系,并根据条件相似度动态调节特征排斥的强弱。
需要注意的是,CARE 并非简单地把相似样本强行聚集在一起。
它仍然对特征坍缩施加惩罚,只是降低语义相似条件对应样本之间的排斥强度,让特征空间在保持区分能力的同时,更好地反映条件结构。
从训练目标来看,原有的 Flow Matching 损失继续负责学习生成过程,CARE 则通过额外的正则化损失约束中间特征。两者共同构成最终训练目标。
这种设计不需要额外增加模型参数,也不依赖外部视觉模型提供监督信号。对于已经采用扩散模型训练框架的研究者来说,它提供了一种相对直接的改进路径。
03
ImageNet实验:FID降低19.08%
研究团队首先在 ImageNet 256×256 类别条件图像生成任务上验证 CARE,采用 SiT 系列模型进行实验。
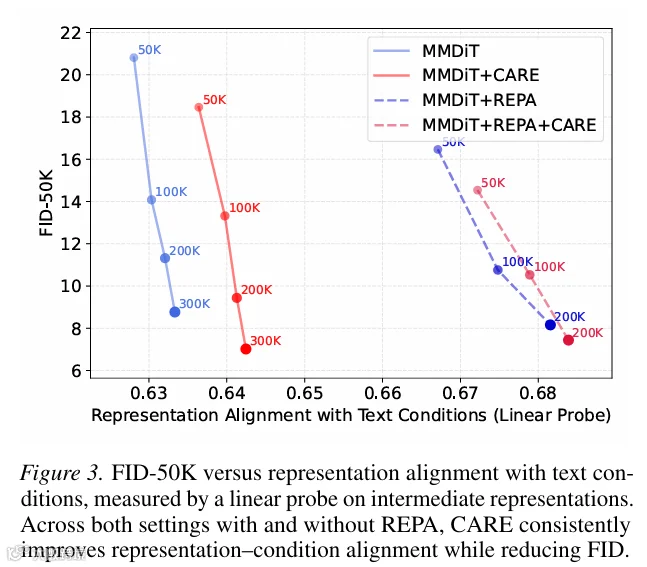
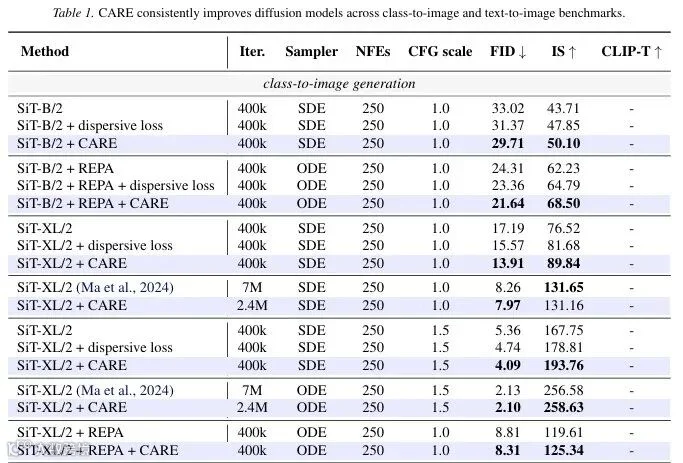
在 SiT-XL/2 上,训练400k步后,基线模型的 FID 为17.19,加入 CARE 后降至13.91,相对降低19.08%。
如果启用分类器自由引导(CFG),改善幅度进一步扩大:基线模型的 FID 从5.36降至4.09,相对降低23.69%。
FID 是图像生成领域常用的评估指标,用于衡量生成图像与真实图像在特征分布上的差异,通常数值越低越好。
训练效率方面,论文摘要报告了3.5倍的训练加速。正文还给出了另一组长程训练对比:
CARE 模型训练240万步后,FID 达到7.97;基线模型训练700万步后,FID 为8.26。
CARE 模型使用更少的训练步数,就取得了优于该基线结果的 FID。
CARE 的实验还覆盖了文本生成图像任务。
研究团队使用24层 MMDiT 模型,在一个包含约59.5万张图像及对应文本描述的数据子集上开展实验。
文本条件由 CLIP-L 文本编码器生成,CARE 被应用于 MMDiT 的第8层。
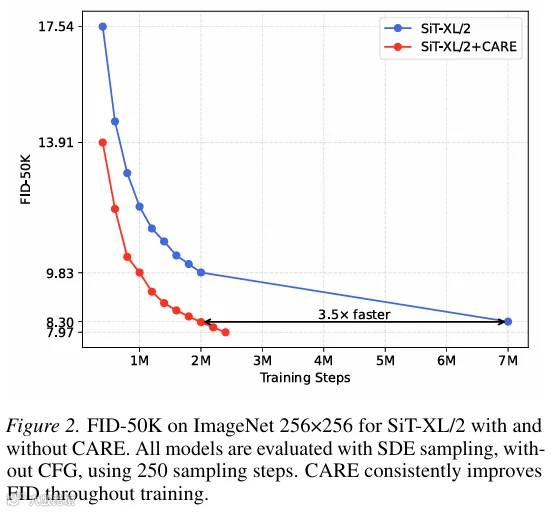
训练200k步时,基线模型的 FID 为11.32,加入 CARE 后降至9.44,相对降低16.61%。
训练进行到300k步时,基线模型的 FID 为8.77,CARE 模型则达到7.02,相对降低19.95%。
文本 CLIP 分数也有所改善。200k步时,基线模型的分数为18.25,CARE 模型为18.54;300k步时,两者分别为18.92和19.16。
04
与REPA结合,
生成质量还能继续提升
除单独使用外,CARE 还可以与已有的特征正则化方法结合。
研究团队将 CARE 与 REPA 组合后发现,在 SiT-B/2 上,REPA 单独使用时的 FID 为24.31;加入 CARE 后,FID 进一步降至21.64,相对改善10.98%。

在 SiT-XL/2 上,REPA 的 FID 为8.81,与 CARE 结合后降至8.31。

文本生成图像任务中也观察到了类似结果。
在200k步的实验中,MMDiT 与 REPA 结合后的 FID 为8.16,进一步加入 CARE 后降至7.44;文本 CLIP 分数则从19.25升至19.66。
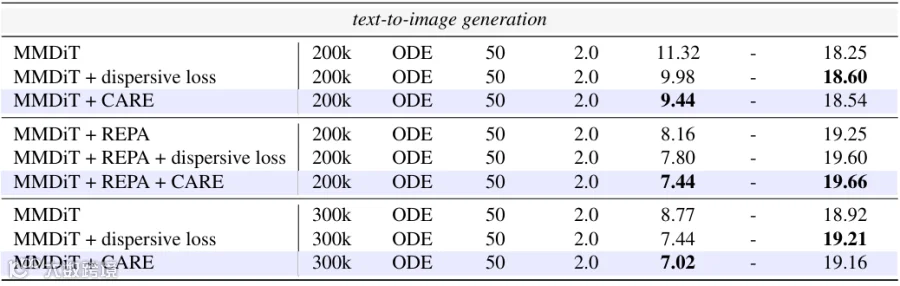
这些结果说明,CARE 与 REPA 的作用具有互补性。
REPA 借助预训练视觉模型提供特征对齐信号,CARE 则利用生成任务自身的条件信息调节特征分布。
然而CARE 目前的主要实验集中在类别条件和文本条件的图像生成任务上。
对于视频、音频、3D内容生成,以及更复杂的多模态条件,能否取得类似收益,仍有待进一步验证。
总体来看,CARE 提供了一种新的扩散模型训练思路:
在优化生成过程之外,利用任务自身已有的条件信息,改善模型内部特征的组织方式。
从 ImageNet 到文本生成图像,论文报告了 FID 的明显改善;与 REPA 结合后,生成效果还得到进一步提升。
对于希望改善扩散模型训练效率、同时减少额外模型依赖的研究者而言,这项工作提供了一个值得继续探索的方向。
END
关注+星标,获取AI前沿进展与开源一线动态