


Synthesis AI,一家开发用于生成合成数据以训练AI系统的平台初创公司,今日宣布已完成由468 Capital领投、Sorenson Ventures和Strawberry Creek Ventures、Bee Partners、PJC、iRobot Ventures、Boom Capital以及Kubera Venture Capital参投的A轮融资,融资金额为1700万美元。首席执行官兼创始人Yashar Behzadi表示,这笔资金将用于产品研发、扩大公司团队以及拓展研究——特别是在混合真实数据与合成数据领域。
合成数据是指通过人工创建而非从现实世界采集的数据。随着对AI系统需求的不断增长,合成数据在数据科学领域的应用日益广泛。其优势显而易见:虽然收集真实世界数据来开发AI系统成本高昂且劳动密集,但理论上可以生成无限量的合成数据以满足任何标准。例如,开发人员可以使用合成汽车及其他车辆的图像来开发能够区分不同品牌和型号的AI系统。
毫不意外地,Gartner 预测到2024年,用于开发和数据分析项目的人工智能数据中将有60%为合成数据。一项调查将合成数据的使用称为“[人工智能]领域正在兴起的最有前景的通用技术之一”。
但合成数据也存在局限性。尽管它可以模仿真实数据的许多特性,但它并非完全复制品。而且,合成数据的质量取决于生成它的算法的质量。
当然,Behzadi声称Synthesis已经采取了有意义的步骤来克服这些技术障碍。作为前IT政府服务公司SAIC的科学家以及内置E Ink显示屏智能手机壳PopSlate的创作者,Behzadi于2019年创立了Synthesis in AI,旨在——用他自己的话说——“解决AI中的数据问题,并转变计算机视觉范式。”
“随着公司开发新硬件、新模型或扩展其地理和客户基础,需要新的训练数据以确保模型表现良好,”Behzadi通过电子邮件告诉TechCrunch。“公司在与人相关的产品中还面临着与模型偏见和消费者隐私相关的伦理问题。很明显,构建下一代计算机视觉需要一种新的范式。”
在大多数AI系统中,标签——可以以标题或注释的形式出现——在开发过程中用于“教”系统识别特定对象。团队通常必须 painstakingly( painstakingly 应译为“ painstakingly ”,但中文语境下可简化为“ painstakingly ”)为真实世界的图像添加标签,而像Synthesis这样的合成工具理论上消除了这种需求。
Synthesis 的基于云的平台允许公司结合人工智能、程序化生成和视觉特效渲染技术,生成带有标签的合成图像数据。例如,对于正在开发算法以应对识别面部和监控驾驶员等挑战的客户,Synthesis 生成了大约 100,000 名涵盖不同性别、年龄、BMI、肤色和种族的“合成人物”。通过该平台,数据科学家可以自定义虚拟人物的姿势,以及他们的发型、胡须、服装(如口罩和眼镜),甚至环境方面,如光照和虚拟摄像机的“镜头类型”。
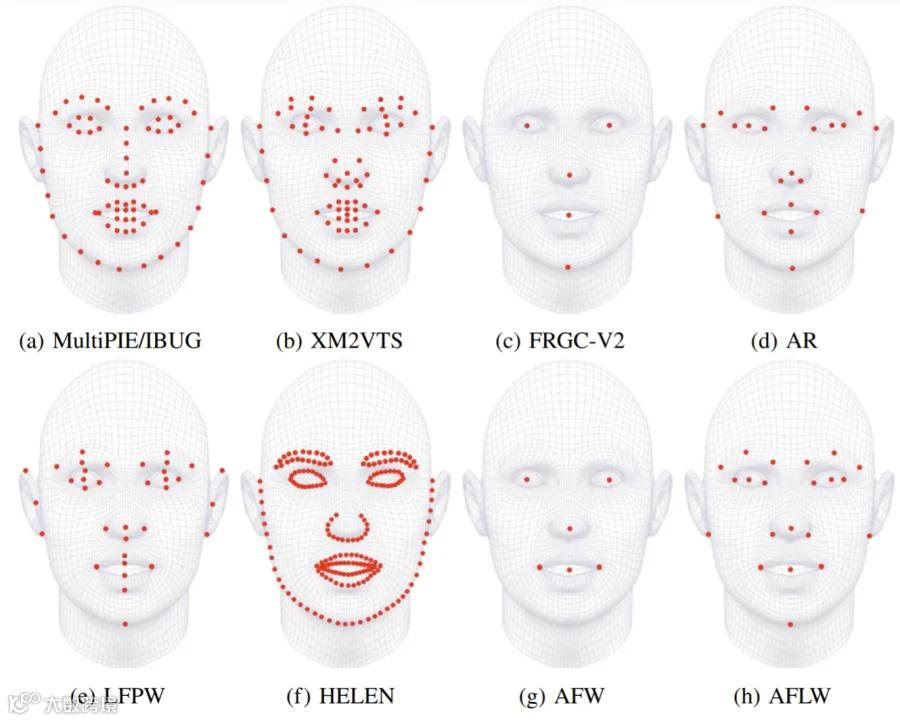
Behzadi 表示:“AR、VR 和元宇宙领域的领先企业正在使用我们多样化的数字人以及配套的丰富 3D 面部和身体地标集,构建更逼真且富有表现力的虚拟形象。”[同时],“我们的智能手机和消费类设备客户正在利用合成数据来了解各种相机模块的性能……我们的几位客户正在构建汽车驾驶员和乘员感知系统。他们利用了车内数千人在各种情境和环境下的合成数据,以确定最佳的相机放置位置和整体配置,从而确保最佳性能。”

值得指出的是,Synthesis支持的某些领域颇具争议,例如面部识别和“情绪感知”。性别和种族偏见是面部分析中一个有据可查的现象,归因于用于训练算法的数据集的缺陷。(一般来说,使用具有同质面部结构和颜色的人像图像开发的算法,对其未接触过的“人脸类型”表现会更差。)最近的研究强调了其后果,显示一些生产系统会将黑人表达的情绪归类为更负面。长期以来,基于计算机视觉的工具如Zoom的虚拟背景和Twitter的自动照片裁剪也历来对肤色较深的人群不利。
但Behzadi乐观地认为,Synthesis可以通过生成原本难以收集的数据示例(例如多样化的人脸)来减少这些偏见。他还声称,Synthesis的合成数据在隐私和合理使用方面具有优势,主要是因为它不与个人身份信息(尽管有些研究持不同意见)挂钩,且不受版权保护(不像公共网络上许多图像那样受版权保护)。
Behzadi 表示:“除了创建能力更强的模型外,Synthesis 还专注于 AI 的道德发展,包括减少偏见、保护隐私和普及访问权限……[该平台]按需提供的完美标注数据,其速度比人工参与标注方法高出几个数量级,成本则大幅降低。”“AI 由高质量标注数据驱动。随着 AI 领域从以模型为中心转向以数据为中心的 AI,数据成为关键的竞争驱动力。”
事实上,合成数据——取决于其应用方式——有可能解决困扰试图实现人工智能商业化的公司的许多开发挑战。最近,麻省理工学院研究人员找到了一种使用合成数据对图像进行分类的方法。Nvidia研究人员已探索了利用在虚拟环境中创建的合成数据来训练机器人拾取物体的方法。几乎每家主要的自动驾驶汽车公司都使用 模拟 数据来补充他们从道路上车辆收集的实时数据。
但同样,并非所有合成数据都同等优质。数据集需要经过转换才能供创建合成数据的系统使用,而转换过程中做出的假设可能导致不理想的结果。一份 STAT 报告 发现,IBM 备受困扰的生命科学部门 Watson Health 经常提供糟糕且不安全的癌症治疗建议,因为该平台的模型是使用错误的合成患者记录而非真实数据进行训练的。而在 2020 年 1 月的一项 研究中,亚利桑那州立大学的研究人员表明,在包含教授图像的 dataset 上训练的 AI 系统可以生成高度逼真的合成面孔——但这些合成面孔大多为男性和白人,因为它放大了原始数据集中存在的偏见。
阿尔伯塔大学计算机科学助理教授 Matthew Guzdial 指出,Synthesis 自己的白皮书承认,仅使用合成数据训练模型通常会导致其表现较差。
“我看不出 Synthesis 的平台有什么特别突出的地方。就合成数据而言,它相当标准。在某些情况下,他们能够结合使用合成数据和真实数据,帮助模型更有效地泛化。”他通过电子邮件告诉 TechCrunch。“[一]般来说,我会引导我的学生避免使用合成数据,因为我发现引入偏差的风险太大,这实际上会使你的最终模型表现更差……由于合成数据是以某种算法方式生成的(例如,通过函数),模型最容易学习的是直接复制该函数的行为,而不是去逼近你真正想要模拟的实际问题。”
数据平台 Apheris 的联合创始人 Robin Röhm 认为, 应该为每个新的合成数据集制定质量检查机制,以防止滥用。他表示,生成和验证数据集的一方必须对数据的具体应用方式有特定的了解,否则就有创建不准确——甚至可能有害——系统的风险。 应该为每个新的合成数据集制定质量检查机制,以防止滥用。他表示,生成和验证数据集的一方必须对数据的具体应用方式有特定的了解,否则就有创建不准确——甚至可能有害——系统的风险。
Behzadi 在原则上表示同意——但他着眼于扩大 Synthesis 支持的应用数量,以击败诸如 Mostly AI、 Rendered.ai, YData, Datagen 和 Synthetaic 等竞争对手。凭借超过 2400 万美元的融资以及在消费者、元宇宙和机器人领域服务的财富 500 强客户,Synthesis 计划推出针对新兴和现有垂直领域的新产品,包括照片增强、视频会议、智能家居和智能助手。凭借无可匹敌的代表性人类数据的广度和深度,Synthesis AI 已确立其作为生产级合成数据首选提供商的地位……该公司已交付超过 1000 万张标注图像,以支持全球最先进的计算机视觉公司。”Behzadi 说。“Synthesis AI 目前有 20 名员工,并计划在今年年底前将规模扩展至 50 人。”
“凭借无可匹敌的代表性人类数据的广度和深度,Synthesis AI 已确立其作为生产级合成数据首选提供商的地位……该公司已交付超过 1000 万张标注图像,以支持全球最先进的计算机视觉公司。”Behzadi 说。“Synthesis AI 目前有 20 名员工,并计划在今年年底前将规模扩展至 50 人。”