


当今最先进的AI系统虽能完成引导汽车、撰写类人散文等壮举,却面临共同的硬件瓶颈。开发前沿系统需巨大算力,如DeepMind的AlphaFold需数百GPU集群;据估计,用单GPU训练OpenAI的GPT-3需耗时355年。
新技术和芯片虽有望降低硬件需求,但使用门槛高,小公司难以企及。基础设施初创公司Exafunction联合创始人Varun Mohan和Douglas Chen指出,这正是行业痛点。今日,Exafunction正式从隐身模式走出,推出旨在抽象化AI训练硬件复杂性的平台。
Chen表示:“AI进步依赖计算复杂度的激增,迫使企业重资投入硬件。然而技术迭代快、工作量增长迅速,加之专用加速器稀缺且高效使用需深奥知识,导致大规模深度学习计算困难重重。”
凭借Greenoaks领投、Founders Fund等参与的2800万美元A轮融资(其中2500万用于本轮),Exafunction致力于解决AI专业知识短缺导致的硬件闲置问题。用于训练AI的GPU及专用芯片常因等待处理器、内存等其他组件而利用率不足。
Weights and Biases创始人Lukas Beiwald透露,其近三分之一客户平均GPU利用率低于15%。Run:AI 2021年调查亦显示,仅17%的公司实现AI资源“高利用率”,22%的基础设施大部分处于空闲状态。
成本随之累积。Run:AI数据显示,截至2021年10月,38%的公司年度AI基础设施预算超100万美元;OpenAI训练GPT-3花费估计达460万美元。
Mohan强调:“深度学习公司应聚焦核心技术,而非耗费精力优化资源。目前尚无竞争对手能在提供卓越性能的同时,有效抽象出GPU等加速硬件的管理挑战。”
一个想法的种子
创立Exafunction前,Chen曾任Facebook软件工程师,参与构建Oculus Quest工具;Mohan则是自动驾驶配送公司Nuro的技术负责人,管理自主性基础设施团队。
Mohan回忆道:“在Nuro,随着深度学习负载日益复杂,缺乏明确的硬件扩展方案成为难题。悖论在于,软件越改进,越需更多模拟迭代以发现边缘缺陷。我们为此付出数千工程小时,才艰难榨取现有资源性能。”
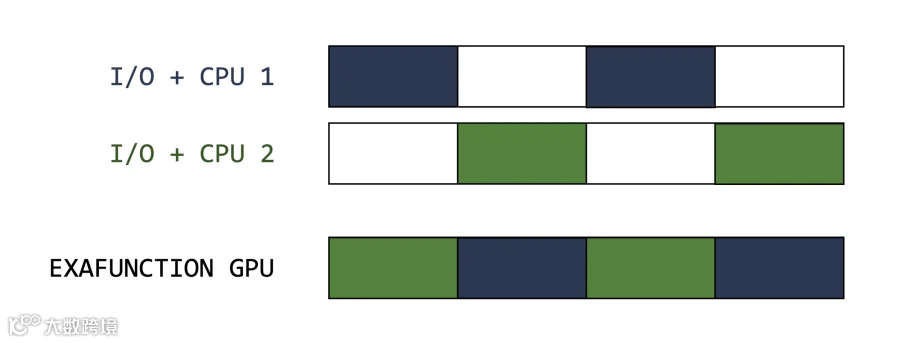
Exafunction客户可接入托管服务或在Kubernetes集群部署其软件。该技术动态分配资源,在可用时将计算转移至竞价实例等“高性价比硬件”。
对于平台内部机制,Mohan和Chen暂保秘密,但解释称:Exafunction利用虚拟化技术,即使在硬件受限时也能运行AI负载,从而提升利用率并降低成本。
尽管未披露是否支持Google TPU等技术细节引发关注,但Mohan表示,Exafunction已在为“计算机视觉领域最前沿的自动驾驶公司及组织”管理GPU。
Mohan补充:“Exafunction将工作负载与加速硬件解耦,确保最大化利用效率——降本增效,让企业充分利用硬件。该平台整合了分散的软件库,有望像AWS变革云计算一样,为深度学习带来变革。”
增长的市场
Exafunction并非孤军奋战。Run:AI同样通过抽象层优化AI负载;Grid.ai提供并行训练软件;Nvidia则推出AI Enterprise套件,支持在认证服务器上虚拟化AI工作负载。
Mohan和Chen认为市场空间依然巨大。他们将订阅制平台定位为降低AI门槛、帮助受供应链限制的企业释放硬件价值的工具。近年来GPU紧缺,云服务虽可用但推高成本;据估计,本地硬件训练成本比最便宜的云方案低多达6.5倍。
Mohan指出:“我们最看好自动驾驶模拟和大规模视频推理两大领域。模拟是自动驾驶验证的核心;视频处理应用广泛但计算密集,每个摄像头每天输出数百万帧图像。尽管GPU至关重要,但因昂贵稀缺,常被未充分利用。”
A轮融资将用于扩大团队、深化产品及优化针对延迟敏感型应用(如自动驾驶、计算机视觉)的AI运行时。
Mohan表示:“目前我们是精干的工程团队,预计2022年将迅速扩张。随着各行业负载复杂化及深度学习普及,算力需求远超供应。这一瓶颈在未来几年,尤其是尖端模型需求指数级增长时,将更加严峻。”