


AI界仍在探索如何应对DALL-E 2展现出的惊人实力,其几乎能绘制或想象任何事物的能力令人瞩目。但OpenAI并非唯一研发此类技术的团队。Google Research正积极宣传其开发的类似模型——Imagen,据称该模型表现甚至更出色。
什么是Imagen?
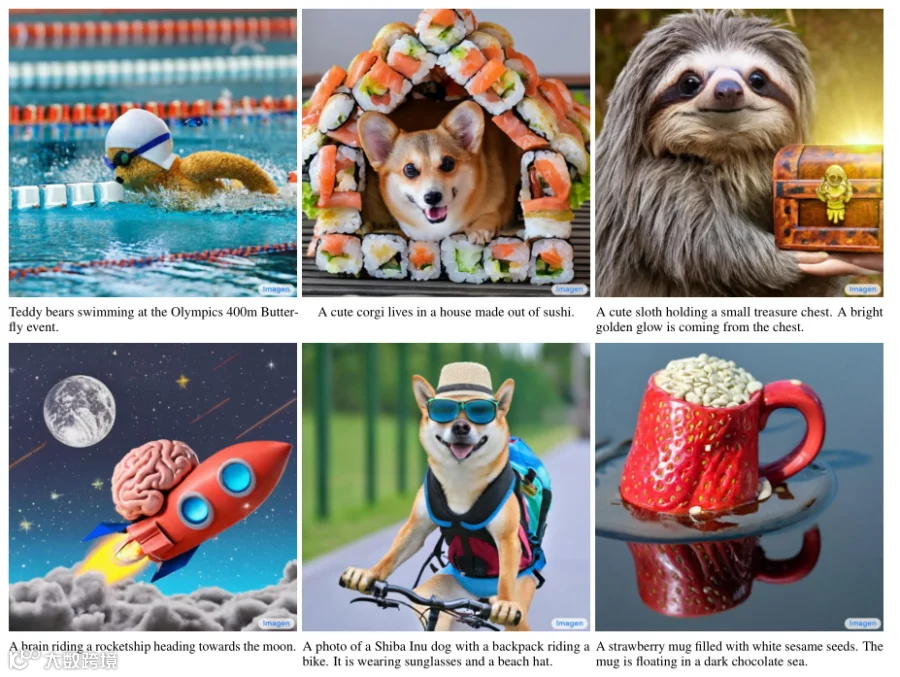
Imagen是一款基于文本到图像扩散模型的生成器,构建于大型Transformer语言模型之上。简单来说:
- 工作原理:接收如“骑自行车的狗”等文本输入,生成对应图像。
- 技术突破:采用扩散技术,从纯噪声图像逐步微调至目标效果,优于传统自上而下的生成方式。
- 语言理解:利用Transformer方法提升语义理解能力,促成了高质量图像生成的实现。
超分辨率与细节生成机制
Imagen首先生成64×64像素的小图,再经两次“超分辨率”处理提升至1024×1024。这种AI超分辨率并非简单放大,而是基于原始图像和谐创造新细节。
例如,在“骑自行车的狗”示例中,狗眼宽度从3像素增至12像素再到48像素。AI凭借对物体结构的认知填充细节,如同艺术家先绘草图、再填色、最后精修的过程。该技术已被艺术家用于创作大幅作品,通过分块超分辨率处理获得远超单次生成能力的丰富细节。
Imagen vs DALL-E 2:核心优势对比
谷歌研究人员指出,Imagen的进步主要体现在以下方面:
- 文本编码优先:现有文本模型的质量比单纯提升视觉保真度更重要,确保内容准确符合描述。
- 语义理解更强:在生成“熊猫制作拿铁拉花”时,Imagen正确呈现了熊猫制作动作,而DALL-E 2多生成熊猫形状的拉花。(注:两者均无法正确渲染“骑在宇航员身上的马”,仍待改进。)

在人类评估测试中,Imagen在准确性与保真度上胜出。尽管达到DALL-E 2的感知质量已属不易,但目前所有生成图像仍难以经受仔细审视,易被识别为AI生成。
产品化进度与安全策略差异
OpenAI在产品化方面领先一步:DALL-E 2已进入私人测试版,用户可实际使用。相比之下,谷歌尚未尝试将Imagen推向市场。
关键差异在于数据治理策略:
- DALL-E 2:提前策划训练集,移除违规内容,模型无法生成NSFW内容。
- Imagen:使用了包含不当材料的LAION-400M等大型数据集。研究团队明确表示:“因存在编码有害刻板印象的风险,在未采取进一步保障措施前,不向公众发布代码或演示版本。”
这种谨慎态度并非过度政治正确,而是基于AI模型高度依赖训练数据质量的现实。未经筛选的数据集往往反映社会偏见,若不在研究阶段暴露并解决这些问题,AI可能完美复现歧视性内容(如特定发型缺失、职业性别固化等)。
消除系统性偏见对人类是终身课题,但对AI而言,创建者可通过移除不良数据源来规避风险。当前纳入此类数据的收益远小于潜在危害。
总结
Imagen与其他模型一样仍处于实验阶段,仅适用于严格人工监督场景。待谷歌完善安全措施并开放能力时,我们将更深入理解其技术原理与应用边界。