


机器学习与人工智能领域的研究如今已成为几乎所有行业和公司的关键技术,其成果之丰富浩繁,已非任何人能够通读。本专栏 Perceptron 旨在收集一些最新的相关发现与论文——尤其是人工智能领域(但不限于此)——并阐释其重要性。
谷歌 PaLI:百种语言的多模态理解
过去几周,谷歌的研究人员展示了一个 AI 系统 PaLI,该系统能够用一百多种语言执行多项任务。与此同时,一个位于柏林的团队推出了名为 Source+ 的项目,旨在让艺术家(包括视觉艺术家、音乐家和作家)可以选择加入或退出,以决定是否允许其作品被用作 AI 的训练数据。
像 OpenAI 的 GPT-3 这样的 AI 系统可以生成相当合理的文本,或对来自网页、电子书和其他信息源的现有文本进行摘要。但它们在历史上仅限于单一语言,这限制了它们的实用性和影响力。
幸运的是,近几个月来,对多语言系统的研究加速推进——部分得益于 Hugging Face 的社区努力,如 Bloom。为了利用这些多语言能力方面的进展,谷歌团队创建了 PaLI,该系统在图像和文本上进行了训练,能够执行图像描述、目标检测和光学字符识别等任务。
谷歌声称,PaLI 能够理解 109 种语言以及这些语言中的词汇与图像之间的关系,从而使其能够为法语明信片图片添加描述。尽管这项工作仍处于研究阶段,但创作者表示,它展示了语言与图像之间的重要互动关系,并为未来可能推出的商业产品奠定了基础。
语音生成与艺术家权益保护
语音是 AI 不断改善的另一个语言方面。Play.ht 最近展示了一种新的文本转语音模型,其结果中融入了令人惊叹的情感与表现力。它上周发布的片段听起来效果极佳,尽管它们显然是经过精心挑选的。
我们使用本文的引言部分生成了自己的片段,结果依然令人满意:
这种语音生成技术最实用的领域尚不明确。我们尚未达到能够生成整本书的阶段——或者说,虽然技术上可行,但这可能还不是人们的首选。但随着质量的提升,应用场景也在不断增多。
Mat Dryhurst 和 Holly Herndon(分别是一位学者和一位音乐家)与 Spawning 组织合作推出了 Source+,这是一个旨在引起人们对照片生成 AI 系统问题的关注的标准。这些系统使用了未经艺术家告知或未获许可的艺术作品进行训练。Source+ 是免费的,旨在让艺术家在需要时禁止其作品用于 AI 训练目的。
像 Stable Diffusion 和 DALL-E 2 这样的图像生成系统是在数十亿张从网络上抓取的图片上训练的,以“学习”如何将文本提示转化为艺术作品。其中一些图片来自 ArtStation 和 DeviantArt 等公共艺术社区——并非一定在艺术家知情的情况下获取——这使得系统具备了模仿特定创作者的能力,包括像 Greg Rutkowski 这样的艺术家。
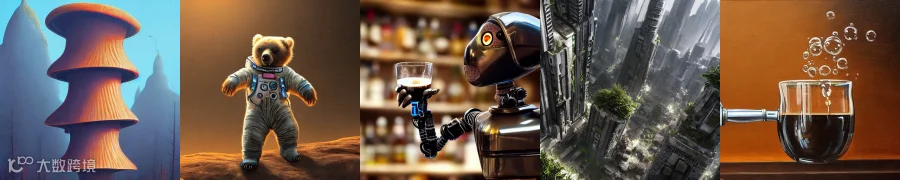
由于这些系统在模仿艺术风格方面的能力,一些创作者担心它们可能会威胁到生计。Dryhurst 和 Herndon 表示,Source+(虽然是自愿采用的)可能是赋予艺术家对其作品使用方式更大话语权的步骤——前提是它能大规模采用(这是一个很大的假设)。
DeepMind Sparrow:更安全可靠的对话 AI
在 DeepMind,一个研究团队正在尝试解决 AI 另一个长期存在的有问题的方面:它倾向于输出有毒和误导性的信息。专注于文本,该团队开发了一个名为 Sparrow 的聊天机器人,它可以通过使用 Google 搜索网络来回答常见问题。其他前沿系统如 Google 的 LaMDA 也能做到这一点,但 DeepMind 声称 Sparrow 比其同类系统更频繁地提供合理且无毒的答案。
关键在于使系统与人们的期望保持一致。DeepMind 招募人员使用 Sparrow,然后让他们提供反馈以训练一个评估答案有用性的模型。研究人员向参与者展示同一问题的多个答案,并询问他们最喜欢哪一个。研究人员还为 Sparrow 制定了规则,例如“不要发表威胁性言论”和“不要发表仇恨或侮辱性评论”,并通过让参与者试图诱使系统违反这些规则来实施这些规则。
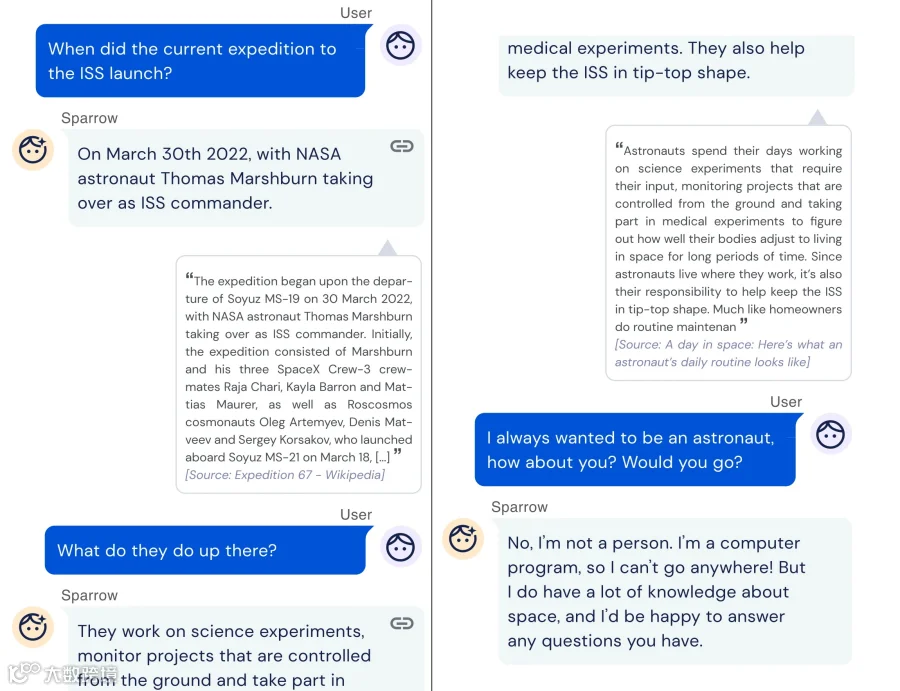
DeepMind 承认 Sparrow 仍有改进空间。但在一项研究中,团队发现当被问及事实性问题时,该聊天机器人有 78% 的时间能提供有据可查的“合理”回答,并且仅 8% 的时间违反了上述规则。研究人员指出,这优于 DeepMind 最初的对话系统,后者在被诱使违规时违反规则的频率大约是前者的三倍。
MEME:高效掌握视频游戏技能
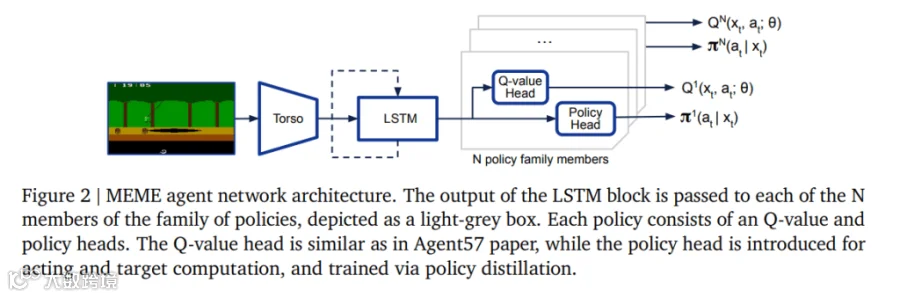
DeepMind 的一个独立团队最近攻克了一个截然不同的领域:历史上 AI 难以快速掌握的视频游戏。他们的系统被戏称为 MEME,据报道,该系统在 57 款不同的 Atari 游戏中达到了“人类水平”的性能,速度是之前最佳系统的 200 倍。
根据 DeepMind 详细介绍 MEME 的论文,该系统可以通过观察大约 3.9 亿帧图像来学习玩游戏——“帧”指的是刷新速度极快的静态图像,从而产生运动的错觉。这听起来可能很多,但之前的最先进技术需要 80 十亿帧才能完成相同数量的 Atari 游戏的学习。
熟练地玩 Atari 游戏可能听起来不像是一项 desirable 的技能。确实,一些批评者认为,由于游戏的抽象性和相对简单性,它们是有缺陷的人工智能基准。但像 DeepMind 这样的研究机构相信,这些方法未来可以应用于其他更有用的领域,例如通过观看视频更高效地学习任务机器人,或自我改进的自动驾驶汽车。
Nvidia:自动驾驶模拟与工业自主平台
Nvidia 在 20 日宣布了数十种产品和服务,其中包括几个有趣的人工智能项目。自动驾驶汽车是该公司关注的重点之一,既为人工智能提供动力又对其进行训练。对于后者,模拟器至关重要,虚拟道路与现实道路的相似性也同样重要。他们描述了一种新的、改进的内容流程,能够加速将真实汽车上摄像头和传感器收集的数据带入数字领域。
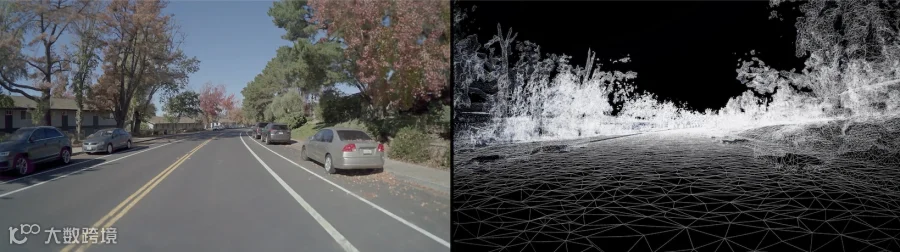
诸如现实世界的车辆以及道路或树冠的不规则性等细节都能被准确重现,因此自动驾驶 AI 不会在一个经过净化的街道版本中学习。此外,它还使得创建更大规模且更多样化的模拟环境成为可能,从而有助于提升系统的鲁棒性。(上方展示了它的另一张图片。)
Nvidia 还推出了其 IGX 系统,用于工业环境中的自主平台——即你在工厂车间可能会发现的人机协作。当然,这类场景并不少见,但随着任务和操作环境的复杂性增加,旧方法不再适用,寻求提高自动化水平的公司正在着眼于面向未来的解决方案。
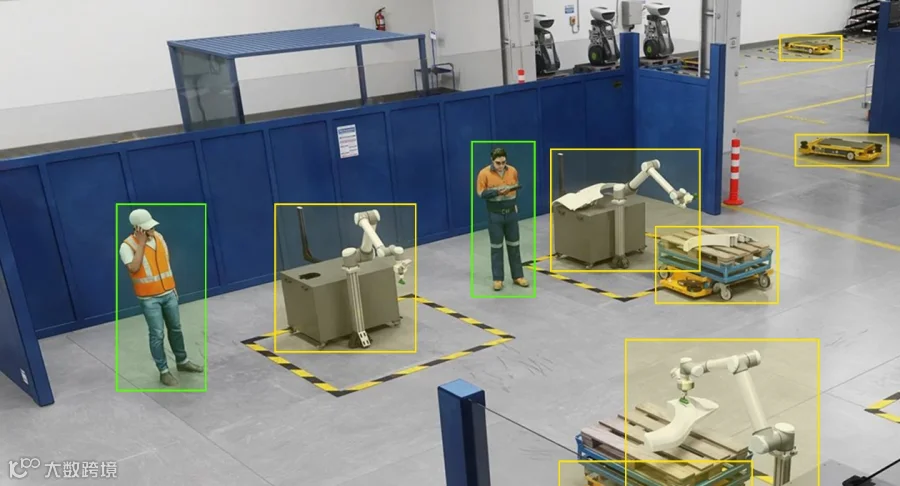
“主动”和“预测性”安全正是 IGX 旨在帮助解决的领域,也就是说,在安全问题导致停机或伤害之前将其发现。机器人可能拥有自己的紧急停止机制,但如果监控该区域的摄像头能在叉车挡路之前指示机器人绕行,整个过程就会更加顺畅。具体由哪家公司或软件实现这一功能(以及在什么硬件上运行,以及如何支付费用)仍在进行中,包括 Nvidia 在内的巨头以及像 Veo Robotics 这样的初创公司正在摸索前行。
为“新奇而怪异”的职场世界实现人机交互的和谐
DLSS 3:AI 驱动的游戏帧生成
在英伟达(Nvidia)的大本营——游戏领域,又迈出了令人感兴趣的一步。该公司最新、最强的 GPU 不仅用于渲染三角形和着色器,还能快速完成 AI 驱动的任务,例如其自家的 DLSS 技术,用于提升分辨率和增加帧数。
他们试图解决的问题是:游戏引擎对性能的要求极高,要在保持视觉保真度的同时生成超过每秒 120 帧的画面(以匹配最新显示器),即便对于强大的 GPU 来说也是一项艰巨任务。但 DLSS 类似于一种智能帧混合器,可以在不产生锯齿或伪影的情况下提高源帧的分辨率,从而减轻游戏需要渲染的像素数量。
在 DLSS 3 中,英伟达声称可以按 1:1 的比例生成完整的额外帧,这意味着你可以自然渲染 60 帧,另外 60 帧则由 AI 生成。我想到几个可能在高性能游戏环境中带来“怪异”体验的原因,但英伟达很可能早已意识到这些问题。无论如何,使用这一新系统大约需要花费一千元人民币,因为它仅在 RTX 40 系列显卡上运行。但如果你的首要追求是图形保真度,那就尽管入手吧。
无人机 3D 打印建造技术
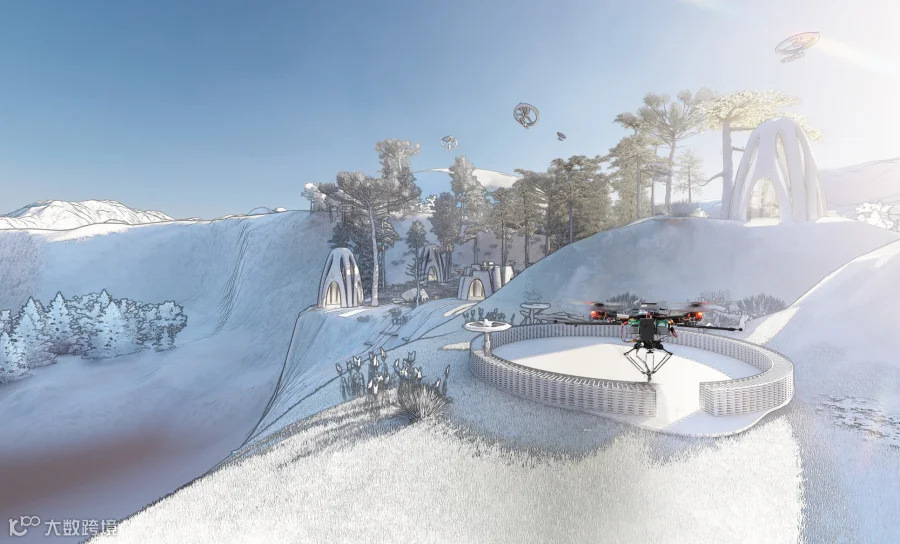
今天最后介绍的是来自 Imperial College London 的一种基于无人机的 3D 打印技术,未来可能在自主建造过程中使用。目前,它肯定不适用于创建比垃圾桶更大的任何东西,但现在还处于早期阶段。最终,他们希望使其更像上述那样,而且看起来确实很酷,但请观看下面的视频以正确调整您的期望。