


Meta研究人员在AI艺术生成领域取得重大突破,推出名为Make-A-Video的新技术。该技术能够仅凭文本提示生成视频,结果令人印象深刻且风格多样,但普遍带有一丝诡异感。
此前虽已有文本到视频模型(作为DALL-E等文本到图像模型的自然延伸),但从静态图像跨越到动态图像对机器学习而言绝非易事。
Make-A-Video并未彻底改变后端规则。正如论文所述:“一个只见过描述图像的文本的模型,在生成短视频方面出奇地有效。”
该AI采用现有的扩散技术创建图像,即从纯视觉噪点开始通过“去噪”逐步逼近目标提示。新增之处在于,模型还对大量未标记视频内容进行了无监督训练,自行分析数据而无需人类强引导。
模型一方面学会了制作逼真图像,另一方面了解了视频连续帧的形态。令人惊叹的是,它能在未经特定组合训练的情况下,高效地将两者结合。
研究人员表示:“在空间和时间分辨率、文本忠实度及质量等方面,定性和定量指标均证实Make-A-Video确立了文本到视频生成的新最先进水平。”
这一观点难以反驳。相比此前令人失望但充满希望的尝试,Make-A-Video实现了巨大飞跃,其保真度已接近18个月前原始DALL-E的水平。
然而必须承认,这些作品仍显不对劲。虽不应苛求照片级真实感或完全自然的动作,但结果确实带有一种噩梦般的特质。
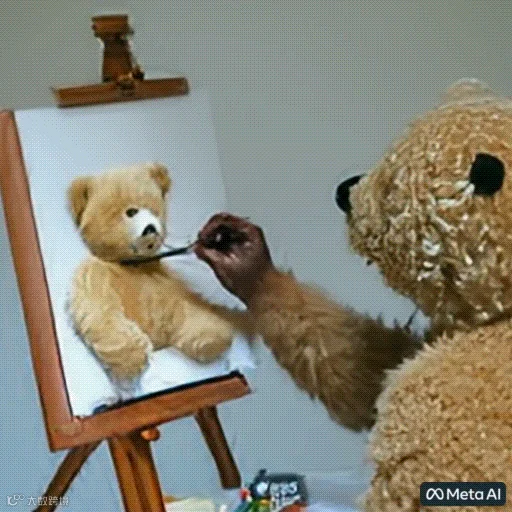
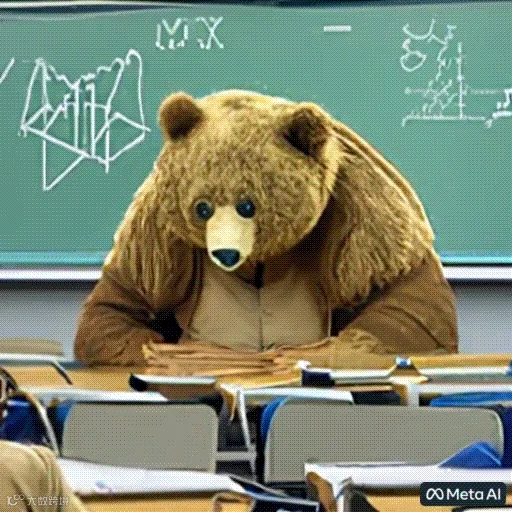
视频质量既如梦似幻又存在缺陷:运动质感怪异如定格动画;失真和伪影带来毛茸茸的超现实感,仿佛物体正在渗漏;人物彼此融合,显示出模型无法理解物体边界及接触关系。
这并非以追求高清逼真的精英姿态评判,而是认为这种逼真与怪异并存的现象本身十分迷人。尽管生成快速便捷且未来可期,但即便最优秀的生成器仍保留着难以言喻的超现实质感。
此外,Make-A-Video支持将静态图像或其他视频转换为变体或扩展版本(类似以图生图),此类结果稍显自然。
相比前代技术,这是巨大的飞跃,团队值得祝贺。目前该技术尚未向公众开放,用户可提前注册等待后续访问权限。