


蛋白质是自然界中执行各种功能的分子,围绕成功修改和制造它们以满足各种用途,整个行业正在兴起。但这样做既耗时又缺乏条理;Cradle旨在通过一款由人工智能驱动的工具来改变这一现状,该工具告诉科学家哪些新的结构和序列能让蛋白质实现他们的预期功能。该公司今天从隐身状态中亮相,并获得了巨额种子轮融资。
最近,人工智能和蛋白质频频登上新闻头条,但这主要归功于像DeepMind和Baker Lab这样的研究机构的努力。它们的机器学习模型接收容易收集的RNA序列数据,并预测蛋白质将采取的结构——这一步骤过去需要数周时间和昂贵的专用设备。
但在某些领域,尽管这种能力令人惊叹,它也只是其他领域的起点。要使蛋白质更稳定或结合到特定的其他分子上,不仅仅需要了解其大致形状和大小。
“如果你是一名蛋白质工程师,想要在设计中加入某种特性或功能给蛋白质,仅仅知道它长什么样对你没有帮助。这就像,如果你有一张桥的照片,那并不能告诉你它是否会倒塌,”Cradle首席执行官兼联合创始人Stef van Grieken解释道。
他继续说道:“Alphafold接收一个序列并预测蛋白质的外观。我们是它的生成式兄弟:你选择想要工程化的特性,模型就会生成你可以在实验室中测试的序列。”
由于诸多原因,预测蛋白质(尤其是科学界全新的蛋白质)在原位的表现是一项艰巨的任务,但在机器学习的背景下,最大的问题在于可用数据不足。因此,Cradle在湿实验室中自行生成了大部分数据集,对一个个蛋白质进行测试,观察其序列变化似乎会导致何种效应。
有趣的是,该模型本身并不完全针对生物技术领域,而是源自同样的“大型语言模型”,这些模型产生了像GPT-3这样的文本生成引擎。Van Grieken指出,这些模型在理解和预测数据方面并不严格局限于语言,这是一种研究人员仍在探索的有趣的“泛化”特征。“大型语言模型”Cradle摄入和预测的蛋白质序列当然不是我们已知的任何语言,但它们是比较直白的具有相关含义的线性文本序列。“这就像一种外星编程语言,”van Grieken说。
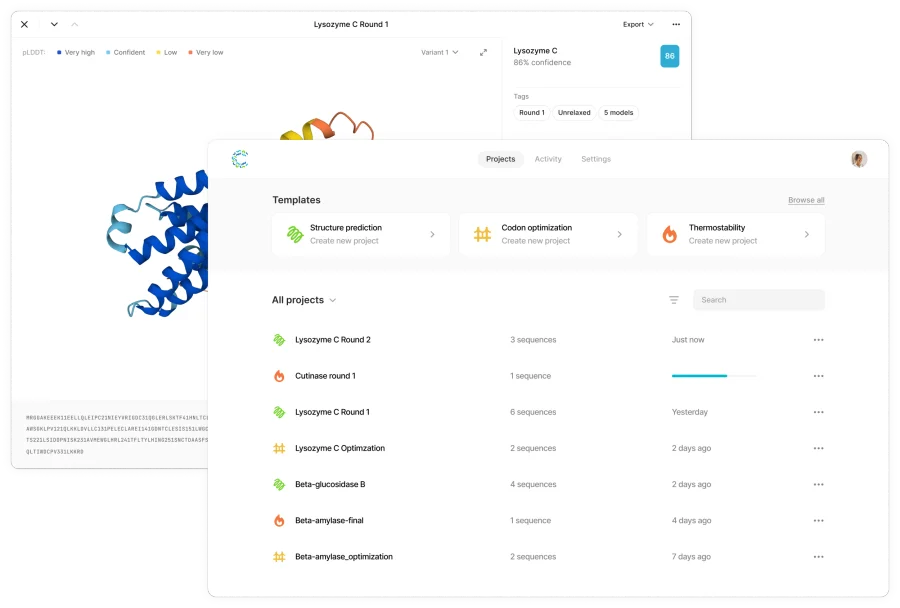
蛋白质工程师当然并非束手无策,但他们的工作必然涉及大量的猜测。人们可能相当确定,在他们正在修改的100个序列中,存在能产生所需效果的组合,但除此之外,最终还是要依靠穷举测试。这里的一点提示可以大大加快速度,避免大量徒劳的劳动。
他解释说,该模型在三个基本层面上运作。首先,它评估给定序列是否“自然”,即判断其是有意义的氨基酸序列还是随机生成的。这类似于语言模型能够以99%的置信度判断一个句子是英语(或在范·格里肯的例子中是瑞典语),并且单词顺序正确。这是通过“阅读”数百万条经实验室分析确定的此类序列而获得的认知。
Charm Therapeutics将AI应用于复杂的蛋白质相互作用,完成5000万美元A轮融资
接下来,它会查看蛋白质这种“外星语言”中的实际或潜在含义。“想象一下我们给你提供一个序列,并告诉你这个序列解体的温度,”他说,“如果你针对大量序列这样做,你不仅能说‘这看起来是自然的’,还能说‘这看起来像是26摄氏度’。这有助于模型确定应关注蛋白质的哪些区域。”
随后,该模型可以建议插入的序列——本质上是有根据的猜测,但比从零开始提供了更强的起点。工程师或实验室随后可以尝试这些序列,并将数据反馈回Cradle平台,在那里数据可被重新摄入并用于针对特定情况微调模型。
为各种目的改造蛋白质在生物技术领域具有广泛用途,从药物设计到生物制造皆然,而从普通分子转变为定制化、高效且有效的分子的路径可能漫长且昂贵。任何能缩短这一过程的方法都将受到欢迎,至少那些为了获得一个良好结果就必须进行数百次实验的实验室技术人员会对此表示欢迎。
Cradle此前一直处于保密运营状态,如今已走出隐身期,并在种子轮融资中筹集了550万美元,该轮由Index Ventures和Kindred Capital联合领投,John Zimmer、Feike Sijbesma和Emily Leproust等天使投资人参与投资。
范·格里肯表示,这笔资金将使团队能够扩大数据收集规模——在机器学习中,数据越多越好——并完善产品,使其更加“自助化”。
范·格里肯在新闻稿中表示:“我们的目标是将生物基产品推向市场的时间和成本降低一个数量级,以便任何人——甚至是‘车库里的两个小孩’——都能将生物基产品推向市场。”
Generate Biomedicines以蛋白质类药物为重点,完成3.7亿美元B轮融资