


对于数据科学背景的Jae Lee而言,视频虽已成为生活不可或缺的一部分(得益于TikTok、Vimeo和YouTube等平台的兴起),却因语境理解的技术障碍而难以搜索。搜索视频的标题、描述和标签仅需基本算法即可实现;但长期以来,在视频内部搜索未明显标注的特定时刻和场景,始终超出科技能力范围。
为解决这一痛点,Lee与科技行业伙伴共同构建了用于视频搜索和理解的云服务——Twelve Labs。该公司近期获得1700万美元风险投资,其中1200万美元来自种子轮扩展融资。本轮由Radical Ventures领投,Index Ventures、WndrCo、Spring Ventures及Weights & Biases CEO Lukas Biewald等参投。
“Twelve Labs的愿景是为开发者提供最强大的视频理解基础设施,帮助构建能像人类一样看、听和理解世界的程序。”Lee表示。
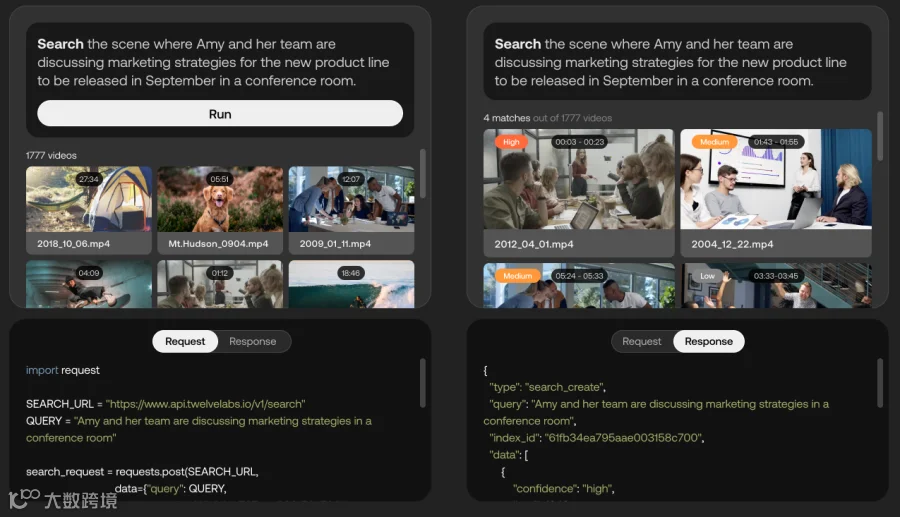
目前处于封闭测试阶段的Twelve Labs,利用AI从视频中提取运动行为、物体人物、声音、屏幕文本及语音等“丰富信息”,并识别其关联。平台将这些元素转换为数学“向量”,在帧间建立“时间连接”,从而实现视频场景搜索等功能。
“为实现智能视频应用愿景,团队正构建多模态视频理解‘基础模型’。”Lee介绍,“开发者可通过API访问这些模型,不仅执行语义搜索,还能完成长视频章节划分、摘要生成和视频问答等任务。”
Google采用类似方法驱动Search和YouTube推荐,其MUM AI系统可根据音频、文本和视觉内容识别视频主题(如“丙烯酸绘画材料”)。尽管技术相当,但Twelve Labs是首批将其推向市场的供应商之一;Google则选择将MUM保留在内部,未通过公开API提供服务。
此外,Google Cloud Video AI、Azure Video Indexer和AWS Rekognition等服务可识别视频中的物体、地点和行为并提取元数据;法国初创公司Reminiz也声称能对各类视频索引并添加标签。但Lee强调Twelve Labs具备差异化优势:其平台允许客户针对特定类别的视频内容微调AI。
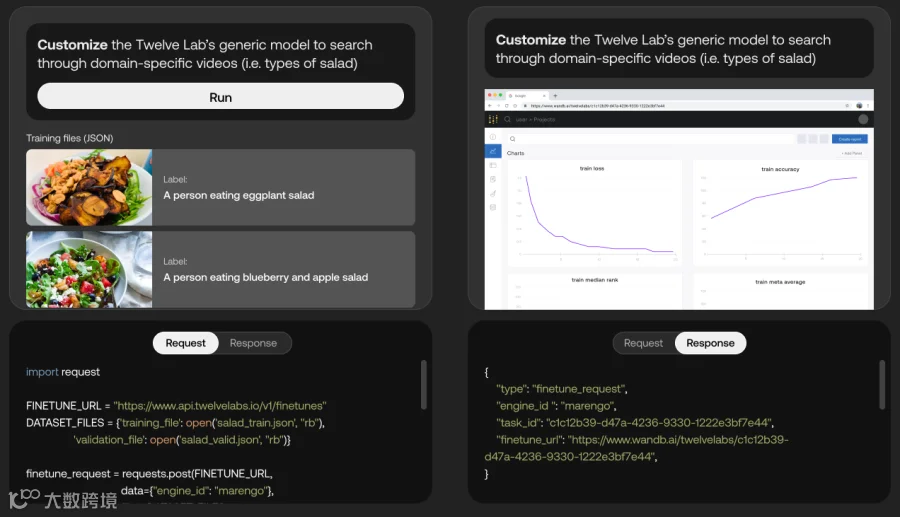
Lee指出:“专为检测特定问题构建的窄AI在受控环境下准确率高,但在面对杂乱真实世界数据时扩展性差。它们更像基于规则的系统,缺乏泛化能力,根源在于上下文理解不足。上下文理解赋予人类在不同现实情境中泛化的独特能力,而这正是Twelve Labs的独特之处。”
除搜索功能外,该技术还可推动广告插入和内容审核(如智能判断展示刀具的视频属暴力内容还是教学指导),并支持媒体分析、实时反馈及自动生成精彩集锦。
成立一年多以来(2021年3月创立),Twelve Labs已拥有付费客户(具体数量未披露),并与Oracle签订多年期合同,利用其云基础设施训练AI模型。未来,公司将投入资源完善技术并扩大团队规模。(当前员工人数未透露,LinkedIn数据显示约18人。)
“对大多数公司而言,自行训练、运营和维护大模型并不划算。”Lee表示,“通过Twelve Labs平台,组织只需几次直观的API调用即可获得强大视频理解能力。AI创新的未来直指多模态视频理解,Twelve Labs已占据有利位置,有望在2023年进一步突破边界。”