


像 DALL-E 2 和 Stable Diffusion 这样的图像生成 AI 模型能够——并且确实——复制其训练数据中图像的某些方面,研究人员在 一项新研究中指出,随着这些服务进入广泛的商业应用,这引发了人们的担忧。
这项由马里兰大学和纽约大学科学家共同撰写的研究确定了图像生成模型(包括 Stable Diffusion)从用于训练的公共互联网数据(包括受版权保护的图像)中“复制”的案例。
需要澄清的是,该研究尚未经过同行评审。一位不愿透露姓名的该领域研究人员通过电子邮件向 TechCrunch 分享了高层面的观点。
“尽管扩散模型(如 Stable Diffusion)能生成美丽的图像,且往往看起来高度原创并针对特定文本提示量身定制,但我们表明,这些图像实际上可能是从其训练数据中复制的,无论是整体复制还是仅复制训练图像的部分内容,”该研究人员表示。“使用扩散模型生成数据的公司在知识产权法方面可能需要重新考虑。几乎不可能验证 Stable Diffusion 生成的任何特定图像是否具有新颖性而非从训练集中窃取。”
从噪声中生成图像
像 Stable Diffusion 这样的先进图像生成系统被称为“扩散”模型。扩散模型在处理庞大的训练数据集时,学习如何根据文本提示(例如,“一只栖息在窗台上的鸟的素描”)创建图像。这些模型被训练为“重建”图像,而不是从头开始绘制,它们从纯噪声开始,并随时间推移逐步优化图像,使其逐渐接近文本提示。
这项技术并不直观。但它极其擅长生成各种风格的艺术作品,包括照片级逼真的艺术。事实上,扩散技术催生了一系列引人注目的应用,从 Lensa 中的合成头像到 Canva 中的艺术工具。DeviantArt 最近发布了一款 由 Stable Diffusion 驱动的应用 ,用于创建定制艺术作品,而微软正在 利用 DALL-E 2 将为即将登陆 Microsoft Edge 的生成式艺术功能提供动力。
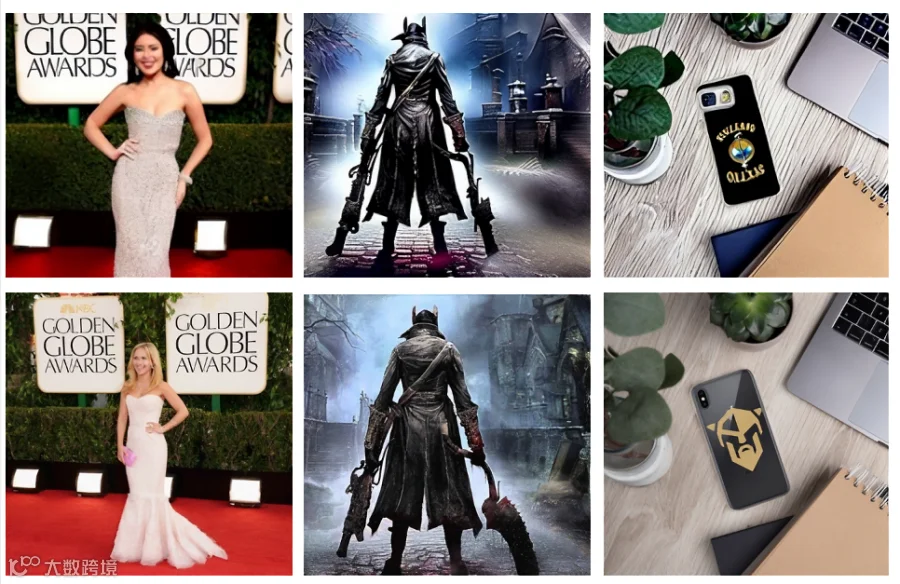
需要明确的是,扩散模型会复制训练图像中的元素,这并非秘密,因为这些图像通常是从网络上 indiscriminately(不加区分地)抓取的。角色设计师如 Hollie Mengert 和 Greg Rutkowski,他们的古典绘画风格和奇幻景观已成为 Stable Diffusion 中最常用的提示词之一, 他们 谴责 他们认为那些尽管与其姓名相关联但质量低劣的 AI 模仿作品。
但由于扩散系统是在来自不同来源的数十亿张图像上训练的,因此很难实证衡量复制发生的频率。
为了研究 Stable Diffusion,研究人员的方法是从一个名为 LAION-Aesthetics 的数据集中随机抽取 9,000 张图像——这是用于训练 Stable Diffusion 的图像集之一——以及这些图像对应的标题。LAION-Aesthetics 包含与文本标题配对的图像, 包括 受版权保护的角色的图像(例如卢克·天行者和蝙蝠侠)、来自受知识产权保护的来源(如 iStock)的图像,以及来自在世艺术家(如 Phil Koch 和 Steve Henderson)的艺术作品。
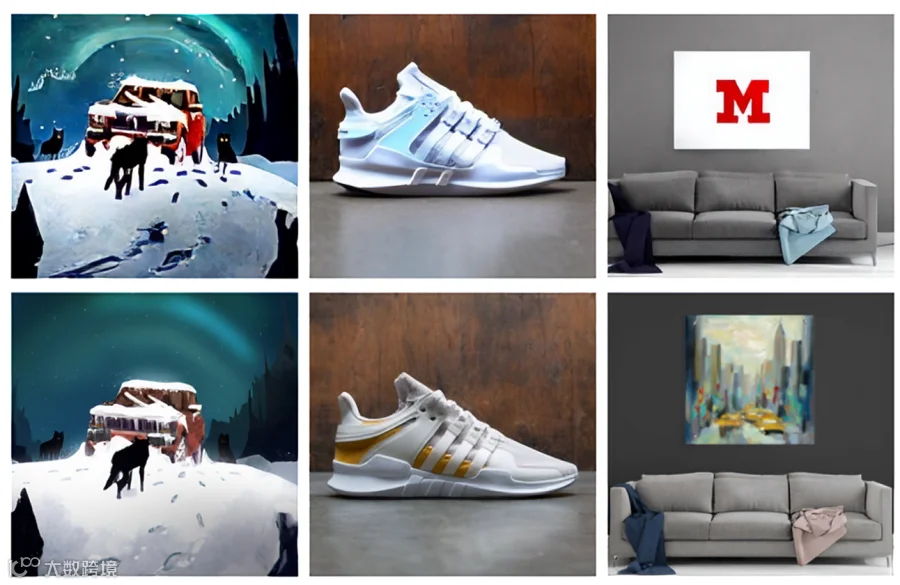
研究人员将标题输入 Stable Diffusion,让系统创建新图像。然后,他们为每张图像编写新的标题,试图让 Stable Diffusion 复制这些合成图像。在使用自动相似度检测工具进行比较后,研究人员表示,在两组生成的图像中——一组由 LAION-Aesthetics 标题创建,另一组由研究人员的提示词创建——Stable Diffusion 在结果中发现了“大量的复制”现象,包括从训练集中回收的背景和物体。
一个提示词——“Canvas Wall Art Print”(画布墙艺印刷品)—— consistently(一致地)产生了显示特定沙发的图像,这是一个相对平凡的例子,展示了扩散模型如何将语义概念与图像关联起来。其他包含“painting”(绘画)和“wave”(波浪)字样的提示词生成了类似于葛饰北斋画作《神奈川冲浪里》中的波浪的图像。 相对平凡的例子 展示了扩散模型如何将语义概念与图像关联起来。其他包含“painting”(绘画)和“wave”(波浪)字样的提示词生成了类似于葛饰北斋画作《神奈川冲浪里》中的波浪的图像。
研究人员表示,在所有实验中,Stable Diffusion 从训练数据集中“复制”内容的比例约为 1.88%。这听起来可能不多,但考虑到扩散系统如今的广泛影响力——据一项粗略估计,截至 10 月,Stable Diffusion 已生成超过 1.7 亿张图片——这一现象不容忽视。
该研究人员表示:“艺术家和内容创作者绝对应该感到担忧,因为他人可能会在未获同意的情况下利用他们的内容牟利。”
影响
在研究中,共同作者指出,Stable Diffusion 生成的图像中没有一张与其对应的 LAION-Aesthetics 源图像完全匹配,并且他们测试的所有模型并非都同样容易进行复制。模型复制的频率取决于多个因素,包括训练数据集的大小;较小的数据集往往导致更多的复制行为。
研究人员调查的一个系统是 ImageNet 开源数据集上训练的扩散模型,他们在文中写道,“该模型在任何生成中均未显示出显著的复制行为”。
共同作者还建议不要对研究结果过度推断。受计算成本的限制,他们在实验中仅能采样 Stable Diffusion 完整训练数据集的一小部分。
尽管如此,他们认为这些结果应促使企业重新考虑数据集的构建过程以及在数据集上训练模型的流程。Stable Diffusion 等系统背后的供应商长期以来一直声称,合理使用(美国法律中允许在未事先获得权利人许可的情况下使用受版权保护材料的学说)可以在其模型基于授权内容训练时提供保护。但这仍是一个未经检验的理论。
该研究人员表示:“目前,数据策展是盲目的,且数据集规模如此庞大,以至于人工筛选不可行。扩散模型令人惊叹且强大,并展示了如此令人印象深刻的成果,我们无法抛弃它们,但我们应考虑如何在不损害隐私的情况下保持其性能。”
对于使用扩散模型为其应用和服务提供动力的企业来说,这项研究可能会让他们三思。律师事务所 MBHB 的创始合伙人、知识产权法专家 Bradley J. Hulbert 表示,他认为法官不太可能将 AI 生成艺术中受版权保护作品的复制视为合理使用——至少在 DALL-E 2 这样的商业系统中是这样。出于同样的担忧,Getty Images 已禁止在其平台上发布 AI 生成的艺术作品。此前在接受采访时,Bradley J. Hulbert 表达了类似观点,强调了商业系统中的版权风险。
该问题很快将在法庭上展开。11月,一名软件开发者对微软、其子公司GitHub以及商业伙伴OpenAI提起集体诉讼,指控Copilot——GitHub的AI驱动代码生成服务——涉嫌违反版权法。该诉讼的核心在于,Copilot在互联网上数以百万计的代码示例基础上进行训练,却会复述受许可保护的代码片段而未提供署名。
除了法律后果之外,人们有理由担心提示词可能会直接或间接地暴露图像训练数据集中嵌入的某些更敏感的数据。正如《Ars Technica》最近的一份报告所揭示的那样,多达数千份的私人医疗记录就隐藏在Stable Diffusion数据集的照片中。
共同作者提出了一种解决方案(并非由他们首创),即采用一种称为差分隐私训练的技术,该技术将使扩散模型对其用于训练的数据“去敏感化”,从而在过程中保护原始数据的隐私。研究人员表示,差分隐私训练通常会损害性能,但如果其他方法失败,这可能是未来保护隐私和知识产权所必须付出的代价。
研究人员表示:“一旦模型记住了数据,就很难验证生成的图像是否原创。”“我认为内容创作者正在意识到这一风险。”