


任何人都能越来越轻松地用他人的声音制作逼真的音频,这令许多人感到不安。Resemble AI 提出的生成语音水印方案虽无法一劳永逸地解决问题,但无疑是正确的方向。
AI 生成的语音已广泛应用于屏幕阅读器、配音替换(获授权前提下)等合法场景。然而,该技术同样可能被滥用于伪造政客或名人言论。因此,建立一种不依赖人工甄别即可区分真伪的机制显得尤为迫切。
什么是音频水印?
水印是一种通过嵌入可识别模式来标识内容来源的技术。除了显眼的图像标志外,还存在隐形水印:在像素级隐藏信息使肉眼难以察觉,或在音频中嵌入人耳无法感知的微弱编码信号。
此类隐形水印的短板在于脆弱性。调整图像尺寸可能导致像素代码丢失;对音频进行流媒体编码压缩时,秘密音调也可能被彻底抹除。
Resemble AI 的安全诉求
作为新一代生成式 AI 初创公司,Resemble AI 利用精细调优的语音模型制作配音及有声读物等内容。若这些基于演员数小时音频训练的模型落入恶意方手中,公司将面临严重的公关危机与法律风险。因此,其核心诉求是确保录音既逼真又易于验证为 AI 生成。
如果你尚未感到担忧,VALL-E 的快速语音深度伪造技术理应让你忧心忡忡。
PerTh:感知与阈值结合的水印技术
Resemble 为此推出了名为 PerTh 的水印处理流程,该名称结合了“感知”与“阈值”概念。
该公司在博客文章中解释:“我们开发了一层额外的安全机制,利用机器学习模型在生成的语音中嵌入数据包,并能在后续阶段恢复这些数据。由于数据不可察觉且与语音紧密耦合,极难被移除,从而提供了一种验证片段是否由 Resemble 生成的方法。重要的是,该技术还能容忍加速、减速、MP3 压缩等多种音频操作。”
其原理利用了人类听觉的掩蔽效应:高可听度音调会掩盖附近低振幅音调。例如,当笑声在 5,000 Hz、8,000 Hz 和 9,200 Hz 处产生峰值时,可在几赫兹范围内插入结构化音调。这些音调对听众几乎不可闻,但因紧邻关键音频部分而具备抗删除性。
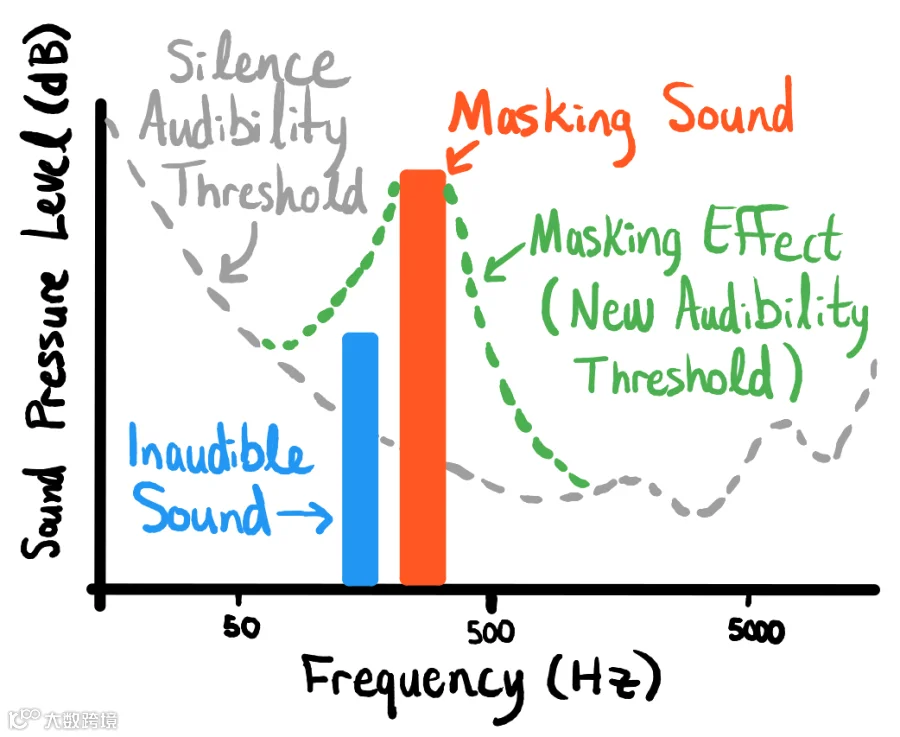
尽管原理直观,挑战仍在于构建一个能定位候选波形段、自动生成合适且不可听携带信息的机器学习模型,同时还需逆转该过程并对常见音频操作保持鲁棒性。
官方提供了两个示例供测试分辨。即便仔细检查波形也未发现明显异常,但若其声称已将 Resemble 生成数据近乎不可逆地编码其中,则表明该技术已取得成效。
行业展望与局限
PerTh 即将向所有客户推出,目前仅能标记和检测 Resemble 自产语音。若验证成功,其他厂商或将跟进,未来水印功能很可能与语音生成模型深度融合。尽管恶意行为者总会设法绕过,但设置技术门槛有助于遏制滥用。
需注意的是,音频具有特殊性,类似技巧并不适用于文本或图像领域。因此,在这些领域内,我们预计将在较长时期内继续处于“恐怖谷”状态。