


两年前,微软发布了 Florence,这是一个被其定位为对现代计算机视觉模型“彻底重新思考”的 AI 系统。与当时的大多数视觉模型不同,Florence 既是“统一的”又是“多模态的”,这意味着它能够(1)同时理解语言和图像,以及(2)处理一系列任务,而不是局限于特定应用,例如生成图片说明。
如今,作为微软更广泛的持续将 AI 研究商业化的努力的一部分,Florence 正作为 Azure Cognitive Services 中 Vision APIs 更新的一部分推出。基于 Florence 的 Microsoft Vision Services 今日面向现有 Azure 客户以预览版形式发布,功能涵盖自动字幕生成、背景移除和视频摘要到图像检索等。
“Florence 是在数十亿图文对上训练而成的。因此,它非常通用,”Azure AI 首席副总裁 John Montgomery 表示。“让 Florence 在视频中寻找特定帧,它能做到;让它区分 Cosmic Crisp 苹果和 Honeycrisp 苹果,它也能做到。”
多模态模型:构建强大AI系统的最佳路径
包括微软在内的科技巨头及 AI 研究界日益达成共识,即多模态模型是构建更强大 AI 系统的最佳路径。自然,多模态模型——即能够理解语言、图像、视频和音频等多种模态的模型——能够一次性完成单模态模型无法完成的任务(例如为视频生成字幕)。
为什么不将几个“单模态”模型串联起来以达到相同的目的?原因有几个:
- 性能优势:多模态模型在某些情况下比其单模态对应模型在同一任务上表现更好,这得益于来自额外模态的上下文信息。例如,一个能理解图像、定价数据和购买历史的 AI 助手,很可能比仅理解定价数据的助手提供更个性化的产品建议。
- 计算效率:从计算角度来看,多模态模型往往更高效,从而带来处理速度的提升以及后端成本的降低。鉴于微软是一家追求利润的企业,这无疑是一个优势。
那么 Florence 呢?由于它能理解图像、视频以及这些模态之间的关系,它可以执行诸如衡量图像与文本之间的相似度,或在照片中分割对象并将其粘贴到另一个背景上的操作。
数据安全与内容审核
针对 Florence 的训练数据来源问题,Montgomery 未提供具体细节,仅表示 Florence 使用“负责任获取的”数据来源,“包括来自合作伙伴的数据”。此外,他表示 Florence 的训练数据已清除潜在问题内容。
“在使用大型基础模型时,确保训练数据集的质量至关重要,以便为每个视觉任务的适配模型奠定基础,”Montgomery 说。“此外,每个视觉任务的适配模型已经过公平性、对抗性和挑战性案例的测试,并实施了我们在 Azure Open AI Service 和 DALL-E 中一直使用的相同内容审核服务。”
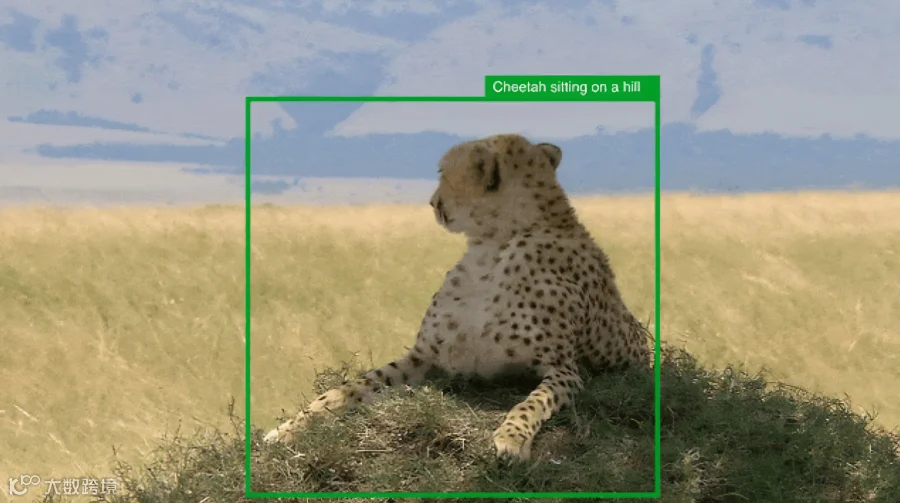
落地应用:从Reddit到微软全家桶
目前,已有部分客户开始采用该技术。Montgomery 表示,Reddit 将使用新的由 Florence 驱动的 API 为其平台上的图像生成标题,创建“替代文本”,以便视力障碍用户能更好地跟随线程内容。
“Florence 每张图片最多可生成 10,000 个标签的能力,将使 Reddit 对能识别图片中物体数量的控制力更强,并有助于生成更好的描述,”Montgomery 指出。“Reddit 还将利用这些描述帮助所有用户改进文章排名,以便搜索帖子。”
Microsoft 也在其众多自有平台、产品和服务中使用 Florence:
- LinkedIn:生成用于编辑和支持替代文本(alt text)的图像描述。
- Microsoft Teams:推动视频分割功能。
- PowerPoint、Outlook 和 Word:利用 Florence 的图像描述能力自动生成替代文本。
- Designer 和 OneDrive:获得更好的图像标记、图像搜索和背景生成功能。
未来展望
Montgomery 认为,未来客户还将把 Florence 用于更多其他用途,例如检测制造缺陷以及实现零售店的自助结账。尽管这些用例并非必须依赖多模态视觉模型,但 Montgomery 断言,多模态能力为这一方案增添了有价值的元素。
“Florence 是对视觉模型的彻底重新思考,”Montgomery 总结道。“一旦图像和文本之间能够实现轻松且高质量的转换,就会开启无限的可能性。客户将能够体验到显著改进的图像搜索功能,训练图像和视觉模型以及其他类型的模型(如语言和语音),从而开发出全新类型的应用程序,并轻松提升其自定义版本的质量。”