


你知道85%的AI项目无法进入生产或运营阶段吗?为什么会这样?
企业利用人工智能(AI)改善客户体验或简化工作流程已十分普遍。然而,项目成功的关键障碍往往在于将其投入开发并部署到生产环境所需的时间和资源。正如OpenAI新推出的ChatGPT所示,AI既可能带来价值,也可能引发问题。
鉴于许多项目失败或结果不准确,很可能许多公司都在犯同样的错误。以下是一些能优化你成功几率的建议。
起步要正确
AI开发过程常因规划不足、项目管理不善和工程问题而受阻。如今,大多数商业领袖通过媒体了解AI,而媒体往往将AI描述为“魔法”或只需稍加点缀就能直接投产的工具。
他们相信实施AI可以降低成本、提高利润率并增加收入。随着竞争对手纷纷行动,这引发了AI“错失恐惧症”(FOMO),高管们被推动迅速采取行动,尽管他们对创建一个成功且准确的AI项目所涉及的整体影响、计划、成本和资源缺乏清晰的理解。
由于对工程环境了解甚少,第一步通常是聘请数据科学家来梳理挑战。然而,这些数据科学家通常缺乏领域专业知识。
一名以自动化和改善业务为目标的数据科学家,通常会尝试手动收集数据以证明AI的价值。一旦完成概念验证,团队往往会在数据管理方面碰壁。该组织可能没有以“对AI友好”的方式收集、存储或管理数据。
例如,一家希望在生产装配线上嵌入智能故障检测的工厂,可以通过单摄像头演示快速展示AI项目。但为了让该项目投入生产并日常使用,必须从单摄像头过渡到数百个摄像头全天候运行。这将需要数月甚至数年的时间,才能将AI在演示中提供的价值真正落地。
当然,高管心中应明确想要解决的问题及商业案例。但AI核心团队应包括至少三种角色,它们对项目成功同样重要:数据科学家、数据工程师和领域专家。
以数据为中心的启动
在一个组织内,首个成功的AI项目不应涉及算法或复杂的模型。AI本质上是自动化知识的努力。像所有自动化工作一样,最好先从手动、缓慢且不可扩展的方式展示几个示例的价值开始。
在启动阶段,数据工程师使用数据创建若干案例,领域专家则将这些案例转化为示例。这一步骤揭示了人工智能流程的核心:业务部门拥有原始数据和目标,随后希望获得理想状态下的输出数据示例。
这一过程称为数据开发,其方法本质上是数据中心的,因为不涉及建模。与以模型为先的方法相比,这种方法具有诸多优势:
- 所需投资更少。
- 能够利用组织的优势(流程、数据、领域专业知识)。
- 速度更快。
- 风险更低。
一旦手动完成几个示例,业务部门就可以开始规划人工智能投入生产的路线图。
制定计划
上述手动阶段将在编写第一行代码之前就暴露出AI项目即将面临的许多数据挑战,这些问题可能包括:
- 数据错误。
- 数据缺失。
- 数据收集方面的挑战。
- 边缘案例和决策边界问题。
- 数据结构:输入和输出(模式)。
更重要的是,梳理这些挑战将使数据科学家能够更好地进行规划。他们将与算法开发人员一起,基于真实的数据示例而非高层描述,提供对项目所需工作量、复杂性和成本的最佳估算。
当这一流程得到正确执行时,你将能够以最小的努力制定出扎实的AI计划,因为许多挑战和需求已被提前预见。具备正确的组织流程、团队和数据源将帮助你尽快实现数据飞轮效应。
随后,公司应专注于构建包含正确组件的技术栈,以实现快速、准确且具成本效益的AI开发:包括数据管理系统、数据应用、数据管道、模型管理和人员管理。
规划数据飞轮效应
构建以数据为中心的系统意味着从第一天起就为数据飞轮效应进行规划,这是最强大的AI应用背后的基本原则。AI系统本质上是学习系统,因此企业必须预期,随着用户、客户、部署环境和用例的增加,AI系统将需要快速且经济高效地学习和适应。
规划数据飞轮效应本质上是规划一个学习系统,而不是一个仅在某个时间点正常工作的AI模型。AI表现最佳所需的大部分数据对开发团队来说是不可用的,这些数据将在生产过程中随时间流入。这造成了“鸡生蛋还是蛋生鸡”的问题:企业需要生产数据来交付功能正常的模型,但模型必须先存在才能投入生产。
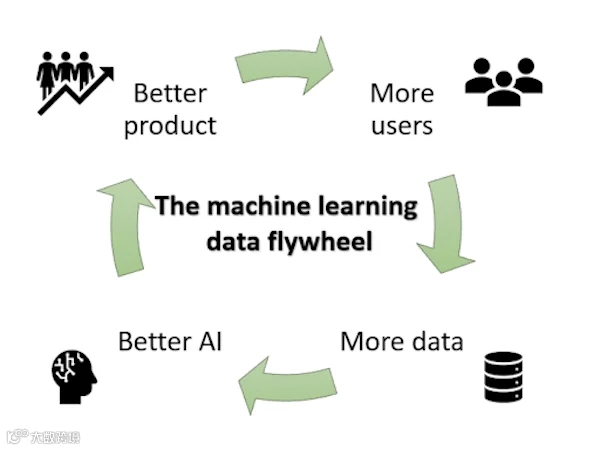
上述问题可以通过查看在实验室中正确解决的案例来解决。然而,该实验室模型在使用生产数据之前,需要经过每个部署的校准期。这使得模型输出能够快速地在生产数据上进行测试和重新训练。此过程在新部署中重复进行,从而逐步提高AI模型的速度和准确性。
数据飞轮效应本质上是一种方法论,用于迭代减少模型过拟合,并教会它如何一次正确地解决一个部署问题,同时在每次部署中学习得更快、变得更准确。
闭环需要什么?
本质上,数据飞轮效应是自动化初始团队所做的手工工作,包括收集案例、运行自动化(模型)、验证数据并将错误结果添加到下一个模型学习周期中。这被称为数据训练。
让我们将其分解为各个组成部分:
案例
企业需要定义单个案例的清晰模式:数据类型、属性、元数据、文件和预期的输出结构。由于中途更改模式的成本非常高,团队应在早期给予该领域足够的重视。
数据收集
单个数据案例包含来自许多不同来源的数据片段是非常常见的。数据收集过程本质上是一个ETL(提取、转换、加载)过程,其中每个数据案例都被收集并为处理做好准备,由领域专家或模型完成。
推理
下一步是在准备好的案例上运行模型并获得结果。
验证
这是领域专家使用适当工具手动验证案例和模型结果准确性的地方。一旦检测到错误的模型结果,该案例将被交付到训练数据集中,并包含在下一个模型学习周期中。
训练
一旦收集到足够的新样本,新的训练周期将生成一个新模型。应将训练结果与所有历史数据进行对比评估,确保模型在提升对新案例处理能力的同时,对历史案例的表现不下降。通过评估后,模型将被部署,数据闭环随之形成。
让人类与机器学习协同工作
上述流程表明,人工智能的未来并非取代人类,而是实现人与AI的持续协同。AI提供自动化、速度和低成本,而领域专家则作为协调者,在不断变化的环境中持续引导AI得出正确结果。
系统中需要人类输入,以提供实时验证,使系统能够持续学习并适应新场景。将人机回环(HITL)模型融入工作流程,可从一开始就最大限度地减少错误,从而以可靠且具成本效益的方式完成训练数据的处理。
数据标注和验证中存在的大多数错误发生在定义和本体构建阶段,而我们的模式在此阶段经常发生变化。许多公司往往跳过业务流程和数据本身的结构,直接采用AI技术,而这会对最终结果产生更大的影响。
这对您的业务意味着什么
AI有能力影响每一个行业,已在零售、农业和自动驾驶等领域发挥重要作用。企业竞相推出创新的AI解决方案,但尚未建立起将AI投入生产所需的基础能力。
从一开始就实施正确的计划,可以节省时间和资金,并为您的AI项目成功奠定基础。以数据为中心的规划从第一天就开始,确保您走在正确的AI开发路径上的最佳方式,是在启动AI项目时暂不考虑具体模型。