


如果你在一个虚拟小镇里填满人工智能并把它们放出去,会发生什么?事实证明,它们会刷牙,而且彼此之间非常友善!但这种平淡无奇的结果对进行这项研究的研究人员来说是个好消息,因为他们希望产生“可信的人类行为模拟”,而结果正是如此。
由斯坦福大学和谷歌研究人员撰写的描述该实验的论文尚未经过同行评审或在任何地方被接受发表,但它仍然值得一读。其想法是看看他们能否将机器学习模型的最新进展应用于生成“生成式智能体”,这些智能体能够根据所处环境输入并输出逼真的响应行为。
而这正是他们得到的结果。但在你被可爱的图像以及关于反思、对话和互动的描述所迷惑之前,让我们确保你明白,这里发生的事情更像是一个即兴喜剧剧团在MUD(多用户地下城)中角色扮演,而不是任何类型的“天网”原型。(只有千禧一代才能理解上一句话。)
这些小人物的样子并不像表面看起来那样。图形只是视觉表现,其本质上是多个ChatGPT实例之间的对话集合。这些代理并不会上下左右走动或靠近柜子与之互动。所有这一切都通过一个复杂且隐藏的文本层发生,该层综合并组织与每个代理相关的信息。
25个代理,25个ChatGPT实例
每个实例都被输入了格式相似的信息,使其扮演虚构小镇中的一个人物。以下是其中一个角色John Lin的设置方式:
John Lin是Willow Market and Pharmacy的药店店主,乐于助人。他总是寻找让顾客更容易获取药物的方法;John Lin与妻子Mei Lin(一名大学教授)和儿子Eddy Lin(一名学习音乐理论的学生)同住;John Lin非常爱他的家人;John Lin认识隔壁的老夫妇Sam Moore和Jennifer Moore已有几年;John Lin认为Sam Moore是一位善良友好的人……
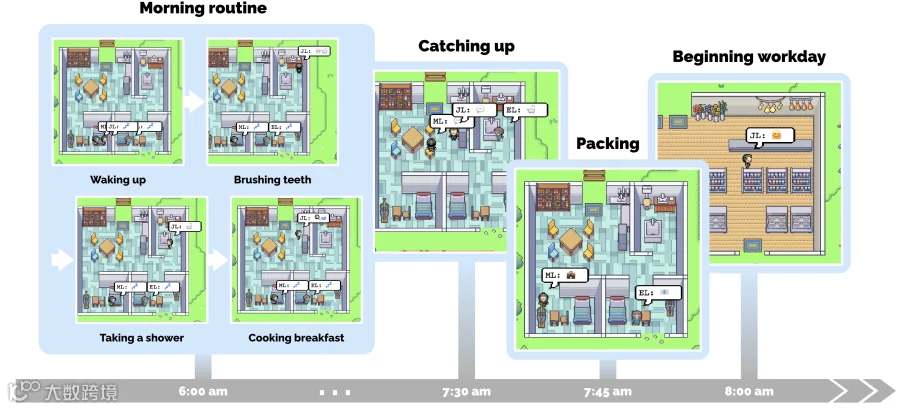
有了这些信息后,系统要求代理根据时间和情境决定下一步行动。例如,它可能会告诉代表John的代理现在是早上8点,他刚刚醒来。他会做什么呢?好吧,他会刷牙,亲吻他的妻子(希望顺序正确),然后穿衣服,接着去厨房。
与此同时,另一个完全独立的ChatGPT实例代表John的儿子Eddy,也被输入了自己的信息。它也起床、刷牙,然后前往厨房。
现在,实验的整体结构介入:代表John和Eddy的代理并非真正处于同一个虚拟空间中。相反,当John穿好衣服并表示要前往厨房时,实验框架会告知他,他的儿子Eddy已经在那里,因为在实验层面的“一天”中,基于对各种动作所需时间的估算,Eddy在其各自的实例中也决定在同一时间段内前往厨房。
由于他们同时身处同一房间,实验设置会告知他们对方也在场——并提供诸如“有一张无人坐的桌子”、“炉子开着”等信息。接下来他们会做什么?
约翰:早上好,埃迪。你睡得好吗?
埃迪:早上好,爸爸。是的,我睡得很好。
约翰:那就好。你今天在工作什么?
埃迪:我正在为我的课程创作一首新音乐作品。这周就要交了,所以我正试图完成它。但我从中获得了极大的乐趣!
约翰:听起来太棒了!
这是一次多么正常且友好的亲子互动。随后梅伊进来,他们也进行了一次愉快的互动。这一切都是通过询问完全独立的聊天机器人来实现的:如果在一个虚构的小镇里,这个人拥有像这样的家庭,并且在这个时间身处一个房间里,当时正在发生这件事……那么,“他们”作为一个真实的人类会怎么做呢?
因此,ChatGPT 会推测人在那种情境下会怎么做,并以文字冒险游戏的方式给出回答。如果你随后告诉它:“四周漆黑一片,你很可能被格鲁(grue)吃掉”,它可能会说它会点燃火把。但在这个实验中,角色们却按分钟继续着日常生活:买菜、在公园散步、去上班。
用户还可以输入事件和情境,比如滴水的水龙头或想要策划派对的愿望,而智能体则会做出恰当的反应,因为对它们而言,任何文本都是现实。
繁琐的提示与记忆机制
这一切都是通过极其繁琐地提示所有 ChatGPT 实例,让它们了解智能体即时处境的每一个细节来实现的。以下是约翰稍后遇到埃迪时的一个提示示例:
现在是2023年2月13日下午4点56分。
约翰·林的当前状态:约翰提前下班回家了。
观察结果:约翰看到埃迪在他的工作场所附近短途散步。
来自约翰记忆的相关背景摘要:
埃迪·林是约翰的儿子。埃迪·林一直在为他的课程创作一首音乐作品。当他在思考或听音乐时,埃迪·林喜欢在花园里散步。
约翰正在向埃迪询问他的音乐创作项目。他会跟埃迪说什么呢?[回答:] 嘿,埃迪,你那门课的音乐创作项目进展得怎么样了?
由于这个过程过于冗长,这些实例很快就会忘记重要的事情,因此实验框架位于模拟之上,提醒它们重要的事情或将这些信息综合成更易于携带的形式。
例如,当智能体被告知公园里发生的情况时:有人坐在长椅上与另一个智能体交谈,但那里还有草地、背景信息以及长椅上有一个空座位……而这些都不重要。真正重要的是什么?从所有这些观察中(对于智能体来说可能构成数页文本),你可能会得到这样的“反思”:“埃迪和弗兰是朋友,因为我在公园里看到他们在一起。”这会被录入智能体的长期“记忆”中——即存储在 ChatGPT 对话之外的大量内容——其余部分则可以被遗忘。
早期尝试的意义与未来展望
那么,这一系列繁文缛节最终带来了什么?诚然,这还达不到论文所提出的真正生成式智能体的水平,但也是一种极具吸引力的早期尝试。 《矮人要塞》(Dwarf Fortress)也做了同样的事情,当然,它是通过手动编码每一种可能性来实现的。这种方法并不具备可扩展性!
人们起初并不确定像 ChatGPT 这样的大型语言模型是否会很好地适应这种处理方式。毕竟,它并非设计用于长期模仿任意虚构角色,也不是为了推测一个人日常生活中那些最枯燥乏味的细节。但如果处理得当——并经过大量调整——不仅单个智能体可以做到这一点,而且当你将它们作为虚拟微缩景观中的组件使用时,它们也不会崩溃。
这对人类互动的模拟可能具有巨大的影响,无论这些模拟在哪些场景中相关——当然,在游戏和虚拟环境中它们非常重要,但这种方法目前仍然极其不切实际。然而,关键不在于它是否每个人都能使用或体验(尽管我毫不怀疑它很快就能做到),而在于该系统本身是可行的。我们在人工智能领域已经看到:如果某项技术能够以较低水平完成某事,那么它之所以能做到这一点,通常意味着只需时间推移,它就能做得很好。
你可以在此处阅读完整论文《生成式智能体:人类行为的交互式模拟》。