


如今,生成式 AI 在保真度方面令人印象深刻,正如“Balenciaga Pope”等病毒式传播的迷因所表明的那样。最新系统能够构想出从城市天际线到咖啡馆的各种场景,生成的图像乍一看惊人地逼真。
但讽刺的是,文本到图像 AI 模型长期以来的弱点之一就是文本本身。即使是最好的模型也难以生成带有清晰标志的图像,更不用说文字、书法或字体了。
但这可能会改变。
DeepFloyd IF:智能整合文本的突破
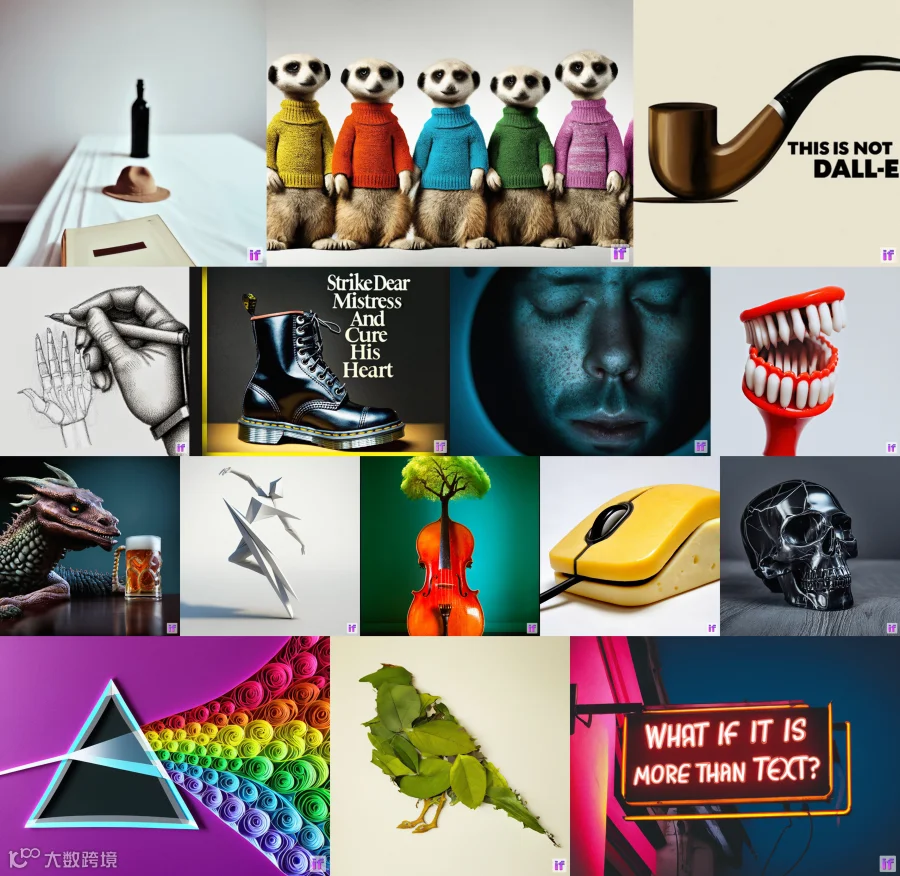
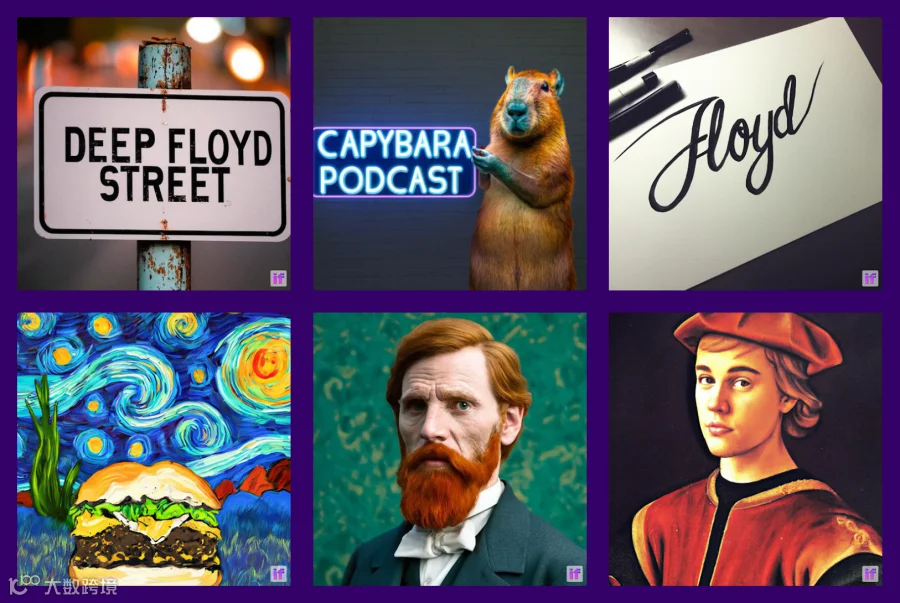
上周,由 Stability AI 支持的研究团队 DeepFloyd 发布了 DeepFloyd IF,这是一个能够将文本“智能”整合到图像中的文本到图像模型。DeepFloyd IF 在一组超过十亿张图像和文本的数据集上进行训练,运行需要至少配备 16GB 内存的 GPU,它可以根据诸如“一只穿着印有‘Deep Floyd’字样衬衫的泰迪熊”这样的提示词创建图像——并且可以选择多种风格。
DeepFloyd IF 已开源,其许可证目前禁止商业使用。这一限制可能是出于对当前生成式 AI 艺术模型法律地位尚不明确的考虑。几位商业模型供应商正受到艺术家们的抨击,这些艺术家指控供应商未经许可从网络上抓取他们的作品并从中获利,而未给予补偿。
但生成式艺术平台 NightCafe 获得了早期访问权限以使用 DeepFloyd IF。
NightCafe 首席执行官 Angus Russell 向 TechCrunch 谈到了 DeepFloyd IF 与其他文本到图像模型的不同之处,以及它为何可能代表生成式 AI 的重大进步。
模块化架构与多次扩散
据 Russell 称,DeepFloyd IF 的设计深受 Google 的 Imagen 模型启发,而该模型从未公开发布。与 OpenAI 的 DALL-E 2 和 Stable Diffusion 等模型不同,DeepFloyd IF 采用模块化架构,将多个不同的处理过程堆叠在一起以生成图像。
在典型的扩散模型中,模型学习如何从几乎完全由噪声组成的起始图像中逐步去除噪声,一步步将其拉近至目标提示词所描述的内容。DeepFloyd IF 并非只执行一次扩散,而是多次执行:先生成一张 64x64 像素的图像,然后将其上采样至 256x256 像素,最后再上采样至 1024x1024 像素。
为什么需要多次扩散步骤?Russell 解释说,DeepFloyd IF 直接处理像素。大多数扩散模型是潜在扩散模型(latent diffusion models),这意味着它们在一个低维空间中工作,该空间能表示更多的像素,但精度较低。
大语言模型赋能复杂理解
DeepFloyd IF 与 Stable Diffusion 和 DALL-E 2 等模型的另一个关键区别在于,前者使用大型语言模型将提示理解并表示为向量这一基本数据结构。由于嵌入在 DeepFloyd IF 架构中的大型语言模型规模庞大,该模型特别擅长理解复杂的提示以及提示中描述的空间关系(例如“粉色球体上方的红色立方体”)。
“它在生成图像中清晰且拼写正确的文本方面也非常出色,甚至能够理解多种语言的提示词,”Russell 补充道。“在这些能力中,能够在图像中生成清晰文本的能力可能是让 DeepFloyd IF 在众多算法中脱颖而出的一大突破。”
由于 DeepFloyd IF 能够相当熟练地在图像中生成文本,Russell 预计它将开启一波新的生成式艺术可能性——例如标志设计、网页设计、海报、广告牌甚至表情包。他表示,该模型在生成手部等细节方面也应该表现更好,而且——因为它能理解其他语言的提示词——它可能还能生成这些语言中的文本。
“NightCafe 用户对 DeepFloyd IF 充满热情,主要是因为能够在图像中生成文本解锁了诸多可能性,”Russell 说。“Stable Diffusion XL 是首个在生成文本方面取得进展的开源算法——它有时能够准确生成一两个单词有时,但在对文本至关重要的应用场景中,其表现仍不够理想。”
这并不意味着 DeepFloyd IF 是文生图模型的圣杯。Russell 指出,基础模型生成的图像在美学上不如一些扩散模型那么悦目,尽管他预计微调会改善这一点。
潜在偏见与安全挑战
但对我来说,更大的问题是,DeepFloyd IF 在多大程度上与其生成式 AI 同行一样存在缺陷。
越来越多的研究发现图像生成 AI(包括 Stable Diffusion)中存在种族、民族、性别和其他形式的刻板印象。就在本月,AI 初创公司 Hugging Face 和莱比锡大学的研究人员发布了一个工具,证明包括 Stable Diffusion 和 OpenAI 的 DALL-E 2 在内的模型往往会产生看起来像白人和男性的图像,尤其是在被要求描绘处于权威地位的人物时。
值得称赞的是,DeepFloyd 团队在其 DeepFloyd IF 附带的细则中指出了潜在的偏见问题:
使用其他语言社区和文化中的文本和图像可能未得到充分考量。这会影响模型的整体输出,因为白人和西方文化通常被设为默认值。
除此之外,DeepFloyd IF 与其他开源生成模型一样,可能被用于造成危害,例如生成色情化的名人深度伪造图像以及暴力的露骨描绘。在 DeepFloyd IF 的官方网页上,DeepFloyd 团队表示,他们使用了“自定义过滤器”来从训练数据中移除带有水印的内容、“NSFW”(不适宜工作场所观看)内容以及其他不当内容。
但目前尚不清楚具体删除了哪些内容——以及可能遗漏了多少。最终,时间会给出答案。